

苹果研究团队:AI实现图文理解与生成统一框架能力提升突破
苹果与伊利诺伊大学团队提出STARFlow2模型,基于自回归流与语言模型结构相同的洞察,采用Pretzel架构让图文生成共享同一套因果Transformer核心。通过垂直跳跃连接,模型在保持强大视觉理解能力的同时,实现了高质量的连续图像生成,并在多任务训练中提升了性能。
最近,AI领域有一项研究挺有意思。苹果公司和伊利诺伊大学厄巴纳-香槟分校的团队在arXiv上发布了一篇预印本论文(编号arXiv:2605.08029v1),提出了一个名为STARFlow2的新模型。这项研究瞄准了一个行业里长期存在的“偏科”问题。
如今,大家总希望AI助手能“文武双全”:既能看懂图片跟你聊天,又能根据描述画图,甚至还能在对话里把图文混着生成。但现实是,大多数AI系统都是“偏科生”——擅长理解的不擅长生成,擅长生成的又不擅长理解,而且这两件事背后的运作逻辑常常是割裂的。
苹果团队认为,问题的根源可能不只是模型能力不够强,而是架构上就“先天不足”。现有的所谓统一模型,往往是把文字生成和图像生成两套不同的逻辑硬拼在一起。而STARFlow2的野心,是试图从结构上解决这个矛盾,让同一套核心机制,能同时、自然地驱动文字和图像的生成。
一、为什么现有的“统一”AI其实并不统一
要明白STARFlow2的价值,得先看看现在的方案卡在了哪里。
想想我们常用的大语言模型,它生成文字就像手机输入法联想下一个词,是一个字一个字从左到右“预测”出来的。这种方式叫“因果自回归”,特点是单向、一次成型。
而图像生成的主流,比如扩散模型,工作方式完全不同。它更像是在一张充满噪点的画布上,反复“擦拭”很多次,才慢慢显露出一幅清晰的画。这是一个需要多次迭代、来回调整的过程。
所以,当研究者想把这两种能力塞进一个模型时,麻烦就来了。最常见的做法是给模型装“两个引擎”:一个管文字,一个管图像,共用身体但各干各的。这就像造了一辆前轮电动、后轮汽油的“混搭”汽车,表面上是一辆车,协调起来却非常低效。
这种拼凑带来几个具体问题:首先,生成完的图片无法直接进入模型的“记忆”(KV缓存),后续对话想引用它,得重新编码一遍,平白浪费算力。其次,训练图像生成能力时,很容易“伤及”原有的图像理解能力,顾此失彼。最后,很多方案用离散的“图像词”来表示图片,就像把高清照片压缩成低像素截图,细节损失严重。
苹果团队把目标归纳为三点:保持强大的视觉理解能力不退化、用连续方式生成高质量图像、让文字和图像的生成逻辑真正统一。而现有方案,总是难以同时满足这三点。
二、一个关键洞察:自回归流模型和语言模型其实是同一种生物
解决问题的钥匙,藏在一个精妙的观察里。
语言模型的核心是因果Transformer,它通过“从左到右单向看”的注意力机制来工作。巧的是,近年来一类叫“自回归归一化流”(TARFlow)的图像生成模型,其核心结构竟然也是因果Transformer——同样的单向遮挡,同样的缓存机制。
它们唯一的区别在于输出:语言模型输出的是“下一个词是什么”的概率,而TARFlow输出的是“如何变换当前连续数值”的参数。这意味着,如果把语言模型的“预测词头”换成“预测分布参数头”,它就能直接变成一个连续的图像生成模型,而内部骨架完全不用动。
这个发现至关重要。它说明文字生成和连续图像生成之间,并没有不可逾越的结构鸿沟,只是最终的“输出口味”不同。这就好比制作巧克力蛋糕和香草蛋糕,前期工序几乎一样,只是最后加的香料不同。既然如此,完全可以用同一套厨房、同一位师傅来完成。
STARFlow2正是基于这个洞察,让文字和图像生成共享同一套因果Transformer骨架、同一套缓存机制和生成逻辑,实现了真正的底层统一。
三、Pretzel架构:两条流水线垂直交织,像麻花一样扭在一起
STARFlow2的核心设计被称为“Pretzel架构”,灵感来源于椒盐卷饼那种两股面扭在一起的形状,形象地比喻了两条数据处理流的交织方式。
这个架构包含两条垂直交织的流水线。第一条是“VLM流”,基于一个预训练好的、能力强大的视觉语言模型(研究用的是Qwen2.5-VL-7B-Instruct),专精于理解。第二条是“TARFlow流”,是一个专门负责连续图像生成的自回归流模型。它们处理的是同一段图文交错的数据序列。
关键在于两者之间的“垂直跳跃连接”。这些连接在每一个计算位置,都将两条流水线的信息双向打通。形象地说,就像两条平行跑道之间,每隔一段就有一个换道口,让车辆可以实时交换信息。
具体来看:当TARFlow流在生成图像时,它的输入不仅包括图像数据,还会融入VLM流在同一位置输出的高层语义信息。这让图像生成的每一步,都能参考丰富的语义理解,好比画家作画时,随时有位艺术顾问在旁提供意见。
反过来,在生成文字的位置,TARFlow流会输出一个轻量的校正项,对VLM流的预测进行微调。VLM的语言能力主体保持不变,TARFlow只扮演一个提建议的“助理”角色。
为了保证预训练的理解能力不被破坏,VLM流在整个训练过程中是被“冻结”的,其参数不更新。而两条流水线间的跳跃连接权重,初始值设为零,让模型从完全独立开始,逐渐学会协作。
与另一种“混合专家”架构相比,Pretzel的优势在于“垂直交织”而非“水平分离”。它让两条流水线在每个位置都能深度互动,信息融合更加充分。实验也证实,如果采用简单的分支混合方案,要么生成质量差,要么理解能力会严重退化。
四、深浅流设计与FAE潜在空间:让图像生成既精细又高效
有了统一的骨架,还需要配套设计来提升效果。STARFlow2引入了“深浅流设计”和“FAE潜在空间”。
图像像素间存在复杂的空间关联。如果只用一套深度模型从头到尾处理,效率不高。深浅流设计把生成过程分为两步:先由几个“浅层块”负责,它们像整理乐高零件一样,通过正反向交替扫描,把图像的局部复杂结构转换成更规整的中间表示。然后,再由深层的TARFlow流结合整个对话上下文,进行全局的、跨模态的语义建模。这种分工协作,既保证了细节,又把握了整体。
另一个关键是“FAE潜在空间”。模型并不直接处理原始像素,而是先将图像压缩到一个由“特征自编码器”学到的紧凑连续向量空间。这个编码器基于强大的DINOv2视觉特征训练而成。研究发现,基于DINOv2特征的FAE,在生成质量和理解任务兼容性上都表现更好。
这个共享的潜在空间意义重大:理解任务把图像压缩进来作为输入,生成任务则把这里的向量作为输出目标。两者用同一种“语言”交流,省去了来回翻译的麻烦。更重要的是,无论是生成的图像向量还是文字向量,都能直接存入KV缓存,供后续步骤使用。这使得多轮图文交错对话变得异常流畅和高效。
五、三阶段训练:像培养一个多才多艺的演员那样循序渐进
精妙的架构需要合理的训练策略来激活。STARFlow2的训练分为三个阶段,循序渐进。
第一阶段:练基本功。 专注于让TARFlow流水线学会根据文字描述生成图像。此时VLM被冻结,只提供文本的语义表示作为“指导”。使用约8亿文本-图像对进行训练,目标是打下坚实的文生图基础。
第二阶段:学习理解。 目标是让VLM能“读懂”FAE潜在空间里的图像表示。这一阶段只训练一个轻量的“适配器”,负责将生成用的图像表示转换成VLM能理解的形式。使用约2亿图文样本进行训练,确保生成和理解能用同一种“语言”沟通。
第三阶段:协同演出。 激活两条流水线间的跳跃连接,让所有可训练组件(VLM和FAE编码器保持冻结)在多模态理解、文生图、图像编辑等混合任务上联合优化。训练从两条线独立工作开始,逐渐学会通过连接交换信息,最终达成默契配合。
整个训练在64块H100 GPU上完成,总可训练参数约36亿。
六、实验结果:用数字证明三个目标都达到了
STARFlow2在多个标准测试集上接受了检验。
在多模态理解方面,它在MME、SEED-Bench等六个主流测试集上取得了与同等规模统一模型相当的分数。需要说明的是,由于当前FAE编码器限制,模型仅在256×256分辨率下处理图像,而对比模型往往使用更高分辨率,因此理解得分存在一定先天劣势。但关键结论是:整合了图像生成能力后,模型的理解性能并未出现崩塌式下降,这验证了Pretzel架构对预训练能力的保护是有效的。
在图像生成方面,结果更令人鼓舞。在GenEval和DPG-Bench测试集上,STARFlow2的得分与专门的图像生成模型(如SD3-Medium)相比也颇具竞争力。一个关键对比是:仅完成第一阶段文生图训练时,GenEval得分只有0.51;经过第三阶段多任务联合训练后,得分跃升至0.82,提升超过60%。这强有力地说明,让模型同时学习理解和生成,不仅没拖后腿,反而借助VLM的语义理解能力,显著提升了生成质量。
七、垂直跳跃连接真的在工作吗?用数据验证设计的有效性
好的设计不能只停留在理论上。研究团队对跳跃连接的实际贡献做了定量分析。
对于图像位置的连接(VLM信息注入TARFlow),数据分析显示,VLM提供的信息在融合后的表示中贡献了约47%的幅度,且与TARFlow原始信息的方向几乎是正交的。这说明VLM注入的是全新的、互补的语义信息,而不是简单的重复或噪声。
对于文字位置的连接(TARFlow修正VLM),修正项的幅度占比均值仅为1.3%。这完全符合设计预期:文字生成的主导权仍在VLM手中,TARFlow只提供非常轻微的跨模态修正,绝不越俎代庖。
这两组数据清晰地描绘了Pretzel架构的工作状态:生成图像时,两条线深度融合;生成文字时,理解主线稳如泰山。
八、局限性与未来方向:研究者自己也看得到的不足
论文也坦诚地列出了当前模型的几个局限。
首先,三阶段训练流程虽然有效,但增加了复杂性,且可能限制组件的充分优化。未来的一个方向是探索端到端的联合训练。
其次,模型目前受限于预训练的FAE编码器,图像分辨率和细节质量(尤其是文字渲染能力)因此存在短板。更根本的解决方案可能是转向像素级或图像块级的原生视觉表示,减少对外部编码器的依赖。
最后,尽管在多个基准上取得了有竞争力的成绩,STARFlow2并未在所有测试中登顶。提升数据规模、训练稳定性、视觉表示质量,以及改善长上下文交错生成能力,都是重要的未来工作。
总而言之,STARFlow2这项研究的价值,在于它没有在旧框架里修修补补,而是回头重新思考了“统一”的根本问题。它找到了文字与连续图像生成在结构上的共性,并通过Pretzel这样的交织架构,在保护强大理解能力的同时,实现了高质量的统一生成。
这或许意味着,未来的AI助手能在同一段对话里,更自然、更连贯地切换于理解和创造之间,像聊天一样完成复杂的多模态任务。当然,通往更精细图像和更高分辨率的道路仍需探索,但STARFlow2无疑指明了一条值得深入的新路径。
Q&A
Q1:STARFlow2和普通的图文生成AI有什么本质区别?
普通统一模型常是“两套逻辑拼凑”:文字用自回归预测,图像用迭代降噪。STARFlow2的核心发现是,自回归流模型与语言模型结构相同,因此能用同一套因果Transformer机制同时驱动文字和连续图像的生成,无需降噪迭代,也无需在生成后对图像重新编码。
Q2:Pretzel架构冻结了VLM,那图像生成质量靠什么来保证?
图像质量主要由TARFlow流水线保证,并受益于VLM通过跳跃连接注入的语义信息。实验显示,VLM信息贡献了融合表示中近一半的幅度,且与TARFlow信息互补。更重要的是,加入VLM联合训练后,生成质量评测得分大幅提升,证明冻结的VLM通过语义注入,对生成有实质性帮助。
Q3:STARFlow2目前最大的短板是什么?
最明显的短板是图像分辨率和细节受限于外部FAE编码器,目前仅支持256×256分辨率,且文字渲染效果不佳。此外,多阶段训练流程复杂,可能存在优化不充分的问题。未来用原生视觉表示替代FAE,以及实现端到端训练,是主要的改进方向。
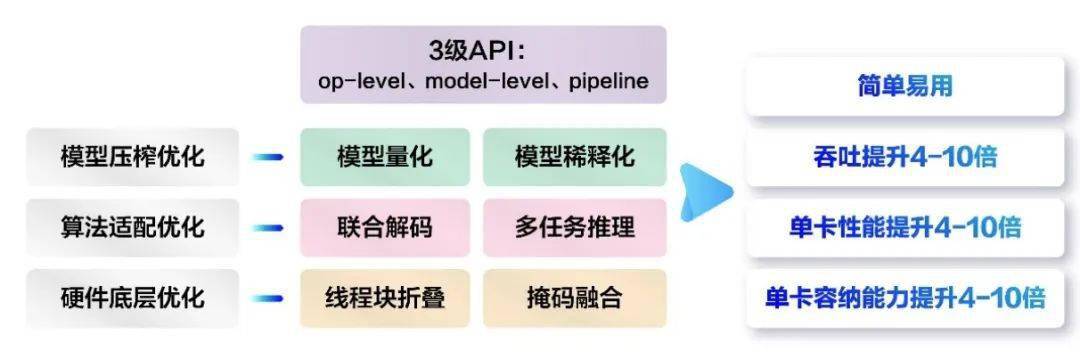
不少人都有过这样的“心动”体验:上班路上打开网易新闻,推荐内容恰好是自己最近关注的行业动态;下班途中打开网易云音乐,惊喜的发现了几个小众宝藏歌手,忍不住直呼“网易云真是太懂我了!”个性化的推荐机制像一个贴心的朋友,在互联网的海量信息中,总能捕捉到最合你心意的那个。01个性化推荐机制的背后:多模态大模型保驾护航作为国内专业从事游戏与泛娱乐AI研究和应用的顶尖机构,网易伏羲于2021年起着力打造“玉知”多模态理解大模型。基于图片-文本双塔结构,先后训练了2亿、4亿、9亿参数的“玉知”版本。同时,利用网易伏羲开
了解一加 Ace 7 与 Pro 的核心配置差异。本文详细对比两款机型的 CPU 规格、GPU 切片数量对图形性能的影响,以及主摄、超广角与长焦镜头的不同组合,结合视频中的游戏测试数据,为您提供选购参考。
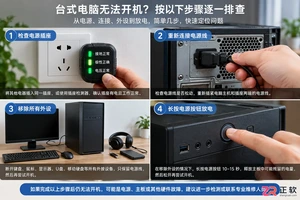
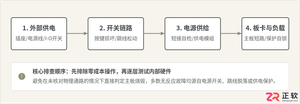
电脑按开机键没有任何反应,指示灯不亮且风扇不转?本指南教你逐步检查插座供电、重新插拔电源线、移除外设进行静电释放复位,以及判断内部电源模块故障,帮助你快速定位问题或安全送修。
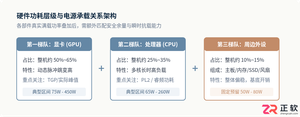
装电脑如何挑选合适功率的电源?本文详解整机各硬件功耗构成、科学的瓦数计算公式、主流配置选型案例,以及选购电源时必须注意的铭牌与规格陷阱。
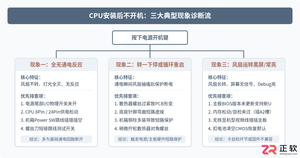
cpu安装后不开机怎么回事?本文深入分析新装或更换CPU后电脑无反应、风扇不转、主板报错灯常亮或反复重启的常见原因,并提供详细的供电排查、针脚与安装防呆核对、BIOS版本匹配、内存兼容性及最小系统法排查步骤。
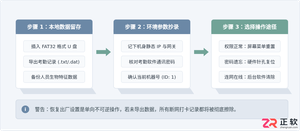
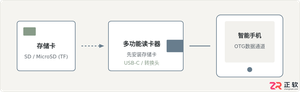
详细介绍读卡器连接手机的准备工作、硬件组装规范、安卓与iPhone系统的具体读取路径及安全拔出流程,帮助用户顺畅完成手机与内存卡之间的数据互传。
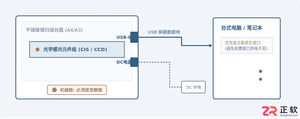
本教程针对初次使用扫描仪的新手用户,详细拆解从硬件开箱解锁、物理线路连接、官方驱动下载安装,到系统识别与首张扫描测试的完整步骤,并配有工程图解与常见问题排查方案。
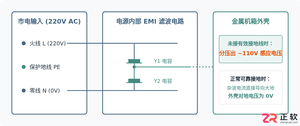
针对电脑主机能正常开机使用但机箱金属外壳发麻、漏电的问题,深入分析电磁滤波Y电容分压、接地不良、内部硬件破损短路等核心成因,并提供循序渐进的系统排查与彻底解决方法。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



