

thinkphp插件接入大模型API教程【紧跟潮流】
ThinkPHP无现成AI插件,需手写HTTP客户端服务类转发请求并解析JSON。先用curl探测API连通性,以讯飞为例构建服务类,注意字段限制。百度文心需两步令牌及缓存。OpenAI兼容接口统一替换base_uri和模型名,流式响应需逐行解析SSE。
想在ThinkPHP项目里接入通义千问、讯飞星火或者Ollama这些大模型API,但又被各种SDK搞晕、卡在鉴权和流式响应上?我先直接告诉你一个核心事实:别被“插件”这个词误导了。ThinkPHP压根就没有什么现成的AI插件可用,你能做的是写一个可复用的HTTP客户端服务类。它不跑模型,只负责精准转发请求和解析JSON回来。
确认通信链路是否通
别急着上手写代码。先打开终端,拿curl探测一下目标API的连通性,这是最保险的一步。
拿Ollama举例,本地服务就用这条命令:
curl -X GET http://127.0.0.1:11434/api/tags
如果是讯飞Lite接口:
curl -X GET https://spark-api-open.xf-yun.com/v1/chat/completions -H "Authorization: Bearer your_api_password"
如果返回了包含models数组的JSON,或者看到了401错误,都说明网络和基础认证已经就绪。但要是返回curl: (7) Failed to connect,那你就得逐一排查:Ollama是否在运行、防火墙有没有放开端口、讯飞那边复制的API密码是否一字不差——【APIPassword必须严格一致,末尾多了个空格都直接导致401】。
手写基础服务类(以讯飞Spark Lite为例)
在app/service目录下手动新建一个XingHuoService.php,按以下步骤走就行。
第一件事,声明命名空间和依赖。然后定义私有属性$baseUrl、$apiPassword和$client。接着在__construct()里面从配置中读取api_password,同时用Guzzle初始化Client——【headers里必须显式写上Content-Type和Accept为application/json,漏掉任何一个字段,都会返回400 Bad Request】。
关键一步:写chat()方法,构造$params数组。这里要特别注意,model字段必须填"lite",不能省略。content传用户输入字符串,但千万别拼接system提示词——讯飞Lite不支持role=system这个字段,传了就直接拒掉。
最后,用$client->post()发送请求,捕获可能出现的RequestException,返回json_decode后的数组,然后直接从$result['choices'][0]['message']['content']拿文本内容即可。
对接百度文心一言(需两步令牌)
方法一:手动管理access_token
新建一个BaiduWenxinService。先调/oauth/2.0/token接口,用apiKey和secretKey去换access_token。需要注意,返回的expires_in是秒数,你必须缓存这个token并在过期前刷新——【不加缓存的话,每次请求都得重新去拿token,百度那边会触发限频】。
方法二:用think-ai官方Client(仅限ThinkPHP 6.1+)
用composer安装topthink/think-ai,然后在.env里配置BAIDU_API_KEY和BAIDU_SECRET_KEY。控制器里直接调用$client = new think\ai\Client(); $client->chat()->completions(['model'=>'ernie-bot-4', 'messages'=>[['role'=>'user','content'=>'你好']]])。操作看起来简单,但必须确保.env里BAIDU_API_KEY的值没有中文引号、换行或BOM头,否则token获取会静默失败。
统一处理OpenAI兼容接口(Ollama/DeepSeek/Fireworks)
所有兼容OpenAI格式的接口,其实共用一套请求结构,你只需要替换base_uri和model名就行。
流程很简单:用Guzzle设置base_uri为https://api.deepseek.com/v1/,然后发送POST到chat/completions,请求体json里model填deepseek-r1,Authorization头填Bearer sk-xxx。注意,Ollama是个例外。它的base_uri是http://127.0.0.1:11434,接口路径是/api/chat,请求体用model和messages字段,不需要Authorization头,格式是{"model":"qwen2:1.5b","messages":[{"role":"user","content":"hi"}]}——【Ollama不校验token,但model名必须和ollama list输出的名字完全一致,qwen2:1.5b ≠ qwen2:1.5b-q4_k_m】。
流式响应这块需要单独处理。开启stream=>true后,响应体是SSE格式,每行以data:开头。你不能直接对整个响应体做json_decode,必须逐行读取、剥离data:前缀,然后再json_decode。这一点处理不当,整个接入流程都会卡住。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
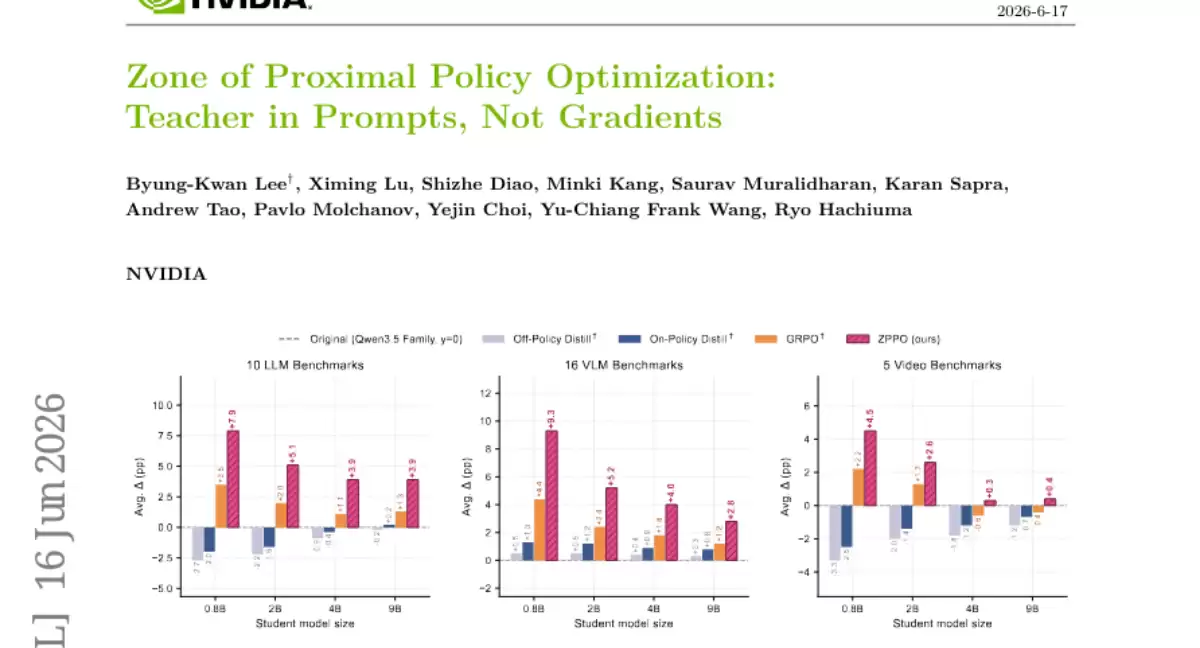
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
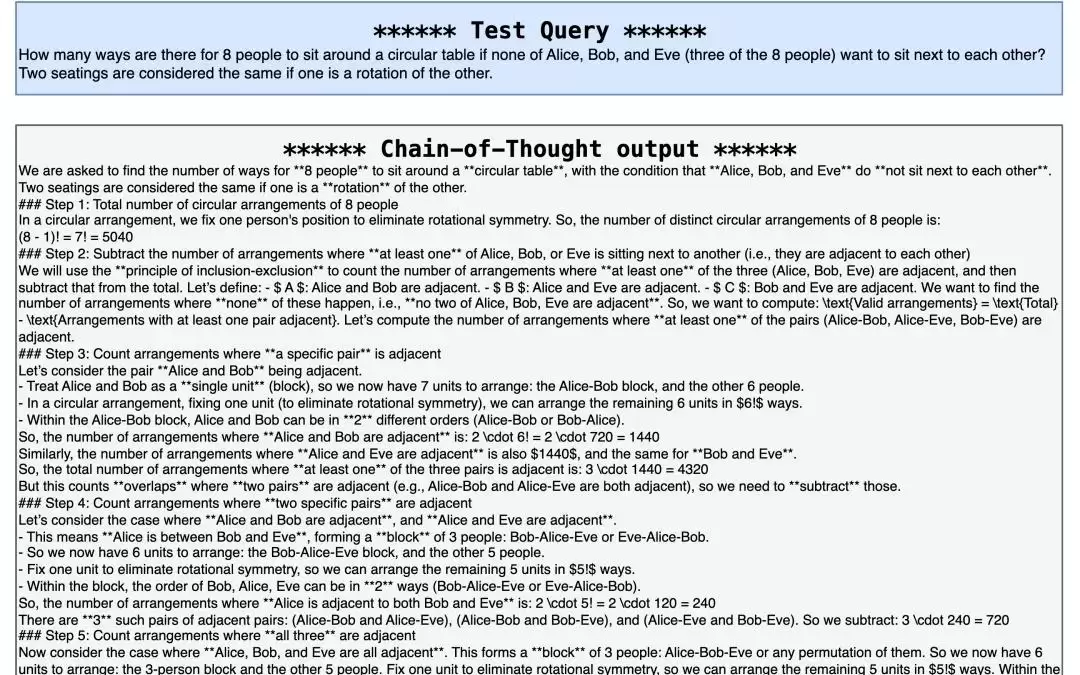
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
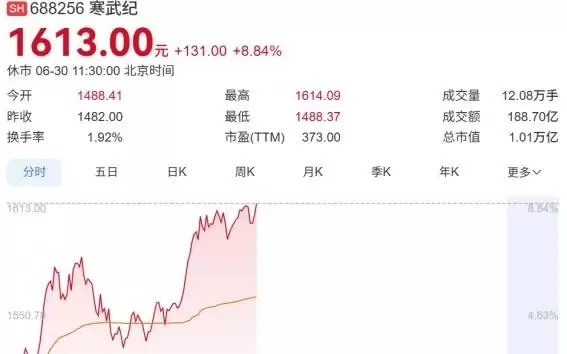
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



