

SpringAI结构化输出+大模型参数全解析(含千问调优)
SpringAI实现结构化输出,通过ChatClient的entity()或BeanOutputConverter将模型返回JSON自动转为JavaBean,保障类型安全与开发效率。大模型生成受temperature控制创造力、top_k限制候选词数量、top_p动态累积概率截断,结构化输出建议temperature≤0.5以获稳定结果。
在如今的AI开发实践中,调用大模型返回自然语言文本已经是最基础的操作了。但真正上过生产环境的人都知道,麻烦往往出现在模型“自由发挥”的那部分——你让它输出结构化数据,它可能给你带上一堆解释文字,或者格式跑偏,甚至偶尔还给你编几个字段。这时候,结构化输出就成了刚需。
一、什么是结构化输出?
1. 定义
所谓结构化输出(Structured Output),核心就一句话:让大模型不返回自由文本,而是严格按指定格式(如 JSON)输出。这样一来,程序可以直接把返回结果解析成对象,免手动字符串处理、免正则、免 JSON.parse 异常。很多框架,比如 Spring,对此有天然的生态支持。
2. 为什么要用?
好处非常直接:
- ✅ 类型安全:直接映射到 Ja va Bean,编译期就能校验字段,不至于等到运行时才发现“这个字段怎么是字符串”
- ✅ 稳定性高:模型输出固定字段,没有多余的“嗯、好的、让我想想”之类的解释
- ✅ 开发高效:想想看,从
String→ 手动解析 →try-catch这一整套流程,简直每个后端开发者的日常噩梦 - ✅ 易集成:直接对接数据库、API、前端 JSON,中间不需要再加工
3. Spring AI 两种实现方式
在 Spring AI 框架里,实现结构化输出有两条路径,背后原理相通,但使用体验差异明显。
方式 1:ChatClient 的 .entity()(最简洁,推荐)
底层封装了 BeanOutputConverter,一行代码直接返回 Bean,确实是目前最优雅的做法。
// 直接返回 Weather 对象,无需手动转换
Weather weather = chatClient.prompt("查询北京今日天气")
    .call()
    .entity(Weather.class); // 自动JSON→Bean
方式 2:BeanOutputConverter(灵活可控,适合复杂场景)
如果需求比较复杂,比如需要自定义 Schema 或者清洗规则,那手动创建转换器会更可控。
// 1. 初始化转换器 BeanOutputConverterconverter = new BeanOutputConverter<>(Weather.class); // 2. 提示词强制JSON格式(注入Schema要求) String prompt = """ 查询 %s 今日天气,仅返回JSON,不要解释。 %s """.formatted("北京", converter.getFormat()); // 3. 调用模型 + 转换 String json = chatClient.prompt(prompt).call().content(); Weather weather = converter.convert(json);
下面是一个完整的代码示例,包含了实体类定义和两种调用方式的 Controller:
package org.example.ai_demo.entity;
import lombok.Data;
@Data // Lombok:自动生成getter/setter/toString/无参构造
public class Weather {
    private String city;        // 城市
    private String temperature; // 温度
    private String weatherDesc; // 天气状况(晴/雨)
    private String wind;        // 风向风力
}
package org.example.ai_demo.controller;
import org.example.ai_demo.entity.Weather;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.converter.BeanOutputConverter;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;
@RestController
public class WeatherController {
    private final ChatClient chatClient;
    // 注入ChatClient(Spring AI自动配置)
    public WeatherController(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }
    // 方式1:.entity() 简洁版(推荐)
    @GetMapping("/weather/simple")
    public Weather getWeatherSimple(@RequestParam String city) {
        return chatClient.prompt("查询" + city + "今日天气,仅返回JSON")
                .call()
                .entity(Weather.class);
    }
    // 方式2:BeanOutputConverter 完整版
    @GetMapping("/weather/full")
    public Weather getWeatherFull(@RequestParam String city) {
        // 初始化转换器
        BeanOutputConverter converter = new BeanOutputConverter<>(Weather.class);
        // 构造提示词(强制JSON + 注入Schema)
        String prompt = String.format("""
                查询 %s 的今日天气,严格返回JSON,不要任何额外文字。
                输出格式要求:%s
                """, city, converter.getFormat());
        // 调用模型并转换
        String jsonResult = chatClient.prompt(prompt).call().content();
        return converter.convert(jsonResult);
    }
}
别忘了引入依赖:
    org.springframework.ai
    spring-ai-core
    1.0.0-M1


    org.springframework.ai
    spring-ai-alibaba-starter
    1.0.0-M1


    org.projectlombok
    lombok
    true


    org.springframework.boot
    spring-boot-starter-web
二、大模型是如何工作的?
聊结构化输出之前,先简单回顾一下大模型(比如通义千问)的生成逻辑。本质上,这是一个逐词预测、概率采样、拼接输出的循环过程:
1. 输入阶段(Prompt)
当你输入“查询北京今日天气”,模型会把文字转成一个个Token(词或字),然后输入神经网络。
2. 推理阶段(核心:概率计算)
模型开始计算下一个 Token 的概率分布。比如,看到“北京”,下一个词是“今日”的概率可能高达 90%,是“明天”的概率 8%,是“昨天”的概率 2%。这个分布决定了后续输出的走向。
3. 采样阶段(参数控制:temperature/top_p/top_k)
根据温度、top_p、top_k 这些参数,筛选出候选 Token,然后随机选一个。这一步骤直接决定了输出是严谨还是天马行空。
4. 输出阶段(循环直到结束)
选中的 Token 加入输出,同时作为新输入,重复步骤 2-3,直到遇到结束符(),最终形成完整回答。
5. 结构化输出的额外步骤
在 Prompt 中加上JSON Schema 约束,模型就会按照 Schema 来生成 JSON。Spring AI 的 BeanOutputConverter 再自动反序列化为 Ja va Bean,整个过程无缝衔接。
三、三大核心参数详解(temperature/top_p/top_k)
这部分是调参的关键,很多同学在踩坑之后才真正理解这几个参数的意义。
1. Temperature(温度:控制创造力)
- 范围:0 ≤ temperature ≤ 2(推荐 0.1–1.0)
- 作用:调整概率分布的尖锐度。简单说,低温度会让模型倾向于选择概率最高的词,输出严谨、稳定、少幻觉(适合代码、事实问答、RAG);中温度(0.4–0.7)在准确与多样之间取得平衡,适合日常对话、文案、翻译;高温度(0.8–1.2)则让概率分布更分散,输出更创意、发散、但也容易跑题,写诗、故事、头脑风暴时常用。
- 公式:
logits_after = logits / temperature→ softmax 转概率
2. Top-K(限制候选词数量)
- 范围:1 ≤ top_k ≤ 100(常用 10–50)
- 作用:只保留概率最高的 K 个 Token,其余概率直接置 0,然后从这 K 个里采样。如果 top_k=1,那就是贪心搜索,永远选概率最高的,输出固定。如果 top_k=50,保留前 50 个候选,可以平衡稳定与多样。
- 缺点:K 是固定值,没办法适配不同的概率分布。比如有时候概率分布很集中,前 10 个就占了 99%;有时候很分散,前 50 个仍然有合理的选择。固定 K 就让灵活性打了折扣。
3. Top-P(核采样:动态累积概率)
- 范围:0 ≤ top_p ≤ 1(常用 0.7–0.9)
- 作用:动态截断。算法会累积候选 Token 的概率,直到累积概率≥P,然后只从这个集合中采样。比如 top_p=0.9,就保留累积概率达到 90% 的那个候选集合,集合大小是动态的,自动适配当前的分布情况。 top_p=1.0 表示不截断,全候选采样。
- 优势:比 top_k 更灵活,优先选高概率词,同时兼顾多样性,是目前最推荐的做法。
4. 场景化参数推荐
| 场景 | Temperature | Top-P | Top-K | 说明 |
|---|---|---|---|---|
| 代码生成 / SQL | 0.2–0.4 | 0.7 | 10 | 严谨、语法正确 |
| 知识库 / RAG 问答 | 0.1–0.3 | 0.8 | 20 | 少幻觉、忠于参考 |
| 日常对话 / 文案 | 0.5–0.7 | 0.9 | 50 | 平衡准确与流畅 |
| 创意写作 / 写诗 | 0.8–1.0 | 0.95 | 80 | 发散、有想象力 |
四、总结
回顾一下,我们可以从几个关键点来理解结构化输出和参数调优:
- 结构化输出:大模型返回 JSON,Spring AI 一键转 Ja va Bean,类型安全、稳定高效。如果你还在手动解析模型返回的 JSON 字符串,这个方式值得尽快换掉。
- 两种写法:
.entity()简洁、BeanOutputConverter灵活。日常使用场景中,.entity()基本够用。 - 三大参数:temperature 控创意、top_k 控数量、top_p 控概率,场景化设置就能拿到不错的效果。
- 千问调优:对于通义千问这类模型,先通过 API 参数调优,复杂场景可以考虑 SFT 微调。但有一条原则很关键——temperature ≤ 0.5 是结构化输出获得稳定结果的保证。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
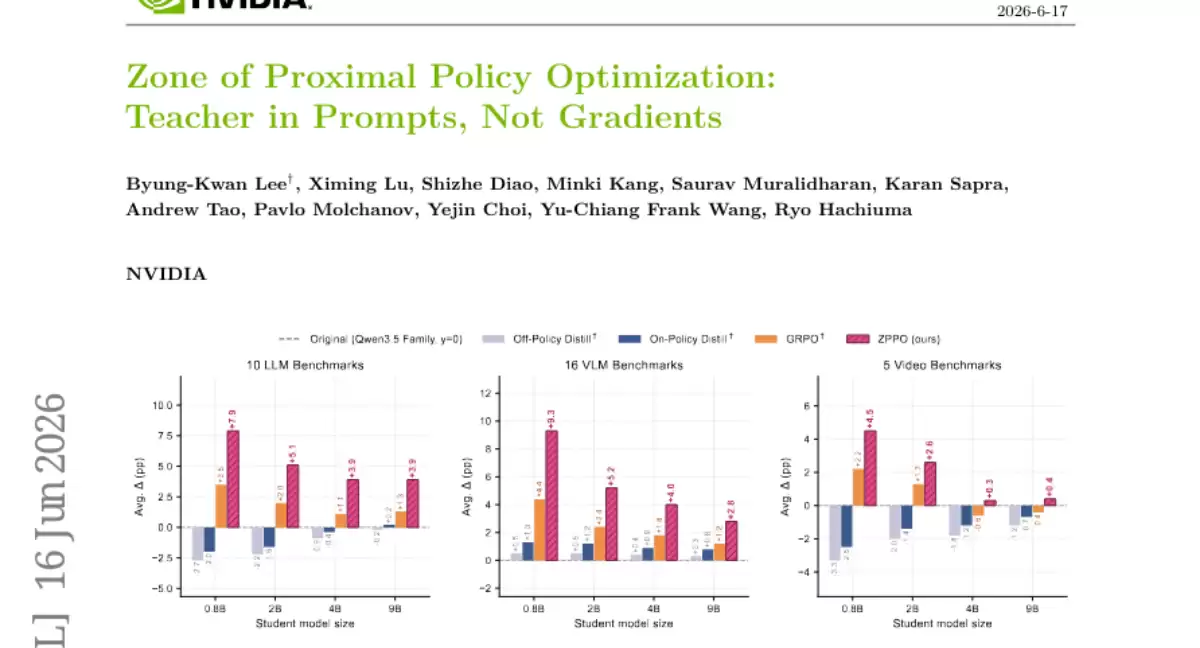
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
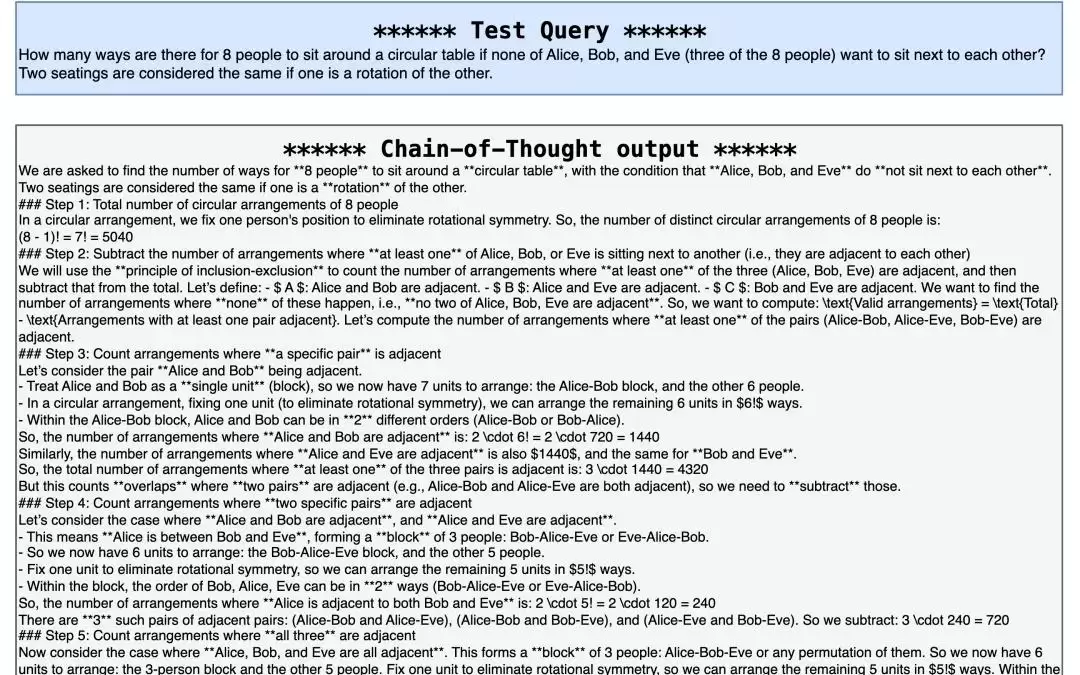
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
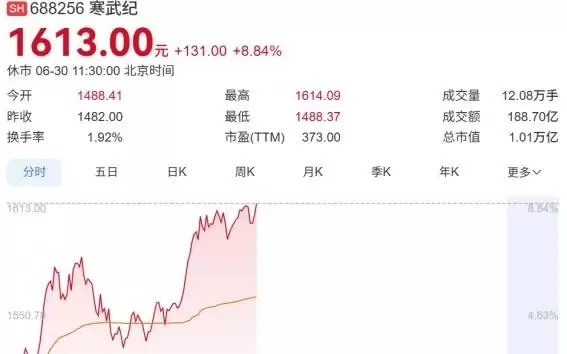
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



