

为什么在数据清洗的分支体中编写过于庞大的流操作会导致内存内耗严重
数据清洗中过度使用Stream操作会导致内存内耗严重,原因包括惰性求值引发全量物化、中间对象链加重GC负担、装箱拆箱使内存翻倍,以及分支反复遍历同一数据。传统循环仅占用恒定内存,建议采用按需供给、单次遍历和原生数组优化。
流操作(Stream)的惰性求值特性是一把双刃剑——它让你写代码时感觉像是在搭积木,每一步都很轻巧,但一旦触发终端操作,JVM就得把整个数据集拉进内存里算个底朝天。尤其是当数据源头是那种几十万行的大集合,或者直接从数据库里一把梭出来没做分页的结果集,这种“全量拉取+全量处理”的模式,对堆空间的冲击力堪比大水漫灌。
问题在于,Stream API的简洁表象往往掩盖了它在运行时制造的隐性压力。具体来说,有三层开销是很容易被忽略的:
首先是中间操作链累积的对象图。filter、map、sorted这些方法本身并不执行,但它们会不断生成新的Stream对象,而且每个对象都持有上游的引用。链子越长,对象图越复杂,GC回收的负担也就越重。你以为只是写了几行优雅的函数式代码,实际上背后已经挂起了一整串待释放的对象。
其次是终端操作几乎必然触发全量物化。比如最常见的stream.collect(Collectors.toList()),它会新建一个ArrayList,然后把所有元素从头到尾复制进去;stream.toArray()同理,得分配一个跟源数据等长的新数组。如果源数据本身就有几百万条,这一下子就能把堆空间干到高位。
再就是装箱拆箱问题。如果你对基本类型数组(比如int[])不小心用了Stream.of(arr)或者Arrays.asList(arr),整个数组会被当作单个Object来包装,或者触发Integer[]的批量装箱。内存占用轻松翻上几倍,这个坑踩过的人应该不少。
数据清洗的代码尤其容易中招,因为里面天然就带着条件分支。比如按字段类型分流、按业务规则分组,每个分支独立构造一个完整的Stream流程。于是就会出现几个典型的问题:同一批原始数据被反复遍历——先是filter分出A类,再filter分出B类,底层实际上是两次全量扫描加两次中间对象构建;分支之间还不能共享中间状态,传统for循环里边走边分类的写法,在流式方案里根本做不到;再加上lambda表达式容易捕获外部的大对象,清洗前的那张原始List或Map会被整个闭包持住,生命周期拉长,GC想回收都收不了。
好,那跟传统方式比一下?传统做法——无论是原生数组还是Iterator驱动——天然就是“边读边洗、边洗边吐”的节奏。用for (int i = 0; i < n; i++)配合double[]处理,全程只占几个局部变量的空间;用Iterator配合while (it.hasNext()),每次只加载一条记录,内存占用是恒定的。而list.parallelStream().filter(...).map(...).collect(...)这一行,可能瞬间就申请出数百万个对象、占用几个GB的堆空间,并行流还要额外创建线程池和分割任务队列,资源消耗完全不在一个量级。
说到底,不是要禁用Stream,问题在于怎么控制它的作用域和形态。对于超大数据源,可以考虑用Stream.iterate或自定义Spliterator实现按需供给,避免一次性加载;清洗逻辑尽可能下沉到record级别,用单次遍历加if-else分支完成所有转换,而不是为每类规则建一个Stream;必要的时候用try-with-resources包裹流式IO(比如Files.lines(path)),确保底层缓冲区能及时释放;基础数值运算坚持用原生数组配合IntStream.of()或DoubleStream.of(),远离List这类高开销容器。这样一来,流式写法依然能用,但不会让内存变成系统的瓶颈。
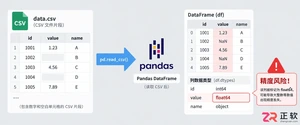
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
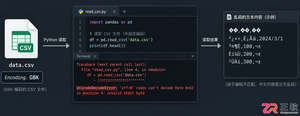
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
数据清洗中,文本格式不统一是常见难题。SUBSTITUTE函数能精准替换指定内容,适用于多种场景:可进行基础单次替换;通过参数选择替换第N次出现的字符;通过嵌套实现批量符号统一;结合CHAR函数清理不可见字符;其区分大小写的特性利于精准控制。掌握这些用法能有效解决多数文本清洗问题。
Excel透视表结果不对劲?十有八九是源数据在“捣鬼”。一套标准的“纠错六步法”送给你:先揪出错误数据,再清理那些看不见的字符,接着修复文本数字和混乱的日期格式,然后摆平缺失值和异常值,之后果断删除重复记录,最后别忘了刷新并验证你的透视表。 有没有遇到过这种情况?在Excel里埋头苦干,好不容易做出
选用 LongAdder 而非 AtomicInteger 是因高并发下其分段累加机制可避免 CAS 争抢,实测性能提升 5–8 倍;需在业务规则失败处统一调用 increment(),确保语义准确,并在任务完成后调用 sum() 获取最终值。 为什么不用 AtomicInteger 而选 Long
在数据清洗管道中实现“跳过错误记录+生成错误报告”双机制的方法是:1.在每个关键步骤使用try-except块捕获异常,确保流程不中断;2.在except块中记录错误信息至日志文件或数据库;3.通过continue或默认值跳过错误记录;4.将机制集成到所有数据转换环节;5.定期分析错误报告并优化清洗规则。对于错误报告格式,小数据量可选CSV/JSON,大数据量适合数据库表。在Spark中可通过try-except捕获异常并结合广播变量或mapPartitions方法收集错误信息。应对数据质量问题导致的数据
PHP数据清洗是将脏数据转换为干净数据的过程,脏数据包括格式不统一、缺失值、重复项、错误数据等。解决方案包括字符串处理(trim(),str_replace(),strtolower(),preg_replace())、数组操作(array_unique(),array_filter(),array_map())、类型转换(intval(),floatval(),strval())、数据验证(正则表达式或自定义函数)以及缺失值处理(isset(),empty())。针对乱码问题,需确保PHP文件、数据库和

Python调用阿里云接口,实现数据清洗功能在数据处理的过程中,数据清洗是必不可少的一环。而使用云服务提供商的API接口来实现数据清洗功能,可以提高效率和准确性。本文将介绍如何使用Python调用阿里云接口来实现数据清洗。首先,我们需要在阿里云控制台中开通阿里云API网关和数据清洗服务。开通完成后,我们可以获得相应的APIKey和APISecret,这将
Python调用阿里云接口,实现数据清洗与分析功能在当今大数据时代,数据清洗与分析是非常重要的一环。而阿里云作为国内领先的云计算服务提供商,提供了一系列强大的数据处理工具和接口。本文将介绍如何使用Python调用阿里云接口,实现数据清洗与分析的功能。首先,我们需要在阿里云上创建一个AccessKey,这个AccessKey将用于访问阿里云的API。具体操
Python调用阿里云接口,实现数据清洗与可视化分析功能概述:随着数据科学和大数据技术的发展,数据分析和可视化成为了各个行业中不可或缺的重要环节。阿里云提供了丰富的数据服务和接口,使得我们能够更加高效地进行数据清洗和可视化分析。本文将介绍如何使用Python调用阿里云的接口,实现数据清洗与可视化分析功能。一、数据清洗在进行数据分析之前,必须首先对数据进行清洗





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



