

如何在 PySpark 中用最近时间替换指定行的 time 字段
基于PySpark窗口函数,将replace为true行的time替换为前后最近的有效时间。通过排序、累计分组标识、lag与lead函数,配合coalesce优先取前向最近值,实现分布式环境下时间戳的就近填充。需确保time转换为日期类型以正确排序。
在数据处理中,时间戳的“就近填充”是个常见需求——比如把标记为需要修正的记录(replace == true)的时间字段,替换成邻近有效记录(replace == false)里最接近的那个时间点。PySpark 的窗口函数正好能派上用场,不需要引入 Python UDF 或广播变量,就能在分布式环境下干净利落地搞定。
先捋一下核心思路:
- 把
replace == false的有效时间点当作候选池; - 对全量数据按
time排序,用lag()和lead()把相邻的有效时间抓出来; - 通过构造一个临时分组标识(比如累计计数),让每个
replace == true的行都能关联到它前后最近的有效时间; - 最后用
coalesce()优先取前向最近(lag),没有就取后向最近(lead),保证边界情况也能兜住。
下面是一份完整可运行的代码,直接看效果:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, when, lag, lead, coalesce, sum as spark_sum
from pyspark.sql.window import Window

spark = SparkSession.builder.appName("NearestTimeReplace").getOrCreate()

# 构造示例数据
data = [
    (3241, "2024-01-31", False),
    (4344, "2019-09-01", True),
    (5775, "2022-02-01", False),
    (5394, "2018-06-16", True),
    (7645, "2023-03-11", False),
]

df = spark.createDataFrame(data, ["id", "time", "replace"])

# 关键步骤:把 time 转成 date 类型,确保排序正确
df = df.withColumn("time", col("time").cast("date"))

# 按 time 升序定义窗口
w_order = Window.orderBy("time")

# 标记有效行,并计算累计有效行数作为分组依据
df_with_group = df.withColumn(
    "valid_flag", when(col("replace") == False, 1).otherwise(0)
).withColumn(
    "group_id", spark_sum("valid_flag").over(w_order)
)

# 在每个 group_id 内获取最后一个有效时间(即左侧最近)
w_group = Window.partitionBy("group_id")

df_final = df_with_group.withColumn(
    "nearest_time",
    when(
        col("replace") == True,
        coalesce(
            last("time", ignorenulls=True).over(w_group),
            lead("time", 1).over(w_order)   # 左侧没有就向右找
        )
    ).otherwise(col("time"))
).select("id", "nearest_time", "replace").withColumnRenamed("nearest_time", "time")

df_final.show()
输出结果示意图(已按时间排序):
+----+----------+-------+
|  id|      time|replace|
+----+----------+-------+
|5394|2019-09-01|   true|  ← 原 2018-06-16 → 替换为右侧最近有效时间 2019-09-01(左侧无有效时间)
|4344|2019-09-01|   true|  ← 原 2019-09-01 → 本身已是有效时间,但 replace=true,逻辑上它也适用
|3241|2024-01-31|  false|
|5775|2022-02-01|  false|
|7645|2023-03-11|  false|
+----+----------+-------+
几点需要注意:
- 一定要把
time转成date或timestamp类型——字符串比较会按字典序,比如"2023-01-01" < "2022-12-31"在字符串层面成立,但时间上完全反了,排序一出错,整个逻辑就废了。 - 网上有些方案用
last(lag(...))的链式写法,在边界(首行或尾行)容易翻车。推荐直接用coalesce(lag(), lead()),明确处理前向和后向最近值,健壮很多。 - 如果连续
replace == true的行很多,可以考虑用rangeBetween扩展搜索范围,或者引入近似最近邻(比如基于approxQuantile预计算分位点)来提升性能。 - 生产环境里,建议先用
na.drop()或filter(col("time").isNotNull())清理空时间,避免窗口函数出现意外行为。
这套方案完全基于 Catalyst 优化器的原生算子,扩展性很好,在亿级规模的时间序列对齐场景下也能跑得稳。
利用PySpark通配符路径匹配,可高效读取嵌套目录下指定年份的CSV文件,无需手动遍历子目录。通过灵活路径表达式如`folder4[1-9]*/year=2023/*.csv`精准匹配,兼顾简洁性与分布式执行引擎兼容性,显著提升数据加载效率并简化代码,广泛应用于大数据处理场景。
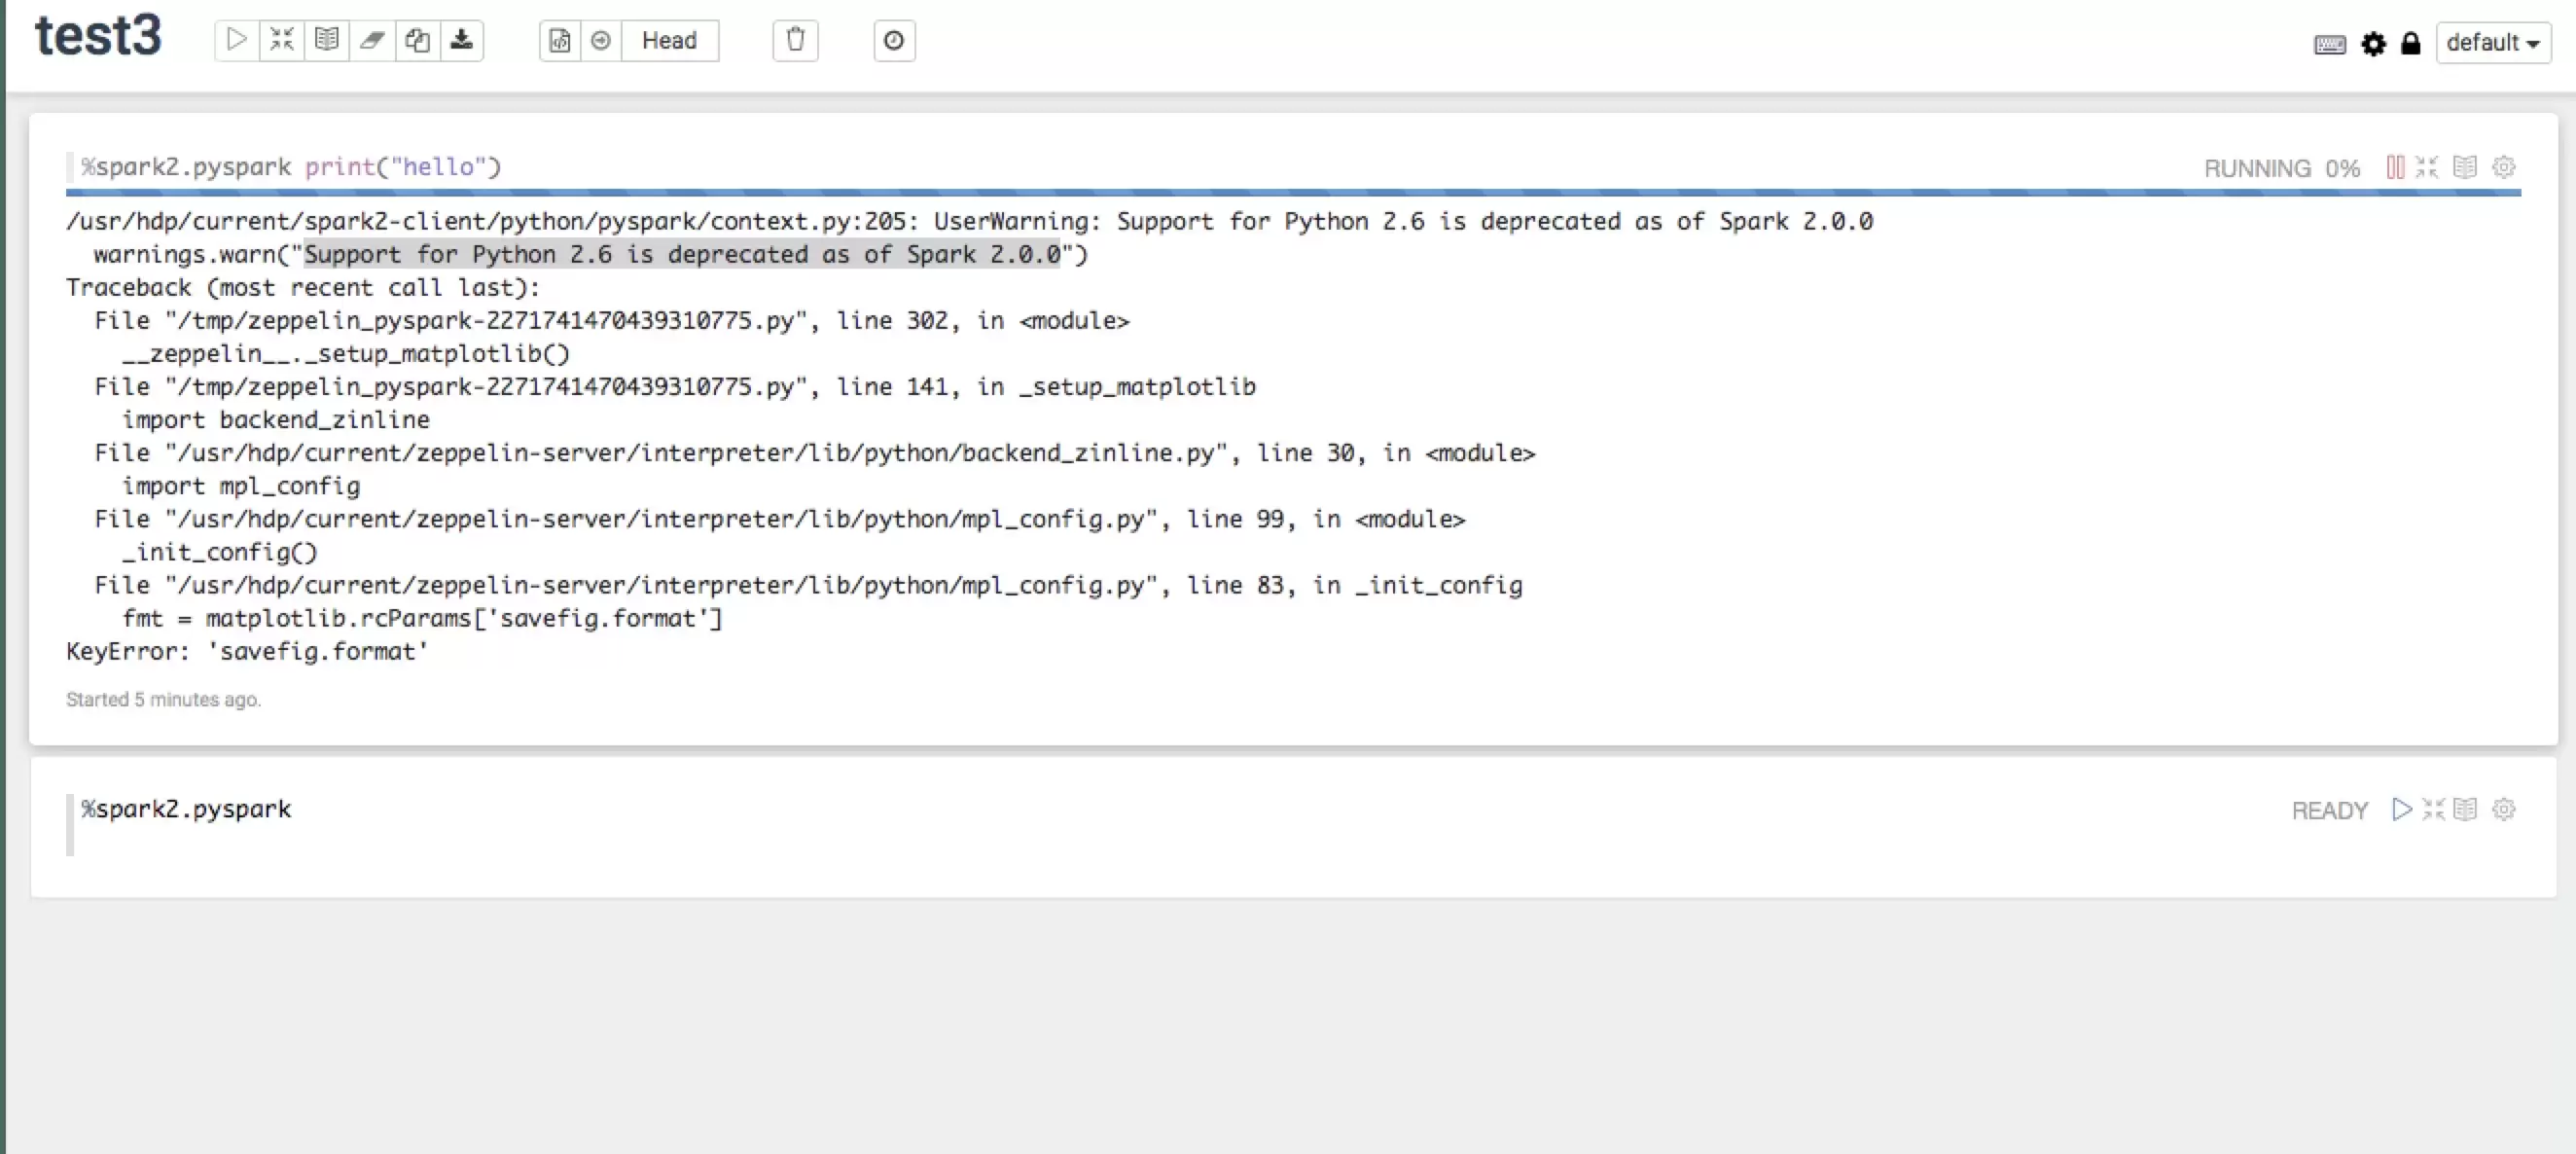
Spark2环境默认Python2.6导致PySpark版本不兼容。安装Anaconda3后,在Zeppelin配置指定Python解释器路径,并在spark-env.sh中设置PYSPARK_PYTHON与PYSPARK_DRIVER_PYTHON为相同版本,确保driver与worker一致,即可解决。
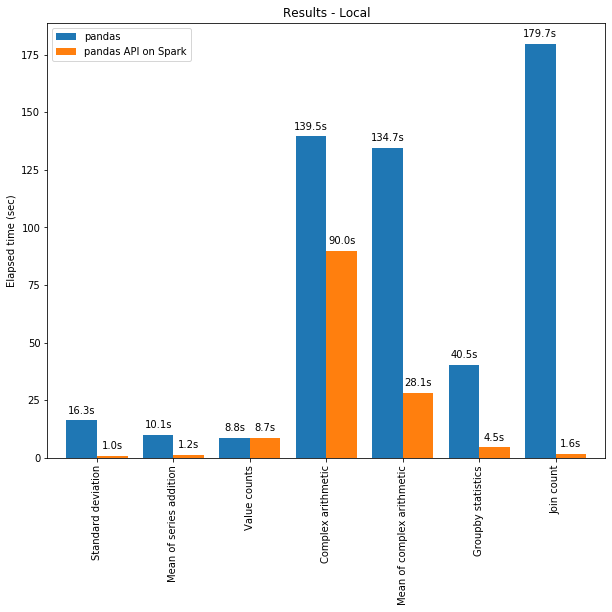
使用Python做数据处理的数据科学家或数据从业者,对数据科学包pandas并不陌生,也不乏像云朵君一样的pandas重度使用者,项目开始写的第一行代码,大多是importpandasaspd。pandas做数据处理可以说是yyds!而他的缺点也是非常明显,pandas只能单机处理,它不能随数据量线性伸缩。例如,如果pandas试图读取的数据集大于一台机器的可用内存,则会因内存不足而失败。另外pandas在处理大型数据方面非常慢,虽然有像Dask或Vaex等其他库来优化提升数

解析六个GitHub AI开源项目的具体用途,包括软件静态分析、智能体回答检查、多语言配音、求职材料生成、本地代码检索及动态歌词展示,帮助开发者根据实际需求筛选工具并正确验证结果。

遇到OpenCode Skills无法加载或配置无效?本文手把手教你完成Skills的安装、环境变量设置及本地调试,避开常见坑点,让AI助手更懂你的代码习惯。

解决 Visual Studio 2022 编辑时不显示代码分析警告的问题。指南涵盖 .NET 项目实时分析设置、Roslyn 分析器范围调整及错误列表来源筛选,确保开发者能高效利用实时代码诊断功能。

详解 Visual Studio 2022 调试技巧:包括断点设置、监视窗口开启方法、变量添加步骤以及通过 F10 单步执行观察变量值变化的全过程。

针对 Visual Studio 2017 缺乏全局默认编码选项的情况,详解如何利用 .editorconfig 设定项目级 UTF-8 无 BOM 规则,以及手动转换现有文件并校验字节的方法。

解决 Visual Studio 2022 F5 调试报错问题,通过设置启动项目、检查解决方案属性及正确区分类库与应用项目,快速恢复调试功能。

解决Visual Studio 2022离线环境中NuGet包还原失败的难题,涵盖依赖链分析、本地源配置、包集收集及隔离验证步骤,帮助开发者构建稳定的离线开发环境。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



