

Agent 结构化输出
在Agent开发中,OutputParser用于将模型返回的字符串解析为程序可处理的数据。常用方式包括JsonOutputParser、PydanticOutputParser及更便捷的with_structured_output。其中with_structured_output是优先推荐方案,但处理流式文本或非JSON格式时,可使用Parser实现更可控的
在 Agent 开发里,很多时候模型返回的结果并不是直接给人看的,而是要交给下游程序继续处理。比如提取用户资料、判断任务类型、生成工具调用参数、甚至直接返回一个可持久化的 JSON 数据。
这时候,Output Parser 就派上用场了。
一句话先记住:Output Parser 就干一件事——把模型返回的字符串,解析成程序更好处理的数据。
这篇会把几个核心概念串一遍,包括 JsonOutputParser、PydanticOutputParser,以及更便捷的 with_structured_output,还会聊聊流式输出和怎么处理 XML 这类非 JSON 格式。
JsonOutputParser
  -> PydanticOutputParser
  -> with_structured_output
  -> Parser / Tool / with_structured_output 的区别
  -> 什么时候需要 Output Parser
  -> 流式输出
  -> 非 JSON 格式
为什么需要 Parser
最直接的想法是:在 Prompt 里要求模型返回 JSON,然后自己 json.loads()。
但问题在于,模型经常不按套路出牌,比如返回这样的内容:
```json
{
  "name": "勒布朗·詹姆斯"
}
```
这对人来说一眼就能看懂,但 json.loads() 拿到带 Markdown 代码块的字符串就直接报错了。
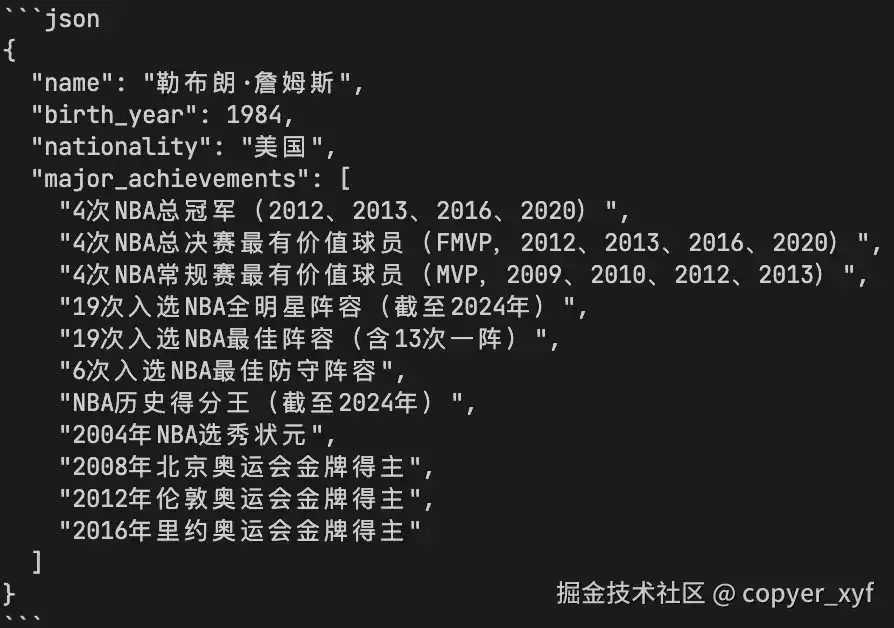
Output Parser 解决的就是这类问题:自动在 Prompt 里补充格式要求,接收模型返回的原始文本,然后把真正的对象解析出来。遇到 Markdown 包裹的 JSON 代码块时,也能更稳健地处理。
JsonOutputParser
JsonOutputParser 是最基础的结构化解析方式,适合处理普通 JSON。
from langchain_core.output_parsers import JsonOutputParser

# 1. 创建 JSON 解析器
parser = JsonOutputParser()

# 2. 把格式说明放进 prompt,让模型知道应该返回什么格式
question = f"""请介绍一下勒布朗詹姆斯的信息。
请以 JSON 格式返回,包含以下字段:
- name:姓名
- birth_year:出生年份
- nationality:国籍
- major_achievements:主要成就,数组
{parser.get_format_instructions()}"""

# 3. 调用模型,拿到原始文本
response = model.invoke(question)

# 4. 用 parser 把模型文本解析成对象
result = parser.parse(response.content)
这段代码里有三个关键点:JsonOutputParser() 创建解析器,get_format_instructions() 返回一段格式说明注入到 Prompt,parse() 则负责把模型返回的字符串解析成可用的 Python 对象。
这里真正值得留意的是 get_format_instructions()——它会在后台告诉模型尽量按可解析的 JSON 输出,减少模型自由发挥的空间。
PydanticOutputParser
JsonOutputParser 只能说“我要 JSON”,但 PydanticOutputParser 可以进一步说明“这个 JSON 长什么样”,并且直接把结果解析成 Pydantic 对象。
from langchain_core.output_parsers import PydanticOutputParser
from pydantic import BaseModel, Field

class PlayerInfo(BaseModel):
    name: str = Field(description="姓名")
    birth_year: int = Field(description="出生年份")
    nationality: str = Field(description="国籍")
    major_achievements: list[str] = Field(description="主要成就")

# 1. 根据 Pydantic 模型创建 parser
parser = PydanticOutputParser(pydantic_object=PlayerInfo)

# 2. 把格式说明放进 prompt
question = f"""请介绍一下勒布朗詹姆斯的信息。
{parser.get_format_instructions()}"""

# 3. 模型返回文本,parser 再解析成 Pydantic 对象
response = model.invoke(question)
result = parser.parse(response.content)
这时候的格式说明会比普通 JSON 详细得多,因为字段名、字段类型和字段含义都要告诉模型,模型才能精准地按结构输出。
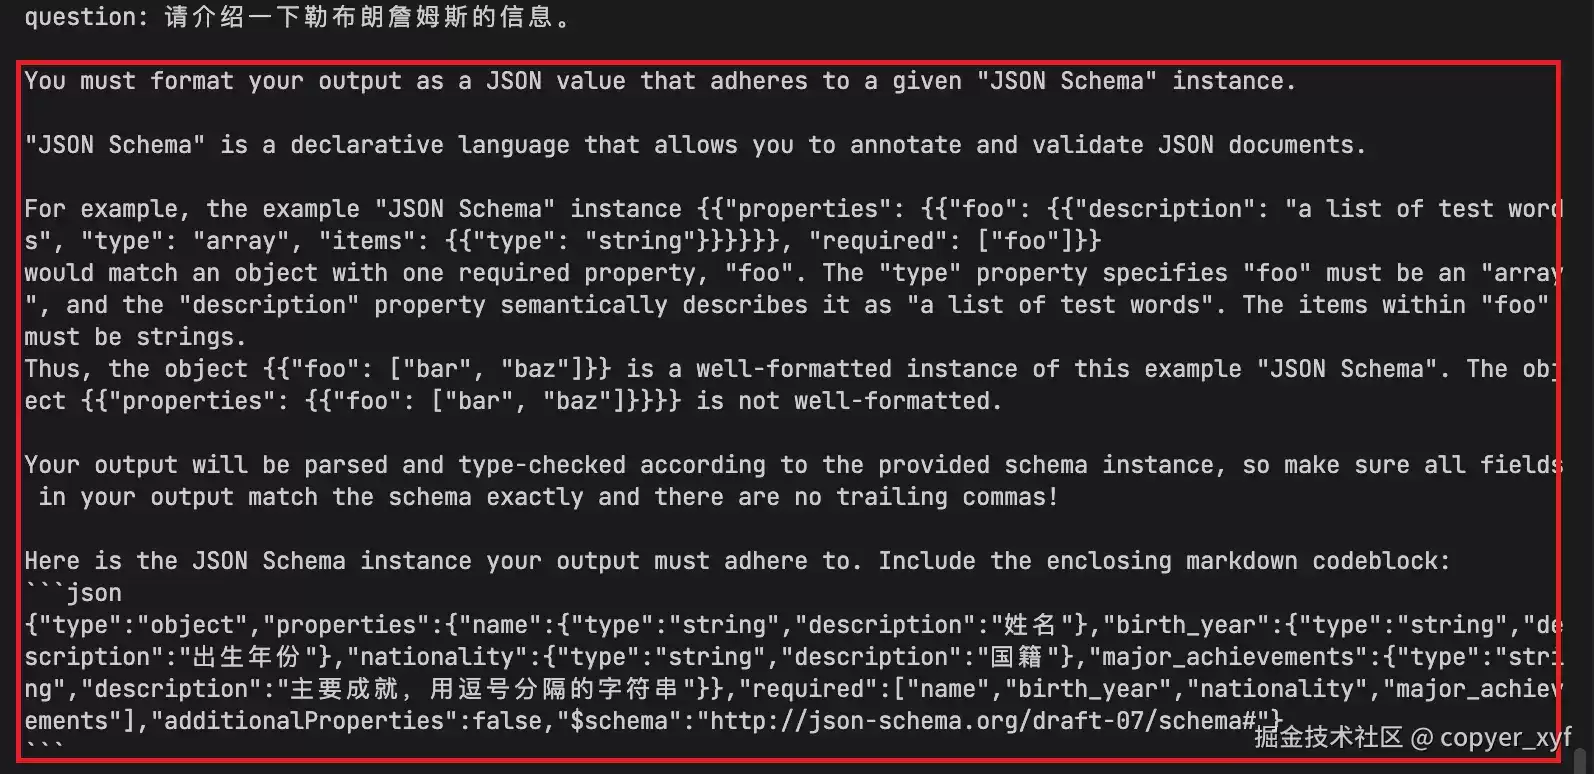
简单总结这段代码:BaseModel 负责描述结构,Field(description=...) 负责给模型提供字段说明,PydanticOutputParser 则负责生成格式说明并解析结果。
with_structured_output
在常规的结构化输出场景下,更推荐优先使用模型的 with_structured_output()。
from pydantic import BaseModel, Field

class PlayerInfo(BaseModel):
    name: str = Field(description="姓名")
    birth_year: int = Field(description="出生年份")
    nationality: str = Field(description="国籍")
    major_achievements: list[str] = Field(description="主要成就")

# 1. 让模型直接按 PlayerInfo 返回结构化对象
structured_model = model.with_structured_output(PlayerInfo)

# 2. 这里拿到的 result 已经是解析后的对象
result = structured_model.invoke("介绍一下勒布朗詹姆斯")
with_structured_output() 的好处是显而易见的:写法更短,schema 和模型调用绑定在一起,而且支持 tool calling 或 provider 原生结构化输出的模型,用它通常更稳定。
一个简单的判断原则是:
常规结构化输出:优先 with_structured_output
需要手动控制 Prompt 或解析文本:使用 Output Parser
底层大概做了什么
with_structured_output() 可以理解成 LangChain 给常见结构化输出做的一层封装。它并不是简单地调用 parser.parse(),而是把 schema 交给模型适配层,让模型尽量按结构化方式返回结果。
不同模型底层策略不完全一样,常见路线是:
支持 provider 原生结构化输出:优先交给 provider 保证格式
支持 tool calling:把 schema 转成“工具参数”形式,让模型生成 tool call 参数
不支持这些能力:才可能退回到提示词约束 + parser 解析的方式
所以它的定位很清晰:帮你把常见结构化输出封装起来,你不用太关心底层到底是 provider 原生能力、tool calling 还是 parser 解析。
它的缺点
with_structured_output() 省事,但并不是所有结构化场景都适合用它。
主要缺点有这几个:
- 它通常要等完整结构生成并解析之后,才返回一个可靠对象。
- 它不适合边生成边展示自然语言文本的场景。
- 它主要面向 JSON / schema 这类结构化对象,不适合 XML、YAML、Markdown 表格这类自定义文本格式。
简单来说:如果只是拿结构化对象,with_structured_output() 最省事;如果你需要控制生成过程或解析过程,就回到 Output Parser。
如果你还想要保留原始响应,可以使用支持 include_raw=True 的模型实现:
# include_raw=True 会同时保留原始消息和解析结果,适合调试
structured_model = model.with_structured_output(PlayerInfo, include_raw=True)
response = structured_model.invoke("介绍一下勒布朗詹姆斯")
print(response["raw"])
print(response["parsed"])
print(response["parsing_error"])
这在调试结构化输出时非常有用,因为你能同时看到模型的原始消息、解析后的对象以及解析错误。
什么时候需要 Output Parser
学 Output Parser 不是为了替代 with_structured_output()。更准确地说:Output Parser 主要用在 with_structured_output() 实现不了,或者实现起来不舒服的场景。
常见的有三类:
- 需要实时展示文本,同时最后还要拿结构化对象。
- 需要处理 XML、YAML、Markdown 表格等非标准 JSON 输出。
- 已经拿到一段模型返回的文本,后续程序还需要把它提取成 JSON / 对象。
它的价值不在“更短”,而在“更可控”:
with_structured_output:直接拿最终结构化对象
Output Parser:先让模型生成文本,再由 parser 解析文本
流式输出
先看普通流式输出。
# 普通 stream 返回的是模型原始消息流
stream = model.stream("简单介绍勒布朗詹姆斯的信息。")
full_content = ""
for chunk in stream:
    content = chunk.content or ""
    full_content += content
    print(content, end="", flush=True)
model.stream() 返回的是原始消息流,你可以边接收边展示,适合做“打字机效果”。
但如果使用 with_structured_output():
# with_structured_output 返回的是结构化模型
structured_model = model.with_structured_output(PlayerInfo)
stream = structured_model.stream("详细介绍勒布朗詹姆斯的信息。")
for chunk in stream:
    print(chunk)
你会发现看到的不是逐字文本,而是已经解析好的结构化对象。原因在于结构化输出通常要等模型生成完整参数并通过解析之后,才能给到一个可靠对象。
如果想要“边展示文本,最后再拿结构化对象”,就可以用 parser:
from langchain_core.output_parsers import PydanticOutputParser
from pydantic import BaseModel, Field

class PlayerInfo(BaseModel):
    name: str = Field(description="姓名")
    birth_year: int = Field(description="出生年份")
    nationality: str = Field(description="国籍")
    occupation: str = Field(description="职业")

# 1. 根据结构创建 parser
parser = PydanticOutputParser(pydantic_object=PlayerInfo)

# 2. 格式说明放进 prompt
prompt = f"""详细介绍勒布朗詹姆斯的信息。
{parser.get_format_instructions()}"""

# 3. 先按普通文本流接收模型输出
stream = model.stream(prompt)
full_content = ""
for chunk in stream:
    content = chunk.content or ""
    full_content += content
    print(content, end="", flush=True)

# 4. 文本收集完整后,再统一解析成结构化对象
result = parser.parse(full_content)
这个流程可以概括为:
流式展示原始文本 -> 收集完整文本 -> parser.parse() 得到结构化对象
XML 转换
Output Parser 不只处理 JSON。有些场景不是要模型直接返回 JSON 对象,而是要它先返回 XML 这类文本格式,再由解析器转成程序能处理的数据。
先用标准库写一个最小例子来理解这个流程:
import xml.etree.ElementTree as ET

# 1. 让模型按 XML 格式输出
question = """请提取以下文本中的人物信息,并返回 XML:
阿尔伯特·爱因斯坦出生于 1879 年,是一位伟大的物理学家。返回格式:

  姓名
  出生年份
  职业

"""

# 2. 模型返回 XML 文本
response = model.invoke(question)
xml_text = response.content

# 3. 标准库负责把 XML 文本解析成节点树
root = ET.fromstring(xml_text)

# 4. 再把节点树整理成程序更容易使用的 dict
result = {
    "name": root.findtext("name"),
    "birth_year": root.findtext("birth_year"),
    "occupation": root.findtext("occupation"),
}
这段代码想表达的不是要你以后都手写 XML 解析,而是 Output Parser 的核心流程:Prompt 约束模型输出 XML -> 模型返回 XML 文本 -> parser 把 XML 转成对象。在真实项目里,完全可以把 ET.fromstring() 这段解析逻辑封装成自己的 parser,让调用模型和解析结果的边界更清晰。
小结
这一篇有几个核心点值得记住:
JsonOutputParser适合解析普通 JSON。PydanticOutputParser可以描述更明确的字段结构。- Pydantic schema 能让 Python 版结构更清楚。
- 常规结构化输出优先考虑
with_structured_output()。 JsonOutputParser可以用于流式解析部分 JSON。- Output Parser 也可以处理 XML 这类非 JSON 格式。

豆包智能助手:你的跨场景AI效率伙伴 在AI工具层出不穷的今天,找到一款真正能融入日常、解决实际问题的助手并不容易。豆包智能助手通过融合前沿的自然语言处理与多模态交互技术,恰好填补了这一需求。它从学习到创作,为用户提供了一站式的跨场景智能服务,其核心价值在于显著提升我们的日常效率。 直接访问其官网

智能知识管理新范式:NotebookLM 2026深度解析 知识管理工具正迎来一场静默的革命。如果说过去的工具是在帮我们整理文件柜,那么以NotebookLM为代表的新一代平台,则致力于构建一个会思考、能互动的“第二大脑”。2026年,其全新升级的官网成为体验这场变革的前沿阵地,它究竟如何重新定义我

智能知识管理的新范式:NotebookLM全景解析 在信息爆炸的今天,传统的文档整理方式越来越显得力不从心。你猜怎么着?一个深度融合了AI与自然语言处理技术的工具,正在悄然重塑我们管理知识的方式。它便是NotebookLM——这款新一代的智能知识管理解决方案,凭借其三大核心优势,为高效的知识体系构建


卡内基梅隆大学团队构建PRAGMA框架,系统性评测大型语言模型的语用理解能力。框架涵盖预设、含义、言语行为、指代消解、语境依赖五大维度。测试显示,所有AI表现显著低于人类,尤其在讽刺和间接表达上差距明显,且模型规模与能力并非正比关系。

秘塔AI搜索引擎:智能信息检索的新范式 在信息过载的时代,精准获取知识变得前所未有的重要。秘塔AI搜索引擎网页版的出现,恰好回应了这一需求。它不只是一个搜索框的升级,而是凭借前沿技术,将信息检索体验推向了高效与精准的新高度。无论是简单的日常查询,还是复杂的专业探索,它都能深刻理解用户意图,并给出令人

探索人工智能技术前沿的窗口——deepseek官网全方位解析 在人工智能浪潮奔涌的今天,有一个平台正悄然成为连接技术与应用的重要桥梁。作为AI领域的创新力量,deepseek官网为用户打开了接触尖端技术与解决方案的便捷通道。 deepseek官网网址 想要直达这个AI技术宝库?官方入口地址就是htt

DEEPSEEK网页版入口是否已成为您获取智能服务的关键障碍? 当我们需要获取智能服务时,一个便捷的入口往往成为决定性因素。这款基于先进自然语言处理技术的AI工具,正在以其卓越的交互能力重塑着信息获取的方式。今天,我们就来详细梳理官方访问路径与特色功能,帮助您开启高效智能体验的全新可能。 DEEPS

Photoshop虽强,但门槛不低:试试这个在线平替方案 说到专业修图,Photoshop自然是标杆。但它的复杂性也让很多普通用户望而却步:安装包大、操作门槛高,处理张图片还得专门打开软件。有没有更便捷的选择?当然有。网页版PS工具的出现,就是为了解决这个痛点。今天要聊的「易可图」,就是其中一款颇具






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
