

基于JavaScript实现在线PDF压缩工具
基于JavaScript实现PDF压缩工具,核心流程为选文件、定参数、读PDF、筛选JPEG图片流、通过Canvas重编码后替换,最后生成新PDF下载。只处理JPEG资源,避免格式分支,压缩后图片变大则保留原数据,支持元数据清理以进一步减小体积。
 ## 1. 参数先归一化,避免压缩流程分支失控
工具支持两种模式:`jpeg-only` 和 `condense-lite`。前者是真正动手处理图片,后者更像是个“轻量整理员”——清理清理元数据、做点简单的结构化调整。
但无论选哪个,进入主流程之前,都得先把算法、画质、缩放比例这些参数规整清楚。为什么?因为后面的压缩代码只认规范参数,乱入非法输入就会到处出错。所以第一步要做的事情很明确:
```js
function resolveAlgorithm(algorithm) {
if (algorithm === PDF_COMPRESS_ALGORITHM_CONDENSE_LITE) {
return PDF_COMPRESS_ALGORITHM_CONDENSE_LITE;
}
return PDF_COMPRESS_ALGORITHM_JPEG_ONLY;
}
function resolveQuality(level) {
return QUALITY_MAP[level] || QUALITY_MAP.medium;
}
function resolveScale(scale) {
var value = Number(scale);
if (!Number.isFinite(value) || value <= 0 || value > 1) {
return 1;
}
return value;
}
```
把这些参数统一、标准化后,后续的压缩流程就能安心接收输入,不用再到处判断“这个值对不对”。整个代码逻辑会干净很多。
## 2. 先从PDF里筛出真正可压缩的JPEG图片流
PDF文件里塞满了各种资源:字体、矢量图、图片、注释……但不是每个资源都适合压缩。得先把那些“能动手”的对象挑出来。
实现里会遍历PDF的间接对象,只保留同时满足这几个条件的:
- 类型是 `XObject`
- 子类型是 `Image`
- 过滤器里包含 `DCTDecode`
这三条组合在一起,基本就是在说:这是一张JPEG图片。只有它,才值得我们去重新编码。
```js
function listJpegStreams(pdfDoc) {
var imageStreams = [];
var entries = pdfDoc.context.enumerateIndirectObjects();
for (var i = 0; i < entries.length; i += 1) {
var obj = entries[i][1];
if (!(obj instanceof PDFRawStream)) continue;
var dict = obj.dict;
var type = dict.get(PDFName.of("Type"));
var subtype = dict.get(PDFName.of("Subtype"));
var filter = dict.get(PDFName.of("Filter"));
var filterText = filter ? String(filter.toString()) : "";
if (String(type || "") !== "/XObject") continue;
if (String(subtype || "") !== "/Image") continue;
if (filterText.indexOf("DCTDecode") === -1) continue;
imageStreams.push({ obj: obj });
}
return imageStreams;
}
```
这里的关键点是只处理JPEG流。这样可以避开大量复杂的格式分支,压缩行为也更可控,不会出现“明明压缩了,文件反而变大”这种尴尬情况。
## 3. 图片重压缩的核心是“转成位图再重新编码”
拿到JPEG字节之后,不是直接去改二进制编码。这条路走不通,因为JPEG的解码过程太复杂了,直接操作码流容易出错,而且很难在浏览器环境下做到全场景兼容。
更聪明的做法是走浏览器标准图像链路:`Blob → ObjectURL → Image → Canvas → toBlob`。说人话就是——先把原始字节包装成Blob,转成ObjectURL,让Image对象去加载,然后画到Canvas上,最后用toBlob重新编码成JPEG。
```js
function recompressJpegBytes(bytes, scale, quality) {
return new Promise(function (resolve) {
var blob = new Blob([bytes], { type: "image/jpeg" });
var objectUrl = URL.createObjectURL(blob);
var image = new Image();
image.onload = function () {
var width = Math.max(1, Math.floor(image.width * scale));
var height = Math.max(1, Math.floor(image.height * scale));
var canvas = document.createElement("canvas");
var context = canvas.getContext("2d");
canvas.width = width;
canvas.height = height;
context.fillStyle = "#FFFFFF";
context.fillRect(0, 0, width, height);
context.drawImage(image, 0, 0, width, height);
canvas.toBlob(function (nextBlob) {
URL.revokeObjectURL(objectUrl);
if (!nextBlob) return resolve(null);
nextBlob.arrayBuffer().then(function (buffer) {
resolve({
buffer: new Uint8Array(buffer),
width: width,
height: height,
});
});
}, "image/jpeg", quality);
};
image.src = objectUrl;
});
}
```
这一步直接决定了压缩效果:
- `quality` 控制JPEG输出质量,值越低压缩率越高,但画质也会变差
- `scale` 控制像素尺寸缩放,缩小分辨率能直接减少文件体积
- `fillRect + drawImage` 保证重新绘制后的图像能稳定导出,不会出现奇怪的渲染残留
## 4. 主流程按“读文件、扫图片、替换流、保存结果”推进
真正的入口函数是 `compressPdfFile`。它会先读取文件,再用 `pdf-lib` 加载PDF,然后根据模式决定是否遍历JPEG图片流。
```js
var originalBytes = await file.arrayBuffer();
var pdfDoc = await PDFDocument.load(originalBytes, {
updateMetadata: false,
});
var jpegStreams = listJpegStreams(pdfDoc);
for (var i = 0; i < jpegStreams.length; i += 1) {
var stream = jpegStreams[i].obj;
var streamBytes = stream.contents;
var converted = await recompressJpegBytes(streamBytes, scale, quality);
if (
converted &&
converted.buffer &&
converted.buffer.byteLength < streamBytes.byteLength
) {
stream.contents = converted.buffer;
if (scale !== 1) {
stream.dict.set(PDFName.of("Width"), pdfDoc.context.obj(converted.width));
stream.dict.set(PDFName.of("Height"), pdfDoc.context.obj(converted.height));
}
}
}
```
这里有个很重要的判断:只有新图片字节更小,才会替换原始流。这样就不会因为重复编码反而把文件变大。如果压缩后的图片反而变大,就保留原始数据。
## 5. 元数据清理是另一条独立压缩支线
除了图片重编码,工具还支持移除元数据。这部分独立于图片处理,是另一条好用的压缩路径。
实现上会删除文档信息字典和目录上的 `Metadata`:
```js
function stripPdfMetadata(pdfDoc) {
var context = pdfDoc.context;
var catalog = pdfDoc.catalog;
var infoRef = context.trailerInfo.Info;
if (infoRef) {
context.delete(infoRef);
context.trailerInfo.Info = undefined;
}
if (catalog && catalog.has(PDFName.of("Metadata"))) {
catalog.delete(PDFName.of("Metadata"));
}
}
```
这条路径不依赖图片内容,所以有时候PDF里连一张可处理的JPEG都没有,但依然可能通过清理元数据,让文件体积变小5%到10%。
## 6. 进度、取消和结果信息都在同一条状态链上
页面层不是简单地调用一次压缩函数就完事了。压缩过程被拆成了几个可感知的阶段:读取、解析、扫描图片、重编码、清理元数据、保存完成。
每个阶段都会触发更新,用户看到了进度条的变化,知道当前处于哪个阶段,心里有数。
```js
var result = await compressPdfFile(
this.selectedFile,
{
algorithm: this.algorithm,
quality: this.qualityLevel,
scale: this.scaleValue,
removeMetadata: this.removeMetadata,
cancelToken: this.cancelToken,
},
function (progress) {
self.progressPercent = Math.max(0, Math.min(100, progress.percent || 0));
self.progressStage = String(progress.stage || "");
self.progressTotal = Number(progress.total) || 0;
self.progressProcessed = Number(progress.processed) || 0;
self.progressReplacedCount = Number(progress.replacedCount) || 0;
},
);
```
取消机制也设计得很干脆——本质上是一个共享的布尔标记。每个关键节点检查一次,用户一点取消,任务就会在下一次异步边界停下。
```js
export function createPdfCompressCancelToken() {
return { cancelled: false };
}
function throwIfCancelled(cancelToken) {
if (cancelToken && cancelToken.cancelled) {
throw createPdfCompressCancelledError();
}
}
```
## 7. 导出结果时顺手补齐“用户可理解”的信息
压缩完成之后,工具不会只丢给你一个Blob。它会列出压缩前后的体积对比、替换了多少张图片、压缩比例,以及处理时用了什么算法。页面拿到这些信息,直接生成下载链接就行了。
```js
var result = {
outputBlob: outputBlob,
outputName: buildCompressedPdfName(file && file.name),
jpegCount: jpegCount,
replacedCount: replacedCount,
metadataRemoved: metadataRemoved,
originalSize: Number(file && file.size) || 0,
outputSize: outputBlob.size,
ratio: getPdfCompressionRatio(file && file.size, outputBlob.size),
algorithm: algorithm,
};
```
这套PDF压缩功能的核心其实不复杂,核心是把浏览器图像能力和 `pdf-lib` 的对象操作串起来:先定位PDF内可处理的JPEG资源,再重编码、替换、保存,最后把整个过程包装成普通用户可直接使用的工具。代码量不大,但路径清晰,效果也足够稳定。
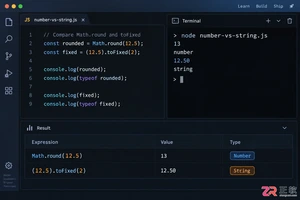
深入解析JavaScript中Math.round与toFixed的核心差异:前者返回数字,后者返回字符串。揭示IEEE 754浮点数导致的1.005舍入错误,提供前端显示与后端结算的最佳实践方案,包括使用分为单位整数和decimal.js库。
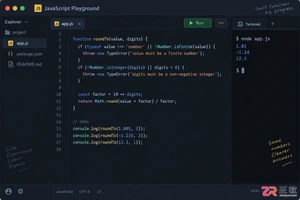
解决JavaScript中1.005四舍五入为1.00而非1.01的精度问题。深入分析IEEE 754双精度浮点数表示误差,提供健壮的roundTo函数实现,涵盖NaN、Infinity及负数处理。对比toFixed与自定义方案,明确显示与结算的场景边界,附带边界用例验证表。
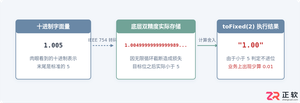
深入解析JavaScript中toFixed方法四舍五入不准确的根本原因,提供基于指数表示法与数字偏移的安全修正方案,并配有直观架构图与对比示例。
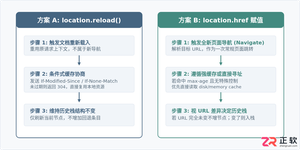
详解JavaScript中location.reload()和location.href刷新页面的机制差异。对比两者在HTTP缓存验证、POST请求重复提交警告、浏览器历史记录栈行为上的不同,并提供绕过强缓存、处理Hash变化及避免死循环的实战代码示例。

深入浅出解析TypeScript是什么语言。本文详细介绍TypeScript的语言定义、超集架构、核心运行原理、与JavaScript的核心对比以及四类典型工业级应用场景,帮助读者全面看懂TS的价值与用途。
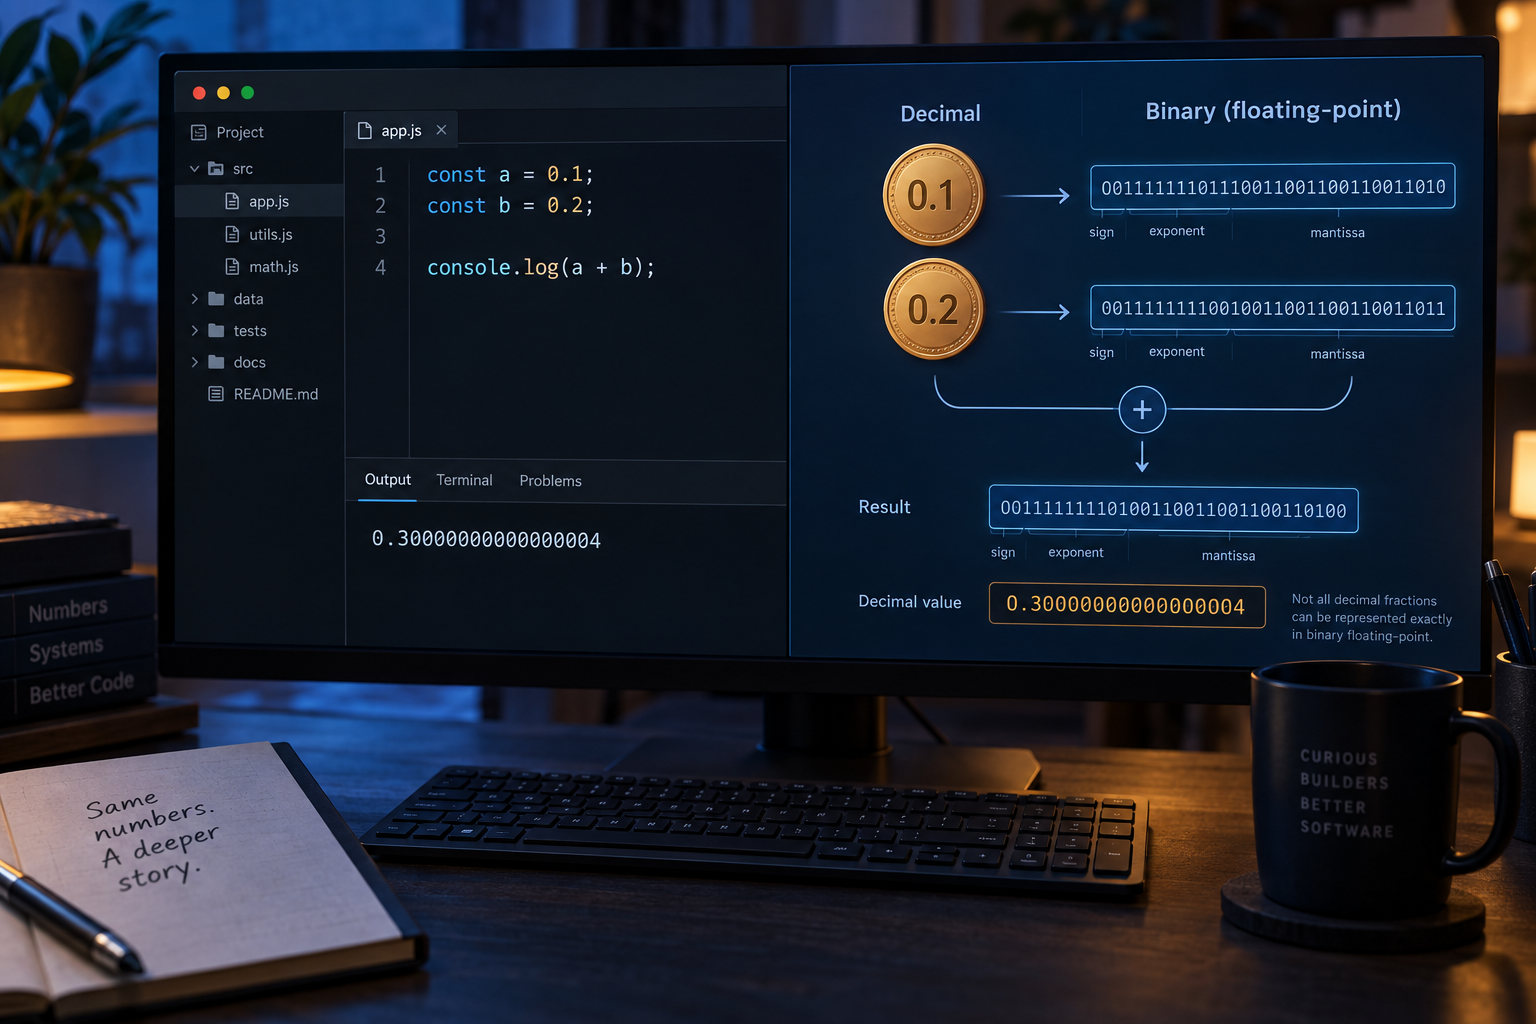
解决JavaScript中0.1+0.2!=0.3的精度问题。深入解析IEEE 754浮点数机制,对比展示用toFixed与结算用整数分计算的适用场景,提供decimal.js库的正确用法与验证方法,帮助开发者在电商与金融场景中实现精确的金额处理。
详解如何使用原生 JavaScript 和 FormData 对象实现前端文件上传,涵盖单文件、多文件提交及进度监听,无需依赖重型库,提升代码可控性。
vivo浏览器因系统级冻结WebView内核,版本锁定在89.0.4389.105及以下,不支持可选链、逻辑赋值等ES2022+新语法。可通过chrome://version确认内核版本。临时方案:使用Babel转译代码,或改用KiwiBrowser、CometAI浏览器(自带Polyfill注入)。
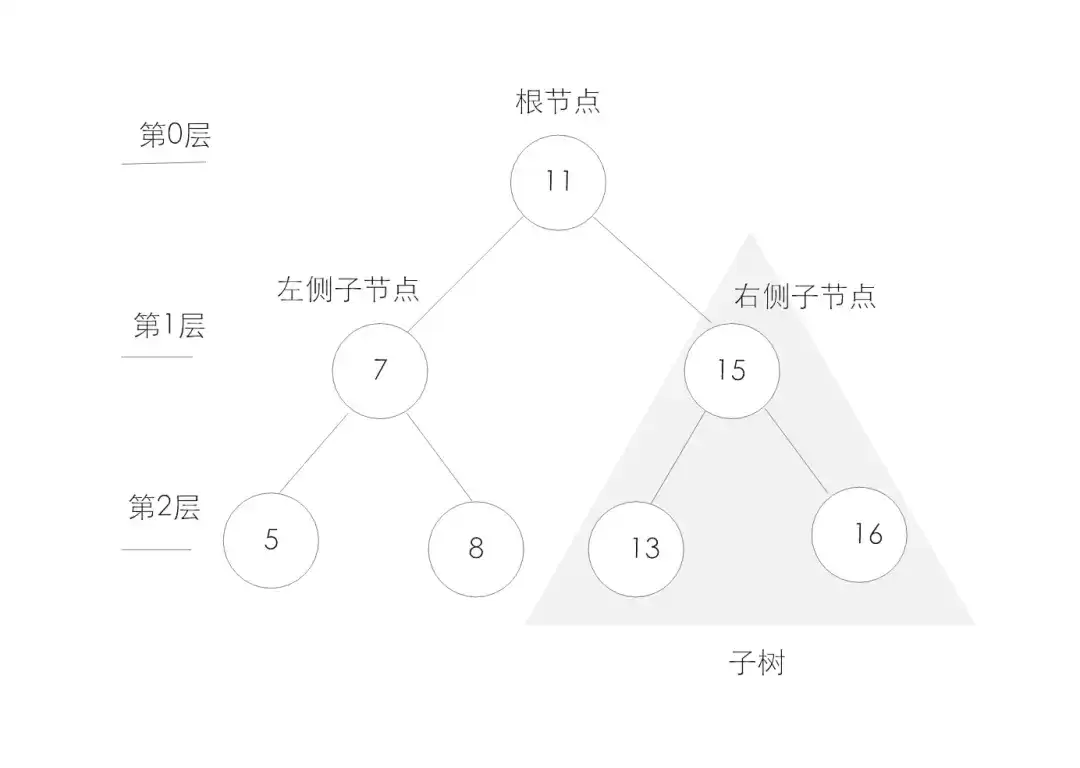
圣诞快乐接下来,咱们一起深入探讨一下js数据结构中的树。其实呀,这里的树和现实生活中的树很相似,都有树干、树枝。而在程序里,树可是一种非常重要的数据结构哦,对于存储那些需要快速查找的数据来说,它简直太有用啦!它是一种分层数据的抽象模型。一个树结构包含了一系列具有父子关系的节点。每个节点都有一个父节点





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



