

Python在Ubuntu上如何进行自然语言处理
在Ubuntu上搭建NLP环境需先确认或安装Python及pip,接着用pip安装NLTK和spaCy并下载英文模型(如en_core_web_sm),再编写代码实现分词与词性标注,运行后即可验证环境是否正确。
在Ubuntu上搭建NLP环境,其实比想象中简单。从零开始到跑通第一个分词程序,通常只需要几步配置,顺手就能把环境装好。下面直接进入正题。
1. 确认或安装Python
Ubuntu系统大多预装了Python。先打开终端,输入python --version或python3 --version看看版本。如果没装或者版本太老,直接用下面命令装Python 3:
sudo apt update
sudo apt install python3
2. 装上pip包管理工具
大部分现代Ubuntu已经自带pip,敲pip --version或pip3 --version确认一下。如果缺了,执行:
sudo apt install python3-pip3. 安装核心NLP库
NLTK和spaCy是入门NLP的两大利器。直接用pip装:
pip3 install nltk
pip3 install spacy
装完spaCy后记得下载英文小模型(其他语言同理):
python3 -m spacy download en_core_web_sm4. 按需加装其他依赖
如果后续要做主题建模或文档相似度分析,可以一并装上gensim;要跑机器学习任务,scikit-learn也值得安装。这些都是NLP的“老搭档”,一步到位能省很多麻烦。
5. 编写第一段NLP代码
新建一个Python文件,比如nlp_demo.py,敲入下面这段示例。它完成了分词和词性标注,几分钟就能看到效果:
import nltk
from nltk.tokenize import word_tokenize
from nltk.tag import pos_tag

# 下载NLTK数据包(如果尚未下载)
nltk.download('punkt')
nltk.download('a veraged_perceptron_tagger')

# 示例文本
text = "Natural language processing with Python is great!"

# 分词
tokens = word_tokenize(text)

# 词性标注
tagged = pos_tag(tokens)
print(tagged)
6. 运行并验证结果
终端里执行:
python3 nlp_demo.py如果输出了类似[('Natural', 'JJ'), ('language', 'NN')...]的结果,说明环境跑通了。
7. 持续学习与实践
NLP涉及的技术栈很广——从简单的文本预处理到深度学习模型,都需要大量实践。建议结合经典教程、开源项目或竞赛数据集,一边动手一边积累。以上步骤提供了一个基础环境框架,具体项目里需要什么库,随时pip安装就行,灵活得很。

深入解析C++中动态数组的初始化机制,涵盖new操作符的不同用法、基本类型与类对象的初始化差异,以及为何在现代C++开发中应优先使用std::vector。
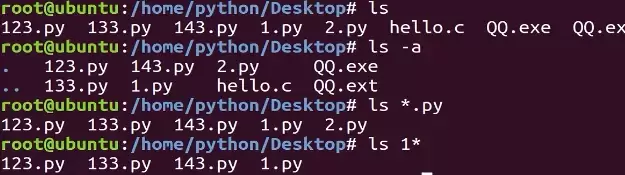
本教程指导Ubuntu新手打开终端,通过pwd、ls、cd、mkdir和touch命令完成基础文件目录操作。适用于桌面版、虚拟机及WSL环境,提供从查看路径到创建测试文件的完整验证步骤,帮助读者建立命令行操作的安全意识与正确习惯。
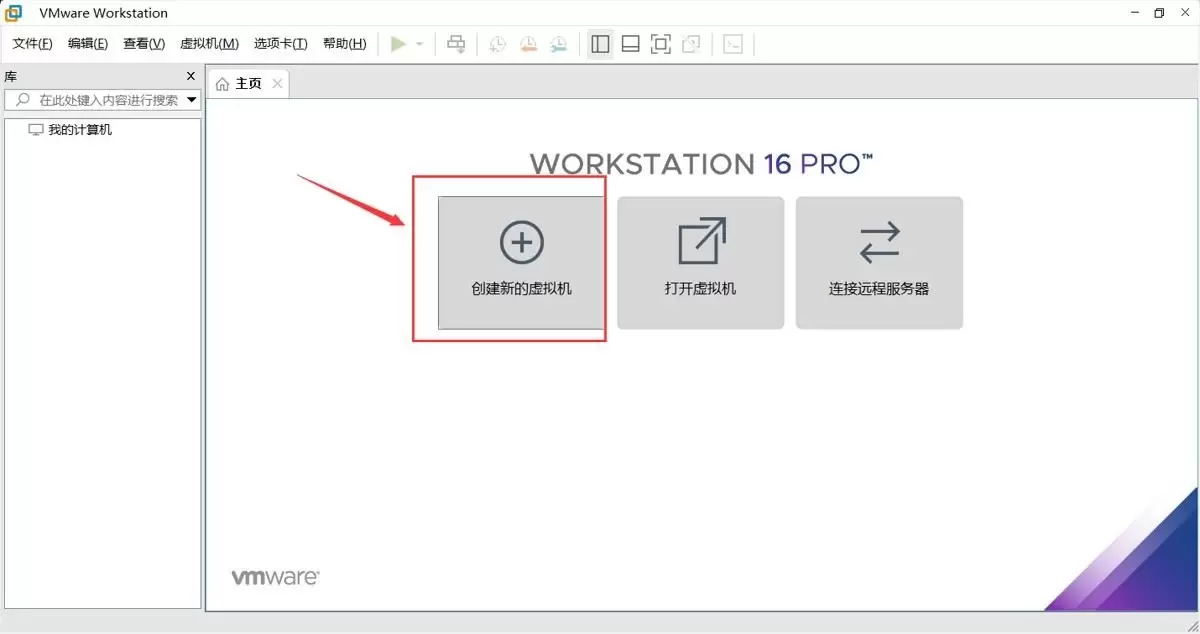
本文提供在VMware中安装Ubuntu并验证启动的完整流程。适用于首次练习Linux或搭建开发环境的用户。按步骤完成虚拟机创建、ISO挂载、硬件分配与安装后,可通过终端命令确认版本、内核与网络状态,确保系统可正常使用。
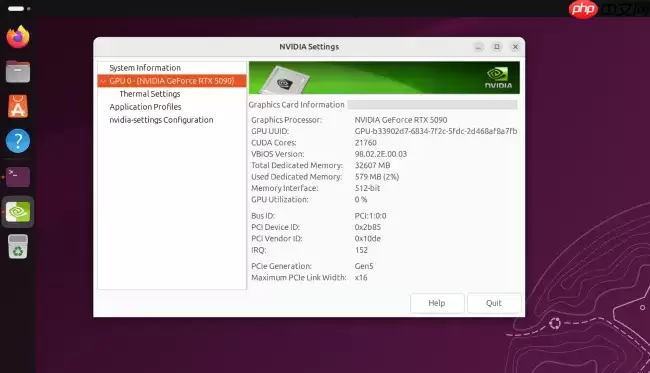
Ubuntu26.04LTS针对英伟达显卡在Wayland+GNOME环境进行性能调优,通过修改gbm_surface_lock_front_buffer函数,将帧渲染等待时间从毫秒级降至微秒级,显著提升UI响应和画面流畅度。该补丁已作为发行版专属补丁集成,确保LTS用户无需等待上游整合即可获得优化体验。
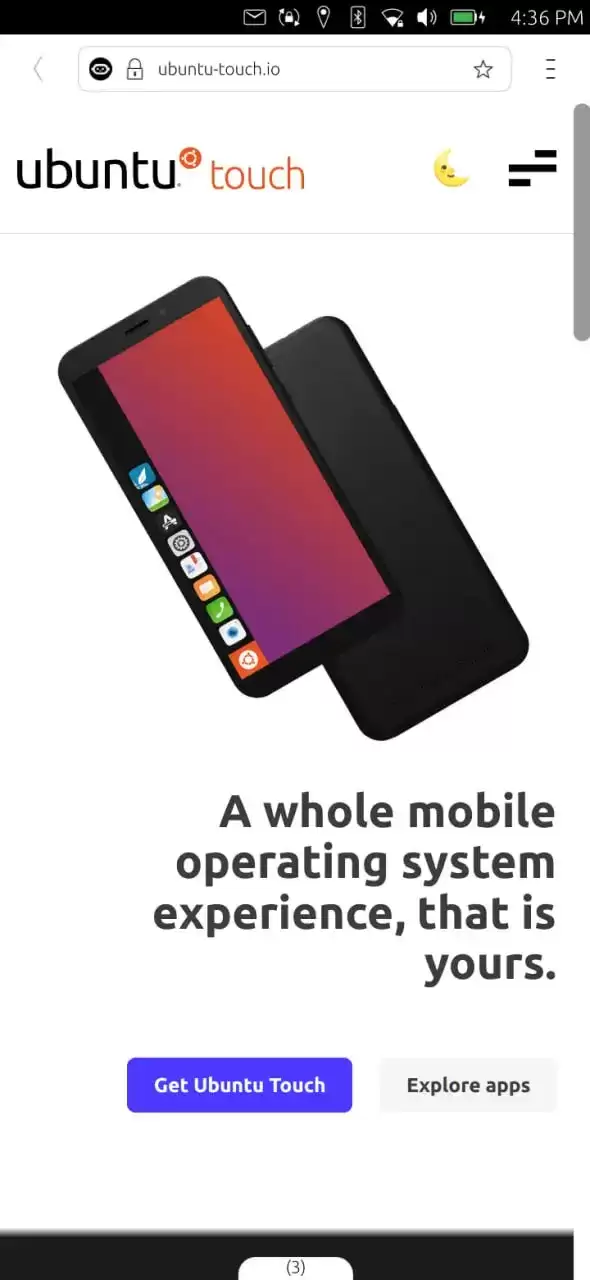
UbuntuTouch24.04-2.0Beta发布,底层升级至Ubuntu24.04,浏览器引擎从Chromium87跃升至134,网页兼容性显著提升;新增屏幕刘海区域自动适配、截图编辑器、网络指示器改进、移动数据可靠性增强、数据加密稳定,并新增NothingPhone(1)等设备支持。
ufw status仅显示高层策略和显式添加的规则(如“80 ALLOW Anywhere”),不反映默认策略绕过、IPv6独立规则、Docker等直写nftables的bypass规则,也无法体现本地回环流量不受管控等底层细节。Ubuntu 默认用 ufw 管理防火墙,但规则实际由 nftable
锁屏背景和桌面壁纸之所以不同,是因为GNOME默认会复制桌面壁纸,然后强制叠加高斯模糊和亮度调整效果,这个效果是由lockDialogGroup的CSS来控制的。要是想去除模糊,建议使用Control Blur Effect On Lock Screen扩展,把Adjust Sigma设置为0就行。
Ubuntu Swapper(一般就是指Ubuntu的交换分区或者交换文件)在服务器上的应用成效,是由多个因素共同决定的,像服务器的硬件配置情况、工作负载的类型以及交换空间的大小和具体配置等。下面为大家带来一些有关Ubuntu Swapper在服务器上应用效果的一般性评价:正面效果内存管理:交换空间
根本原因是纯命令行tty默认不支持UTF-8及中文字体渲染,locale设置仅影响字符解析逻辑,不解决字体绘制问题;图形终端自带UTF-8渲染,而tty需借助fbterm等工具实现中文显示。为什么终端里中文显示为问号或方块 纯命令行(tty,例如通过Ctrl+Alt+F3进入的界面)默认不会加载UT
通过分析Tomcat日志来提升Ubuntu服务器性能是一个很好的方法。以下是一些步骤和建议,帮助你通过Tomcat日志来优化服务器性能:1. 收集日志首先,得保证你的Tomcat服务器有详细的日志记录配置。在conf/logging.properties文件里,你可以对日志级别和输出格式进行调整。o






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
