

使用Hadoop和Spark在Beego中进行大数据处理
随着互联网技术的不断发展,大数据时代已经到来。大数据处理的重要性也日益增强。在处理大数据时,Hadoop和Spark是目前非常流行的解决方案。在使用这两个工具时,Beego是一种极受欢迎的Web框架,让开发人员可以更加高效地开发和管理代码。在本文中,我们将探讨如何在Beego中使用Hadoop和Spark进行大数据处理。Hadoop是基于Java的一个分布式
随着互联网技术的不断发展,大数据时代已经到来。大数据处理的重要性也日益增强。在处理大数据时,Hadoop和Spark是目前非常流行的解决方案。在使用这两个工具时,Beego是一种极受欢迎的Web框架,让开发人员可以更加高效地开发和管理代码。在本文中,我们将探讨如何在Beego中使用Hadoop和Spark进行大数据处理。
Hadoop是基于Java的一个分布式计算框架,可以高效地处理大量数据。Hadoop通过将数据分成多个块,并将其分散在多个计算机上来实现分布式计算。MapReduce是Hadoop用于分布式计算的核心模块。
与Hadoop相比,Spark是一种新兴的开源分布式计算框架,拥有更高的处理速度和更广泛的应用范围。Spark有多种编程语言接口,包括Scala、Java和Python。Spark的最大特点是对内存的利用率高于Hadoop,同时能够应对更广泛的数据处理需求。
在使用Beego开发和管理应用程序时,我们可以使用Hadoop和Spark来帮助我们处理大数据。以下是一些基本步骤:
1.安装Hadoop和Spark
首先,您需要安装Hadoop和Spark。如果您还没有安装,请访问它们的官方网站下载并安装。每个工具都需要单独设置。在这里,我们不会详细讨论安装细节。
2.连接Beego和Hadoop
在Beego中,我们可以使用go-hdfs工具包来连接到Hadoop。Go语言是Beego的一种支持语言。Go-hdfs提供了对Hadoop分布式文件系统的访问和操作。使用go-hdfs包中的Client结构体和相关方法,我们可以上传、下载和删除Hadoop中的文件。
以下是示例代码:
//连接Hadoop分布式文件系统
client, err := hdfs.New("localhost:9000")
//上传文件
err = client.CopyToRemote("/local/path/example.txt", "/hdfs/path/example.txt")
//下载文件
err = client.CopyToLocal("/hdfs/path/example.txt", "/local/path/example.txt")
//删除文件
err = client.Remove("/hdfs/path/example.txt")
3.连接Beego和Spark
在Beego中,我们可以使用GoSpark工具包来连接到Spark。GoSpark提供了对Spark计算框架的访问和操作。使用GoSpark包中的SparkApplication结构体和相关方法,我们可以提交Spark作业以及获取结果。
以下是示例代码:
//连接到Spark集群
app, err := spark.NewSparkApplication("spark://localhost:7077")
//创建Spark上下文环境
sparkContext, err := app.NewSparkContext("my-spark-job")
//创建RDD
rdd := sparkContext.Parallelize([]int{1, 2, 3, 4, 5})
//执行转换
squared := rdd.Map(func(x int) int { return x * x })
//执行操作
result := squared.Collect()
//打印结果
fmt.Printf("%v", result)
4.运行大数据处理任务
当我们连接到Hadoop和Spark后,我们就可以开始做大数据的处理任务了。以下是一个处理任务的示例代码:
//连接到Hadoop和Spark
hadoopClient, _ := hdfs.New("localhost:9000")
sparkApp, _ := spark.NewSparkApplication("spark://localhost:7077")
sparkContext, _ := sparkApp.NewSparkContext("my-spark-job")
//上传文件到Hadoop
hadoopClient.CopyToRemote("/local/path/public.csv", "/dataset")
//创建RDD
file := "hdfs://localhost:9000/dataset/public.csv"
csv := sparkContext.TextFile(file)
header := csv.First()
data := csv.Filter(func(line string) bool { return line != header })
//转换数据并保存至Hadoop
result := data.Map(func(line string) string {
parts := strings.Split(line, ",")
age, _ := strconv.Atoi(parts[0])
salary, _ := strconv.Atoi(parts[1])
output := fmt.Sprintf("%d,%d", age+1, salary*2)
return output
})
result.SaveAsTextFile("hdfs://localhost:9000/output")
//下载处理结果
hadoopClient.CopyToLocal("/output", "/local/path/output")
5.总结
在Beego中使用Hadoop和Spark进行大数据处理可以极大地提高开发人员的效率。Beego可以帮助加速Web应用程序的创建和管理,而Hadoop和Spark则为我们提供了处理大数据的能力。如果您正准备处理大量数据并想要提高开发效率,那么使用Beego、Hadoop和Spark将是一个不错的选择。
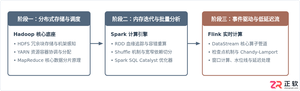
针对Java开发者的实用大数据技术路线解析,深入梳理Hadoop生态存储与资源调度、Spark离线计算与内存模型、Flink低延迟流处理的核心技术要点及递进学习方法。

针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
NVIDIA展台以巨型RTX显卡为造型,RTXSPARK系列笔记本首次在中国大陆公开亮相,现场展示多款OEM产品及离电性能。DGXSPARK支持图像识别与问答。技术体验区涵盖DLSS4.5游戏试玩和多元AI功能。联合多家厂商推出二次元定制显卡,但未公布发售计划。
达瓦科技基于NVIDIADGXSpark构建工程体系,将大模型推理部署于销售场景。其智能销售辅助机器人DealCat在高并发、低延迟环境下实现稳定运行,解决了实时推理与算力不足等瓶颈,助力企业销售全链路智能化。
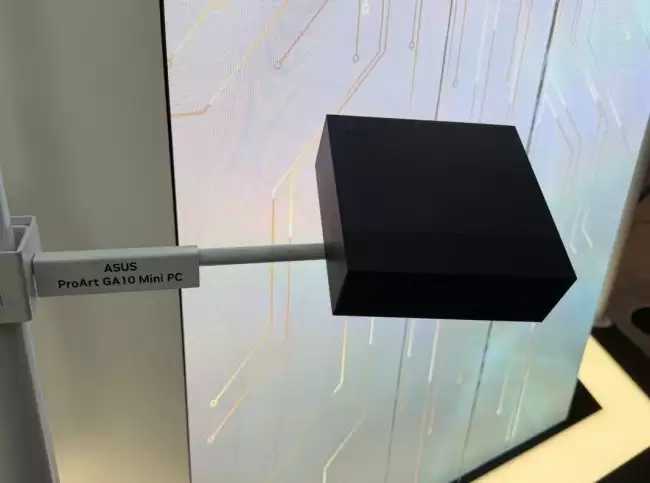
在台北电脑展上,联想、华硕、戴尔、微星四大厂商均推出了RTXSpark迷你主机新品,全部配备万兆网口。这款主机搭载二十核心CPU与四十八组SM的BlackwellGPU,最高可支持一百二十八GBLPDDR5X统一内存容量,并提供USB-C高速接口与PCIeGen5M.2扩展插槽。
Meta AI“推倒重来”:华人天团交出首份答卷Muse Spark,但更大的战争才刚刚开始 作者 | 猫猫头邮箱 | cathy@pingwest.com 在Llama 4的“崩盘”成为旧闻之后,Meta的AI路线图经历了一场彻底的自我革命。创始人扎克伯格亲手拆解了过去的团队与技术架构,转而押注一
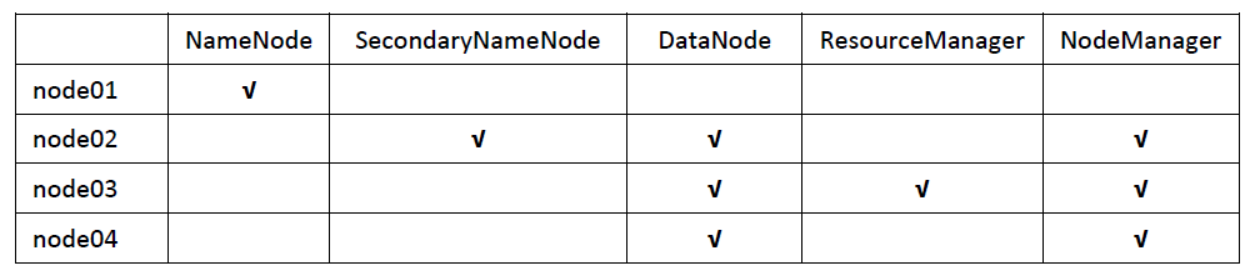
环境准备我使用的是CentOS-6.6版本的4台虚拟机,主机名分别为node01、node02、node03和node04。我将使用hadoop用户来搭建集群(在生产环境中,root用户通常不允许任意使用)。关于虚拟机的安装,可以参考以下两篇文章:在Windows中安装一台Linux虚拟机,以及通过已有的虚拟机克隆四台虚拟机。为集群中的每个虚拟机创建一个hadoop用户,并赋予sudoer权限,参考:Linux用户管理常用命令和Linux给普通用户赋予sudoer权限。每台虚拟机都需要安装JDK,参考在L
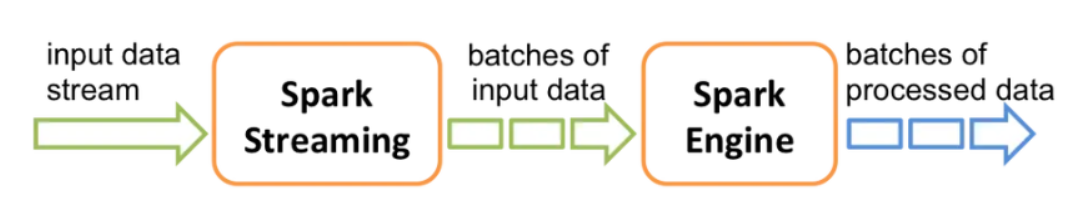
SparkStreaming和StructuredStreaming是ApacheSpark生态系统中用于流处理的两种不同框架。让我们详细比较它们的特点和优势。SparkStreaming的特点:SparkStreaming是Spark最初推出的流处理框架,采用微批处理的方式进行流数据处理。它使用基于RDD的DStreamAPI,每个时间间隔内的数据被视为一个RDD,通过不断处理这些RDD来实现流计算。然而,SparkStreaming也存在一些不足:处理时间而非事件时间:SparkStr

Beego是一款基于Go语言开发的Web框架,拥有高效、简洁的API设计和强大的功能模块,受到了广泛的欢迎。然而,一个项目通常有很多的配置项,如数据库连接、端口号、日志输出等等,这些配置项的管理是至关重要的。在这篇文章中,我们将介绍如何使用Viper来管理Beego中的配置文件。Viper是一个Go语言的配置管理工具,可以用于读取、解析和管理各种类型的配置文
ApacheSpark和Hadoop在数据处理方法上存在差异:Hadoop:分布式文件系统,批处理,使用MapReduce计算。Spark:统一数据处理引擎,实时处理和批处理兼备,提供内存计算、流处理和机器学习等功能。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



