

目标识别的视觉词袋技术
随着计算机视觉领域的不断发展,人们对于对象识别的研究也越来越深入。其中,视觉词袋(BoW)是常用的对象识别方法。本文将介绍视觉词袋方法的原理、优缺点,并举例说明。视觉词袋方法是一种基于图像局部特征的对象识别方法。它将图像分割为多个小区域,并提取每个区域的特征描述子。然后,通过聚类算法将这些特征描述子分组成一个视觉词袋,其中每个词袋表示一种特定的局部特征。在对象识别阶段,将输入图像的特征描述子与视觉词一、原理视觉词袋是一种经典的图像分类方法。它通过提取图像中的局部特征,并使用聚类算法将这些特征聚类为一组视觉
随着计算机视觉领域的不断发展,人们对于对象识别的研究也越来越深入。其中,视觉词袋(BoW)是常用的对象识别方法。本文将介绍视觉词袋方法的原理、优缺点,并举例说明。 视觉词袋方法是一种基于图像局部特征的对象识别方法。它将图像分割为多个小区域,并提取每个区域的特征描述子。然后,通过聚类算法将这些特征描述子分组成一个视觉词袋,其中每个词袋表示一种特定的局部特征。在对象识别阶段,将输入图像的特征描述子与视觉词
一、原理
视觉词袋是一种经典的图像分类方法。它通过提取图像中的局部特征,并使用聚类算法将这些特征聚类为一组视觉词。然后,通过统计每个视觉词在图像中出现的频率,将图像表示为一个固定长度的向量,即视觉词袋表示。最后,将视觉词袋输入分类器中进行分类。这种方法在图像识别任务中广泛应用,因为它能够捕捉到图像中的重要特征,并将其表示为可供分类器使用的向量形式。
二、优缺点
优点:
(1)视觉词袋方法简单,易于实现;
(2)能够提取出图像的局部特征,对于物体的旋转、缩放等变换具有一定的鲁棒性;
(3)对于较小的数据集,具有较好的分类效果。
缺点:
(1)视觉词袋方法没有考虑到特征之间的空间关系,对于物体的姿态变化、部分遮挡等情况,分类效果较差;
(2)需要手动设置聚类的数目,对于不同的数据集,需要重新设置聚类数目,导致通用性较差;
(3)不能利用深度学习中的优秀特征表示,因此分类效果有限。
三、举例说明
下面以MNIST数据集为例,说明视觉词袋的应用。
MNIST数据集是一个手写数字分类的数据集,包含60000个训练集样本和10000个测试集样本。每个样本是一个28x28的灰度图像,表示一个手写数字。代码实现如下:
import numpy as np
import cv2
from sklearn.cluster import KMeans
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

# 读取MNIST数据集
train_images = np.load('mnist_train_images.npy')
train_labels = np.load('mnist_train_labels.npy')
test_images = np.load('mnist_test_images.npy')
test_labels = np.load('mnist_test_labels.npy')

# 特征提取
features = []
sift = cv2.xfeatures2d.SIFT_create()
for image in train_images:
    keypoints, descriptors = sift.detectAndCompute(image, None)
    features.append(descriptors)
features = np.concatenate(features, axis=0)

# 聚类
n_clusters = 100
kmeans = KMeans(n_clusters=n_clusters)
kmeans.fit(features)

# 计算视觉词袋
train_bow = []
for image in train_images:
    keypoints, descriptors = sift.detectAndCompute(image, None)
    hist = np.zeros(n_clusters)
    labels = kmeans.predict(descriptors)
    for label in labels:
        hist[label] += 1
    train_bow.append(hist)
train_bow = np.array(train_bow)

test_bow = []
for image in test_images:
    keypoints, descriptors = sift.detectAndCompute(image, None)
    hist = np.zeros(n_clusters)
    labels = kmeans.predict(descriptors)
    for label in labels:
        hist[label] += 1
    test_bow.append(hist)
test_bow = np.array(test_bow)

# 分类
knn = KNeighborsClassifier()
knn.fit(train_bow, train_labels)
pred_labels = knn.predict(test_bow)

# 计算准确率
acc = accuracy_score(test_labels, pred_labels)
print('Accuracy:', acc) 
机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
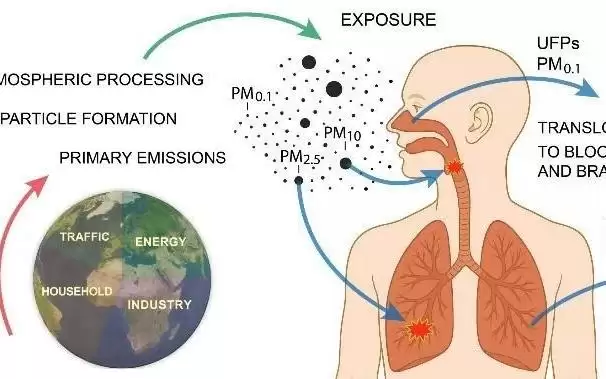
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



