

Django 中高效批量导入 JSON 数据到数据库的正确实践
本文详解如何在 Django 中安全、高效地将 JSON 文件数据批量写入 SQL 数据库,重点纠正单条保存导致的数据丢失问题,并推荐使用 bulk_create() 实现一次性高性能插入。 很多Django开发者刚接触JSON数据入库时,都会踩进同一个坑:把数据读完,然后在循环里逐条创建模型实例,
本文详解如何在 Django 中安全、高效地将 JSON 文件数据批量写入 SQL 数据库,重点纠正单条保存导致的数据丢失问题,并推荐使用 bulk_create() 实现一次性高性能插入。
很多Django开发者刚接触JSON数据入库时,都会踩进同一个坑:把数据读完,然后在循环里逐条创建模型实例,偏偏把.sa ve()放在了循环外面。结果呢?辛辛苦苦解析的一百条JSON记录,最后只有一条写进了数据库——通常还是最后一条。这个问题看似低级,但在实际项目中反复出现,尤其是赶工期的时候。
正确的做法其实很干脆:利用Django自带的bulk_create()方法,一次性把数据怼进去。下面这段代码就是标准解法,可以直接拿去用,但建议先理解每一行在干什么。
from django.shortcuts import render
import json
from .models import MyModel
import os

def display(request):
    # 安全构建 JSON 文件路径(推荐使用 pathlib 替代 os.path 拼接)
    json_file_path = os.path.join(
        os.path.dirname(__file__), '..', '..', 'jsondata.json'
    )
    try:
        with open(json_file_path, 'r', encoding='utf-8') as f:
            data = json.load(f)

        # ✅ 正确:列表推导式批量构建模型实例(不触发数据库操作)
        my_models = [
            MyModel(
                end_year=item.get('end_year'),
                intensity=item.get('intensity'),
                sector=item.get('sector'),
                topic=item.get('topic'),
                insight=item.get('insight'),
                url=item.get('url'),
                region=item.get('region'),
                start_year=item.get('start_year'),
                impact=item.get('impact'),
                added=item.get('added'),
                published=item.get('published'),
                country=item.get('country'),
                relevance=item.get('relevance'),
                pestle=item.get('pestle'),
                source=item.get('source'),
                title=item.get('title'),
                likelihood=item.get('likelihood'),
            )
            for item in data
        ]

        # ✅ 一次性批量写入数据库(性能提升显著,尤其对千级以上数据)
        MyModel.objects.bulk_create(my_models, batch_size=1000)

    except FileNotFoundError:
        data = []
        print(f"Warning: JSON file not found at {json_file_path}")
    except json.JSONDecodeError as e:
        print(f"Invalid JSON format: {e}")
        data = []
    except Exception as e:
        print(f"Unexpected error during bulk import: {e}")
        data = []

    return render(request, 'display.html', {'data': data})
这个版本做了三处关键改进,每一条都值得单拎出来说。
- 绕开了“单条保存”陷阱:老代码把
my_model_instance.sa ve()丢在循环外面,等于只保存了最后一次迭代的对象。新版先把所有实例收集到一个列表里,最后统一提交,这下一个都不会丢。 - 性能直接起飞:
bulk_create()能把N条INSERT合并成1到2条SQL语句(具体看batch_size怎么设)。相比以前一条一条.sa ve(),提速10倍到100倍都是家常便饭——数据量越大,优势越明显。 - 容错能力提升了一个档次:用
item.get(key)而不是直接item['key'],避免某个字段缺失就崩掉;显式指定encoding='utf-8'防止中文乱码;还补了文件找不到、JSON格式错误、以及其他异常的三层捕获,生产环境里能少弹不少错误日志。
如果这个模式要放到生产环境,有几点需要额外留意:
- 大文件(超过10MB)就别一次性全读进内存了,改用流式解析(比如
ijson)或者分批读取、分批导入。 - 在视图中直接干大批量导入容易把请求线程堵死,最好挪到Django管理命令里跑(
python manage.py load_json),或者丢给Celery异步处理。 - 如果模型里有
auto_now_add或auto_now这类字段,bulk_create不会自动帮你触发——得手动传进去,比如created_at=timezone.now()。
掌握这个模式之后,Django里面再处理结构化数据迁移,基本就是手到擒来的事。无论数据是从API抓来的、还是本地配置文件解析的,都能稳稳当当地落库。
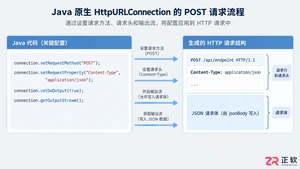
深入解析Java发送JSON格式POST请求的实现机制,对比原生API与第三方库的代码差异,提供可复制的代码示例,并探讨超时设置、编码处理及微服务场景下的例外情况。
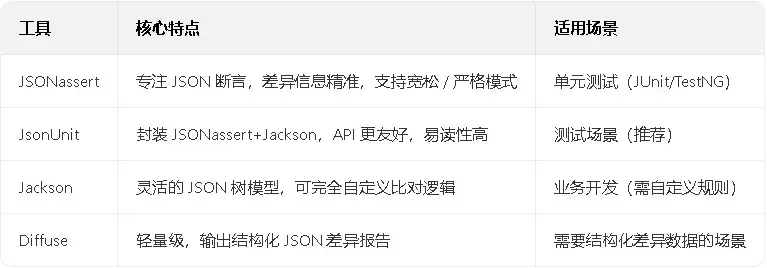
断言工具专为测试场景设计,支持宽松模式并精准定位差异;单元工具基于断言工具和杰克逊库封装,提供更友好的断言接口;杰克逊库作为主流处理库,可通过节点树模型自定义比对逻辑,适用于业务开发中精细控制差异的场景。
通过AJAX异步请求服务器获取JSON格式的表格数据,解析JSON对象后遍历数据条目,动态拼接成包含表格标签的HTML字符串,最后调用编辑器实例的setContent()方法将HTML写入编辑器,完成表格在编辑器内的初次渲染。
使用nlohmann/json库解析GeoJSONFeatureCollection,需逐层防御性访问features、geometry和properties,坐标数组维度不确定,需判断。坐标系和精度问题在解析层无法解决,应暴露原始坐标数组供上层处理。性能敏感时避免重复解析和深拷贝,可缓存并视口裁剪。
pandas.json_normalize 这个函数,说起来挺有意思的——很多人以为它能一键把嵌套 JSON 拍扁成表格,结果往往发现列名变成了一串带点的“火车”(比如 profile.address.city),真正棘手的问题却一个都没解决。字段缺失怎么办?列表嵌套怎么炸开?多层结构怎么拆?答案其





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



