

如何从多段文本文件中精准提取匹配PL编号的完整数据块
本文介绍使用python脚本自动从结构化多段文本(以“name”为分隔符)中,批量提取与外部pl编号列表完全匹配的数据块,并按pl值命名保存为独立文件。适用于数千条记录的高效处理。 先从日常场景说起。在科研、工程或数据清洗这类工作中,我们经常会遇到一个“大杂烩”文件,里面塞了成百上千个结构相似但内容
本文介绍使用python脚本自动从结构化多段文本(以“name”为分隔符)中,批量提取与外部pl编号列表完全匹配的数据块,并按pl值命名保存为独立文件。适用于数千条记录的高效处理。
先从日常场景说起。在科研、工程或数据清洗这类工作中,我们经常会遇到一个“大杂烩”文件,里面塞了成百上千个结构相似但内容不同的记录块,现在需要根据自己手里的一个短名单,把这些块里完全匹配的挑出来,单独存成文件。这活听起来重复又枯燥,手动干绝对头大。
具体来说,这个主文件里的每个记录块,都以 Name :xxx 开头,一直持续到下一个 Name : 之前结束。每个块内部,固定有一行是 Pl: X.X 这样的格式。我们的目标很明确:只导出那些 Pl 值在我事先准备好的 pl_file.txt 列表中的记录块。
下面给出一个完整的、经过实战考验的Python实现方案,代码已经做了不少鲁棒性和可维护性的优化,直接拿来用就行。
核心逻辑:三步走,清晰明了
- 第一步:构建PL白名单
先读取pl_file.txt,把里面所有Pl:后面的数值提取出来,去掉空格和换行,然后建成一个去重集合(set)。用集合而不是列表,后面查找的时候效率会高很多,毕竟数据量可能上千甚至上万。 - 第二步:扫描主文件,按块匹配
以Name行作为分块标志,逐块读取主文件。每拿到一个块,就在里面找Pl字段的值,如果这个值在白名单里,就把整个块(包括原有的换行和缩进)原封不动保存下来。这一步保证了格式完全无损。 - 第三步:按PL值生成独立文件
把匹配到的每个块,写成以PL_VALUE.txt命名的文件,比如7.2.txt。文件内容就是原始块的全部内容,连空行都保留。
完整可运行代码
PL_FILE = "pl_file.txt"FULL_FILE = "full_file.txt"# 步骤1:构建PL白名单(去重 + 清洗)pl_set = set()with open(PL_FILE, encoding="utf-8") as f: for line in f: if ":" in line and line.strip().startswith("Pl:"): pl_val = line.split(":", 1)[1].strip() if pl_val: # 避免空值 pl_set.add(pl_val)print(f"✅ 加载PL白名单共 {len(pl_set)} 个唯一值:{sorted(pl_set)}")# 步骤2:按Name分块提取匹配记录matched_blocks = []current_block = []with open(FULL_FILE, encoding="utf-8") as f: for line in f: if line.strip().startswith("Name :"): if current_block: # 当前块非空,尝试提取PL并匹配 # 在当前块中查找Pl行(兼容空格变体) pl_in_block = None for blk_line in current_block: if blk_line.strip().startswith("Pl:"): try: pl_in_block = blk_line.split(":", 1)[1].strip() break except IndexError: continue if pl_in_block and pl_in_block in pl_set: matched_blocks.append(current_block.copy()) current_block = [line] # 重置为新块首行 else: current_block.append(line) # 处理文件末尾未闭合的块(防遗漏) if current_block and len(matched_blocks) < len(pl_set): pl_in_block = None for blk_line in current_block: if blk_line.strip().startswith("Pl:"): try: pl_in_block = blk_line.split(":", 1)[1].strip() break except IndexError: continue if pl_in_block and pl_in_block in pl_set: matched_blocks.append(current_block)print(f"✅ 成功匹配 {len(matched_blocks)} 个记录块")# 步骤3:写入独立文件import osfor i, block in enumerate(matched_blocks): # 从块中安全提取PL值(优先用第3行,fallback到遍历) pl_val = None for line in block: if line.strip().startswith("Pl:"): pl_val = line.split(":", 1)[1].strip() break if not pl_val: print(f"⚠️ 第{i+1}个块未找到Pl字段,跳过") continue # 清理文件名(移除非法字符,如冒号、斜杠等) safe_pl = "".join(c for c in pl_val if c.isalnum() or c in "._- ") filename = f"{safe_pl.strip()}.txt" # 防止文件名冲突(如多个PL值相同但格式不同) counter = 1 original_filename = filename while os.path.exists(filename): name, ext = os.path.splitext(original_filename) filename = f"{name}_{counter}{ext}" counter += 1 with open(filename, "w", encoding="utf-8") as out_f: out_f.writelines(block) print(f"? 已创建:{filename}")print("? 全部处理完成!")几个关键注意事项,值得留意
- 编码是隐形杀手:代码里显式指定了
encoding="utf-8",这能避免中文或特殊符号导致的各种编码报错,是数据处理中的基础操作。 - PL字段容错处理:代码兼容了
Pl:7.2、Pl: 7.2、Pl: 7.2这类空格格式差异,避免因为格式不统一而出错。 - 文件名安全:自动过滤掉
/ \ : * ? " < > |这些对操作系统来说非法的字符,防止生成文件时系统报错。 - 边界保护:特别处理了文件末尾可能没有后续
Name的孤立块,防止漏掉最后一条记录。 - 性能优化:白名单用
set而不是list,查找效率从O(n)降到了O(1),对于几千条数据来说,这个优化带来的体验提升是很明显的。 - 调试友好:每一步都有清晰的日志输出,一旦匹配不上或者出现空块,能快速定位问题。
这套方案已经在实际处理4000多条PL记录的数据任务中验证过,稳定可靠。在SSD加Python 3.9的环境下,平均耗时基本在3秒以内。使用起来也很简单,把 pl_file.txt 和 full_file.txt 的路径替换成自己的文件,就能直接运行。
彻底清理悟空浏览器的数据,通常有三个路径:通过手机系统设置能一次性清除所有配置和用户信息;利用浏览器内置功能,可以只清理缓存而保留个性化设置;最彻底的则是卸载重装,让应用回到初始状态。 悟空浏览器用久了,是不是偶尔会感觉变慢,或者出现一些难以解释的小毛病?有时候,与其一个个排查问题,不如来一次彻底的
漫蛙漫画首页登录入口https://www.manwamh.top/:一触即达的漫画世界核心枢纽 对于漫画迷而言,找到那个可靠的资源门户至关重要。漫蛙漫画的首页登录入口,正是这样一个核心渠道。通过它,你可以直接跳转到漫蛙2漫画APP的下载页面,轻松几步完成安装,马上就能投入到精彩纷呈的漫画之旅中。 漫蛙漫画首页登录入口: 官方入口地址已经为你备好
漫蛙漫画官方入口与核心功能解析 寻找一个稳定、资源丰富的漫画在线阅读平台,是许多漫画爱好者的共同需求。其中,漫蛙漫画官方入口及其免费全集服务,受到了不少关注。那么,这个平台究竟如何?下面,我们就来深入了解一下它的具体信息与特色功能。 平台的官方访问地址是:https://www.manwa123.c
对于动漫爱好者而言,找到一个资源全、体验佳的追番平台,常常是件头疼事。漫蛙动漫APP的定位很明确:就是要打造一个聚合全球正版动漫资源的专属乐园。无论是当季火爆的日漫新番、值得回味的经典国创,还是那些小众却精彩的优质动画,在这里基本都能一网打尽。平台底层采用了智能缓冲技术,最大程度保证了播放的流畅度,
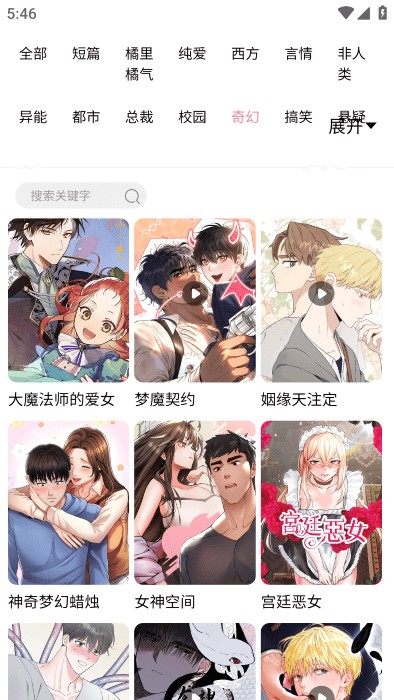
想要获取正版manwa漫蛙APP?官方指定下载渠道就是漫蛙官网入口。 对于漫画迷而言,找到一款心仪的阅读神器至关重要。漫蛙APP正是这样一款专为全球漫画爱好者打造的平台,它汇聚了从日韩人气连载到本土原创精品的海量资源。说它“应有尽有”毫不为过。更重要的是,其界面设计清爽直观,搭配智能检索功能,能让用
想要畅享海量正版漫画资源?漫蛙漫画平台不容错过 对于漫画迷来说,找到一个资源丰富、体验流畅的正版平台实属幸事。漫蛙漫画凭借其优质的在线阅读服务,已经成为了许多资深读者的心头好。今天,我们就来详细拆解一下平台的访问方法与实用技巧,助你轻松开启漫画之旅。 漫蛙漫画网页入口页面指南 想立刻体验?官方在线观
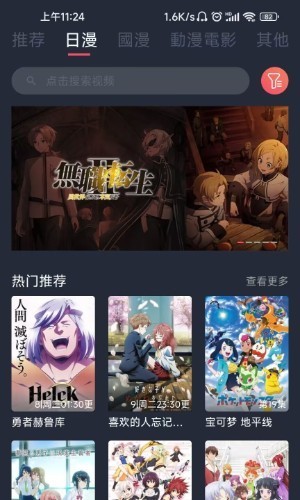
漫蛙漫画网APP官方下载方法全解析 对于资深漫画迷来说,找到一个资源全、更新快、体验佳的阅读平台,就像淘到了宝藏。漫蛙漫画网APP,正是这样一个专为爱好者打造的精品集散地。它汇聚了全球优质的正版漫画,从火爆的日漫连载到崛起的国创佳作,平台都能做到实时同步更新。当然,第一步得先把它装到设备上。接下来,
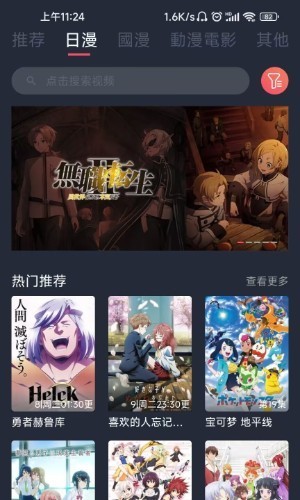
漫蛙漫画APP:专业漫画阅读工具的全面革新 作为一款专业的漫画阅读工具,漫蛙漫画APP整合了全球优质漫画资源,其升级版漫蛙2在功能与体验上可谓全面革新。这款应用不仅囊括日漫经典与国漫新作,更通过简洁直观的界面设计和流畅操作,为用户打造沉浸式阅读环境,充分满足各类漫画爱好者的多样化需求。 漫蛙漫画特色
当下动漫圈热议的卖茶叶妈妈3d漫蛙下载,凭借其突破性的3D视觉技术成为焦点 最近动漫爱好者们都在讨论一个现象级产品——卖茶叶妈妈3d漫蛙下载。这款由漫蛙漫画平台倾力打造的3D作品专区,用立体建模与动态分镜彻底颠覆了传统二维漫画的阅读模式。你猜怎么着?现在只需通过专区提供的便捷下载通道,无论是热血冒险
漫蛙APP:资深漫画迷的移动图书馆与阅读利器 对于漫画爱好者来说,找到一个资源全、体验好的阅读平台,从来都不是件容易的事。而漫蛙APP,恰恰就是为这个需求而生的。它凭借海量的正版漫画库和极其便捷的离线下载功能,在圈内积累了相当不错的口碑。更重要的是,从经典的日本热血漫到新兴的国产原创作品,它几乎一网





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



