

了解KNN算法的分类原理和步骤(通过KNN算法分类实例)
KNN算法是一种简单易用的分类算法,适用于小规模数据集和低维特征空间。它在图像分类、文本分类等领域中表现出色,因其实现简单、易于理解而备受青睐。KNN算法的基本思想是通过比较待分类样本的特征与训练样本的特征,找到最接近的K个邻居,并根据这K个邻居的类别确定待分类样本的类别。KNN算法中使用已标记好类别的训练集和待分类的测试集。KNN算法的分类过程包括以下几个步骤:首先,计算待分类样本与所有训练样本之间的距离;其次,选择距离最近的K个邻居;然后,根据K个邻居的类别进行投票,得出待分类样本的类别;最后,将待分

KNN算法是一种简单易用的分类算法,适用于小规模数据集和低维特征空间。它在图像分类、文本分类等领域中表现出色,因其实现简单、易于理解而备受青睐。
KNN算法的基本思想是通过比较待分类样本的特征与训练样本的特征,找到最接近的K个邻居,并根据这K个邻居的类别确定待分类样本的类别。KNN算法中使用已标记好类别的训练集和待分类的测试集。KNN算法的分类过程包括以下几个步骤:首先,计算待分类样本与所有训练样本之间的距离;其次,选择距离最近的K个邻居;然后,根据K个邻居的类别进行投票,得出待分类样本的类别;最后,将待分类样本的类别确定为投票结果中得票最多的类别。通过这些步骤,KNN算法可以对待分类样本进行准确的分类。
1.计算距离
对于未分类的测试样本,需计算其与训练集所有样本的距离,常用欧式、曼哈顿等方法。
2.选择K个邻居
根据计算出来的距离,选择与待分类样本距离最近的K个训练集样本。这些样本就是待分类样本的K个邻居。
3.确定类别
根据K个邻居的类别来确定待分类样本的类别。通常采用“多数表决法”来确定待分类样本的类别,即选择K个邻居中出现最多的类别作为待分类样本的类别。
KNN算法相对简单,但也有一些需要注意的问题。首先,K值的选择对算法的性能有很大的影响,通常需要通过交叉验证等方法来确定最优的K值。其次,KNN算法对数据集的规模和维度敏感,对于大规模和高维数据集的处理会出现效率问题。此外,KNN算法还存在“类别不平衡”的问题,即某些类别的样本数量较少,可能导致算法对这些类别的分类效果较差。
以下是一个使用Python实现KNN算法的分类实例,代码如下:
import numpy as np
from collections import Counter

class KNN:
    def __init__(self, k):
        self.k = k

    def fit(self, X, y):
        self.X_train = X
        self.y_train = y

    def predict(self, X_test):
        predictions = []

        for x_test in X_test:
            distances = []
            for x_train in self.X_train:
                distance = np.sqrt(np.sum((x_test - x_train)**2))
                distances.append(distance)
            idx = np.argsort(distances)[:self.k]
            k_nearest_labels = [self.y_train[i] for i in idx]
            most_common = Counter(k_nearest_labels).most_common(1)
            predictions.append(most_common[0][0])

        return np.array(predictions)
这个KNN类的构造函数中传入参数k表示选择多少个邻居来进行分类。fit方法用于训练模型,接受一个训练集X和它们对应的标签y。predict方法用于对测试集进行分类,接受一个测试集X_test,返回预测的标签。
在predict方法中,对于每个测试样本,首先计算它与训练集中所有样本的距离,并选择距离最近的k个样本。然后,统计这k个样本中出现最频繁的标签,并作为测试样本的分类标签。
下面是一个使用这个KNN类进行分类的例子,数据集为一个二维平面上的点集,其中红色点表示类别1,蓝色点表示类别2:
import matplotlib.pyplot as plt

# 生成数据集
X = np.random.rand(200, 2) * 5 - 2.5
y = np.zeros(200)
y[np.sum(X**2, axis=1) > 2] = 1

# 分割训练集和测试集
train_idx = np.random.choice(200, 150, replace=False)
test_idx = np.array(list(set(range(200)) - set(train_idx)))
X_train, y_train = X[train_idx], y[train_idx]
X_test, y_test = X[test_idx], y[test_idx]

# 训练模型并进行预测
knn = KNN(k=5)
knn.fit(X_train, y_train)
y_pred = knn.predict(X_test)

# 计算准确率并绘制分类结果
accuracy = np.mean(y_pred == y_test)
print("Accuracy:", accuracy)

plt.scatter(X_test[:, 0], X_test[:, 1], c=y_pred)
plt.show()
运行这段代码后,可以看到分类结果图像。其中,颜色表示预测的类别,红色表示类别1,蓝色表示类别2。根据分类结果,可以计算出模型的准确率。
这个实例展示了KNN算法在二维平面上的应用,通过计算距离来确定邻居,并根据邻居的类别来进行分类。在实际应用中,KNN算法可以用于图像分类、文本分类等领域,是一种简单而有效的分类算法。
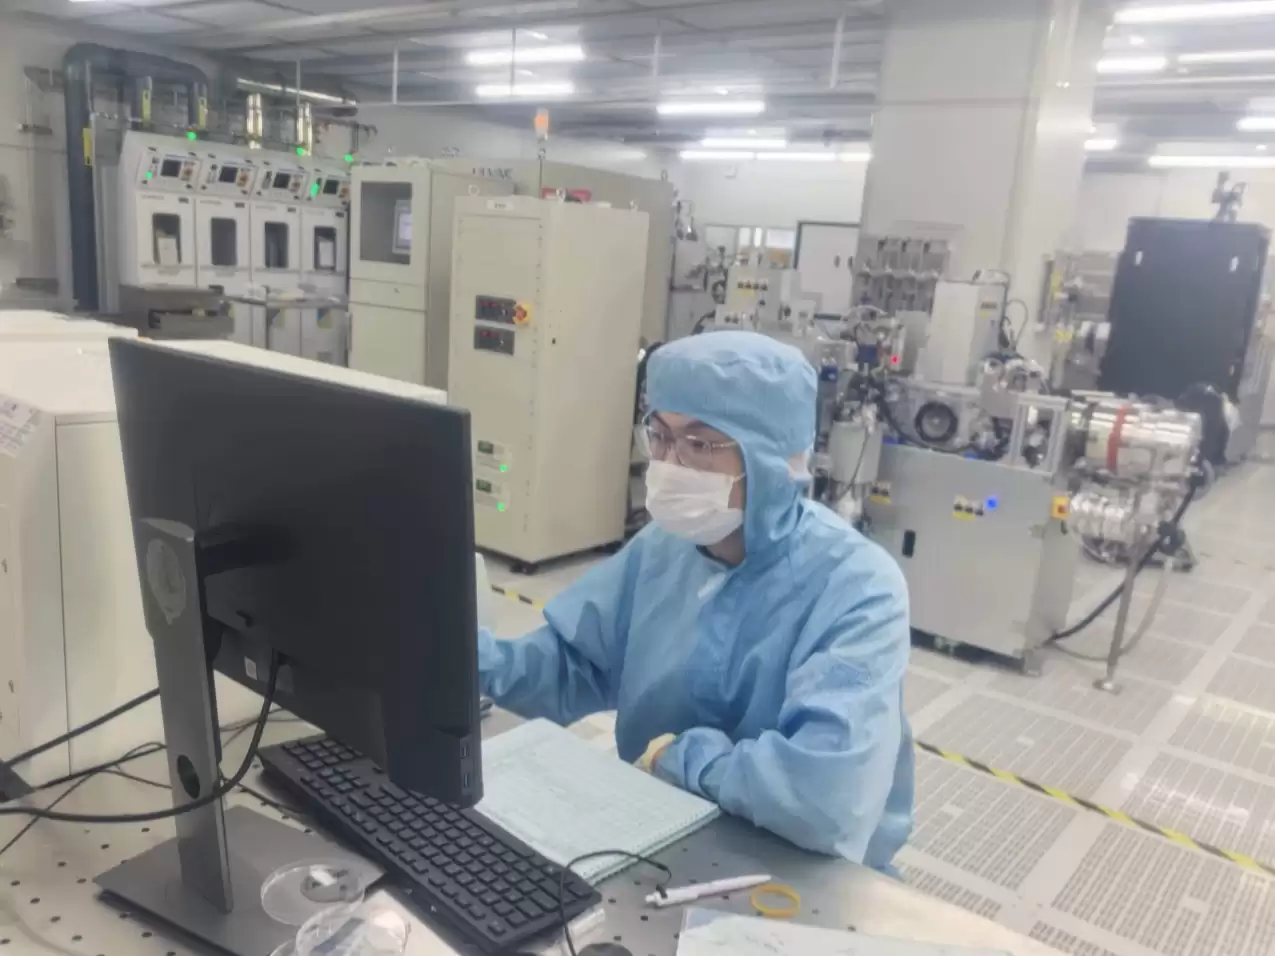
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。
苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。

一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。

2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。
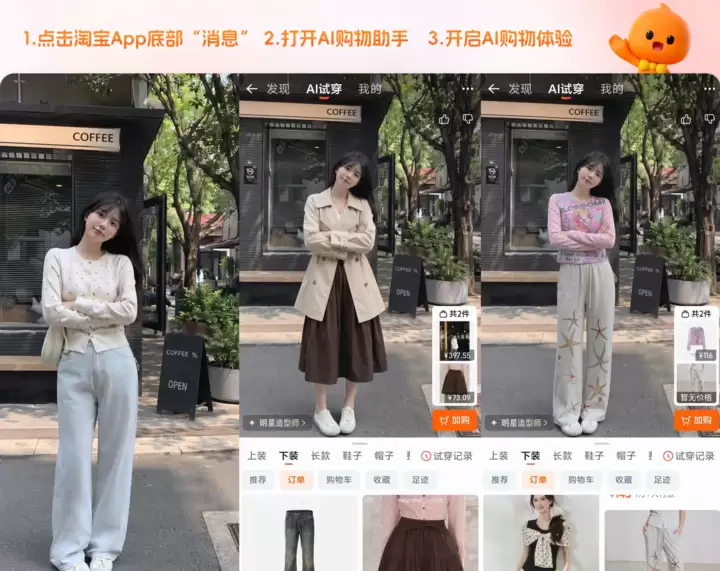
618”期间,AI全面渗透电商,超百万商家使用AI工具提升效率。政策补贴拉动绿色智能家电及汽车消费,市场回暖。供应链升级实现仓配一体化,时效大幅提升,多链协同激活内需活力。
AI生成作品虽完美却缺乏“活人感”,这一悖论贯穿艺术史。《红楼梦》中已批判套路化创作。真正活人感源于创作者内化形式美规律后的即兴发挥与平衡,而非单纯拒绝美化。能否尊重生活细节、容忍碰撞,决定作品是否鲜活,这也是艺术的根本功用。
商务部等8部门发布《关于加快“人工智能+消费”发展的实施意见》,围绕服务消费和商品消费两大领域,明确居家、养老、文旅、教育等场景的AI应用方向,推广智能家居、养老机器人等产品,并适度超前布局城市智能设施。

商汤与香港科技园合作共建国产AI算力中心,目标2030年前实现超40000P算力规模,首阶段预计今年完成。该中心配备国产GPU集群,支撑模型训练与推理,服务本地及国际客户。商汤临港AIDC已有4.04万P算力运营经验。

亚马逊正考虑将其开发的TrainiumAI芯片直接出售给其他公司,以挑战英伟达主导地位。该芯片面向需要本地化数据解决方案的国际企业,亚马逊表示不会影响AWS云业务收入,谷歌也有类似计划。
广东省印发服务业扩能提质方案,聚焦AI机遇,建设国际竞争力的软件与信息技术创新中心,包括培育核心企业、构建AI服务体系、攻关核心技术、建设开源生态,并部署融资租赁、金融合作、算力网络、6G及智能应用。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
