

使用BERT模型进行情感分类的方法是什么?
BERT是一种用于自然语言处理的技术,它可以广泛应用于各种任务,其中包括情感分类。情感分类是文本分类的一种特殊形式,其目标是确定文本所表达的情感,如正面、负面或中性。BERT模型基于Transformer架构,利用大量的无标签文本数据进行预训练,以提高模型的性能。通过预训练,BERT能够学习到丰富的语言知识,包括词汇、句法和语义等,使得模型在各种任务上都能取得很好的表现。因此,BERT已成为自然语言处理领域的重要工具,为情感分类等任务提供了强大的支持。BERT模型的预训练过程可以分为两个阶段:Masked
BERT是一种用于自然语言处理的技术,它可以广泛应用于各种任务,其中包括情感分类。情感分类是文本分类的一种特殊形式,其目标是确定文本所表达的情感,如正面、负面或中性。BERT模型基于Transformer架构,利用大量的无标签文本数据进行预训练,以提高模型的性能。通过预训练,BERT能够学习到丰富的语言知识,包括词汇、句法和语义等,使得模型在各种任务上都能取得很好的表现。因此,BERT已成为自然语言处理领域的重要工具,为情感分类等任务提供了强大的支持。
BERT模型的预训练过程可以分为两个阶段:Masked Language Model和Next Sentence Prediction。 在Masked Language Model阶段,BERT模型会从输入文本中随机选择一些词,并将它们替换为特殊的[MASK]标记。模型的目标是预测这些被遮盖的词。通过这个过程,BERT模型可以学习到词之间的上下文关系,从而更好地理解和生成文本。 在Next Sentence Prediction阶段,BERT模型接收两个句子作为输入,目标是判断这两个句子是否在语义上相互关联。通过这个任务,BERT模型可以学习到句子之间的关联性,从而更好地理解句子的语义和上下文。 通过这两个阶段的预训练,BERT模型可以获得丰富的语义和上下文信息。这使得BERT模型在各种自然语言处理任务中表现出色,例如文本分类、命名实体识别、问答系统等。同时,BERT的预训练过程还采用了大规模的无标签文本数据,使得模型可以从大规模数据中学习通用的语言知识,进一步提升了其性能。 总结来说,BERT模型的预训练过程包括
经过预训练后,BERT模型可以用于情感分类任务。可以将BERT作为特征提取器,结合其他机器学习算法(如逻辑回归、支持向量机等)进行分类。另外,也可以对BERT进行微调,通过在特定情感分类数据集上进行端到端训练,进一步提升分类性能。
对于特征提取器方法,可以使用BERT模型的输出向量作为输入特征向量。然后,可以结合其他机器学习算法来训练分类器。在进行分类之前,需要对文本进行预处理,如分词、去除停用词、词干提取等。使用BERT的预训练模型可以生成词嵌入,将这些嵌入作为特征向量。这样可以有效地提取文本的语义信息,帮助分类器更好地理解和区分不同文本样本。
对于微调方法,可以通过在情感分类数据集上进行端到端训练来微调BERT模型。在这种方法中,BERT模型的所有层都可以重新训练以适应特定任务的需求。微调过程中,可以根据需要使用不同的学习率、批次大小和训练轮数来优化模型。通过微调BERT模型,可以提高模型性能,因为它可以根据特定任务的要求调整权重。这种个性化定制的能力使得BERT模型在各种自然语言处理任务中表现出色。
在使用BERT模型进行情感分类时,需要注意以下几点:
1.数据预处理:在使用BERT模型之前,需要对文本进行预处理,例如分词、去停用词、词干提取等。
2.数据标注:需要准确标注文本的情感分类。标注数据应该具有足够的覆盖面,以确保模型能够学习到各种情感的分类。
3.模型选择:可以选择使用预训练的BERT模型或微调BERT模型进行情感分类。微调BERT模型可以提高模型性能,但也需要更多的计算资源和时间。
4.超参数调整:需要对模型的超参数进行调整,例如学习率、批次大小和训练轮数等,以优化模型的性能。
5.模型评估:需要对模型进行评估,以确定模型的性能是否符合预期。可以使用准确率、召回率、F1分数等指标来评估模型的性能。
Python代码演示微调BERT模型进行情感分类
BERT模型实现情感分类可以通过两种方法:特征提取和微调。本文将以微调BERT模型进行情感分类为例,同时提供Python代码来演示如何实现。
1)数据集
我们将使用IMDB情感分类数据集进行演示。该数据集包含来自IMDB电影评论的50,000条文本,其中25,000条用于训练,另外25,000条用于测试。每个样本都有一个二进制标签,表示正面(1)或负面(0)情感。
2)获取数据集
首先,我们需要下载IMDB数据集。可以使用以下代码下载数据集:
!wget http://ai.stanford.edu/~amaas/data/sentiment/aclImdb_v1.tar.gz
!tar -xf aclImdb_v1.tar.gz
3)导入必要的库
接下来,我们需要导入必要的Python库,包括PyTorch、Transformers和NumPy。可以使用以下代码导入这些库:
import torch
import transformers as ppb
import numpy as np
4)加载BERT模型和标记器
我们将使用Pretrained BERT模型(ppb)库中的BERT模型和标记器。可以使用以下代码加载模型和标记器:
model_class, tokenizer_class, pretrained_weights = (ppb.BertModel, ppb.BertTokenizer, 'bert-base-uncased')
tokenizer = tokenizer_class.from_pretrained(pretrained_weights)
model = model_class.from_pretrained(pretrained_weights)
5)加载数据集
接下来,我们需要加载IMDB数据集。可以使用以下代码加载数据集:
import pandas as pd
import io

# Load data
train = pd.read_csv('aclImdb/train.tsv', delimiter='\t', header=None)
test = pd.read_csv('aclImdb/test.tsv', delimiter='\t', header=None)

# Split data into input and labels
train_sentences = train[0].values
train_labels = train[1].values
test_sentences = test[0].values
test_labels = test[1].values
6)预处理数据
在微调BERT模型之前,我们需要对数据进行预处理。这包括对文本进行标记化、截断和填充。可以使用以下代码对数据进行预处理:
# Tokenize the input texts
train_tokenized = np.array([tokenizer.encode(sent, add_special_tokens=True) for sent in train_sentences])
test_tokenized = np.array([tokenizer.encode(sent, add_special_tokens=True) for sent in test_sentences])

# Truncate and pad the input texts
max_len = 128
train_padded = np.array([i[:max_len] + [0]*(max_len-len(i)) for i in train_tokenized])
test_padded = np.array([i[:max_len] + [0]*(max_len-len(i)) for i in test_tokenized])

# Create attention masks
train_attention_mask = np.where(train_padded != 0, 1, 0)
test_attention_mask = np.where(test_padded != 0, 1, 0)

# Convert the input texts to PyTorch tensors
train_input_ids = torch.tensor(train_padded)
train_attention_mask = torch.tensor(train_attention_mask)
train_labels = torch.tensor(train_labels)
test_input_ids = torch.tensor(test_padded)
test_attention_mask = torch.tensor(test_attention_mask)
test_labels = torch.tensor(test_labels)
7)微调BERT模型
我们将使用PyTorch框架对BERT模型进行微调。可以使用以下代码对模型进行微调:
from torch.utils.data import TensorDataset, DataLoader, RandomSampler, SequentialSampler
from transformers import AdamW, get_linear_schedule_with_warmup

#Create a data loader for training data
batch_size = 32
train_data = TensorDataset(train_input_ids, train_attention_mask, train_labels)
train_sampler = RandomSampler(train_data)
train_dataloader = DataLoader(train_data, sampler=train_sampler, batch_size=batch_size)

#Create a data loader for test data
test_data = TensorDataset(test_input_ids, test_attention_mask, test_labels)
test_sampler = SequentialSampler(test_data)
test_dataloader = DataLoader(test_data, sampler=test_sampler, batch_size=batch_size)

#Set up the optimizer and scheduler
epochs = 3
optimizer = AdamW(model.parameters(), lr=2e-5, eps=1e-8)
total_steps = len(train_dataloader) * epochs
scheduler = get_linear_schedule_with_warmup(optimizer, num_warmup_steps=0, num_training_steps=total_steps)

#Train the model
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
model.to(device)
for epoch in range(epochs):
    print(f'Epoch {epoch + 1}/{epochs}')
    print('-' * 10)
    total_loss = 0
    model.train()
    for step, batch in enumerate(train_dataloader):
        # Get batch input data
        batch_input_ids = batch[0].to(device)
        batch_attention_mask = batch[1].to(device)
        batch_labels = batch[2].to(device)

    # Clear gradients
    model.zero_grad()

    # Forward pass
    outputs = model(batch_input_ids, attention_mask=batch_attention_mask, labels=batch_labels)
    loss = outputs[0]

    # Backward pass
    loss.backward()

    # Update parameters
    optimizer.step()

    # Update learning rate schedule
    scheduler.step()

    # Accumulate total loss
    total_loss += loss.item()

    # Print progress every 100 steps
    if (step + 1) % 100 == 0:
        print(f'Step {step + 1}/{len(train_dataloader)}: Loss = {total_loss / (step + 1):.4f}')

# Evaluate the model on test data
model.eval()
with torch.no_grad():
    total_correct = 0
    total_samples = 0
    for batch in test_dataloader:
        # Get batch input data
        batch_input_ids = batch[0].to(device)
        batch_attention_mask = batch[1].to(device)
        batch_labels = batch[2].to(device)

        # Forward pass
        outputs = model(batch_input_ids, attention_mask=batch_attention_mask)
        logits = outputs[0]
        predictions = torch.argmax(logits, dim=1)

        # Accumulate total correct predictions and samples
        total_correct += torch.sum(predictions == batch_labels).item()
        total_samples += len(batch_labels)

    # Print evaluation results
    accuracy = total_correct / total_samples
    print(f'Test accuracy: {accuracy:.4f}')
代码解析:
首先,我们使用PyTorch的数据加载器加载数据。我们将训练数据和测试数据分别放入train_data和test_data张量中,并使用RandomSampler和SequentialSampler对它们进行采样。然后,我们将train_data和test_data输入到DataLoader中,并设置batch_size为32。
接下来,我们设置优化器和学习率调度器。我们使用AdamW优化器和get_linear_schedule_with_warmup学习率调度器。我们将epochs设置为3,并使用total_steps计算总的训练步数。
然后,我们将模型移动到GPU设备上(如果可用)。在每个epoch中,我们将模型设置为训练模式,并遍历train_dataloader以进行训练。对于每个批次,我们将批次输入数据传递给模型,并计算损失。然后,我们使用反向传播更新模型参数,并使用scheduler更新学习率。我们还累计了总损失,并在每100个步骤后打印进度。
在每个epoch结束时,我们将模型设置为评估模式,并使用torch.no_grad()上下文计算在测试数据上的准确度。我们对test_dataloader进行遍历,并对每个批次进行预测。我们将预测结果与真实标签进行比较,并累计总正确预测数和样本数。最后,我们计算测试准确度并打印结果。
解析宇树科技营收增长但净利下降的原因,说明一加Ace 7 Pro 185Hz高刷的具体适用场景,并厘清Gemini 4 Carbon在长任务与代码安全方面的开放范围,提供准确的数据阅读方法。
Mate70 Pro与iPhone16 Pro拍照样张对比:观察食物暖色、展厅背景色差和红叶层次,说明构图与拍摄条件的限制,区分风格偏好与综合影像能力。
解析本周AI产品动态:说明Claude Ultra仅对已验证账户取消五小时窗口限制而非无限使用;明确Apple智能接入千问处于开发者测试阶段,非全量Siri能力开放;指出GO-3与灵渠OS仅为场景演示,不提供通用部署教程。引导用户依据官方公告核对自身设备与账户条件。
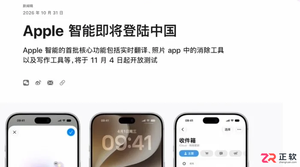
解读国行Apple智能11月4日开放测试的真实含义,明确其与12月iOS 27.3正式版的区别。说明首批功能清单及千问模型支持范围,并提供核对软件更新状态的正确方法,帮助用户理性参与测试。
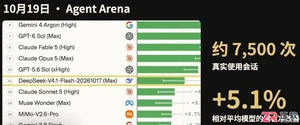
了解DeepSeek V4.1 Flash 1017的Agent Arena指标、约0.20美元任务成本中位数,以及Terminal-Bench 4.0和ProgramBench成绩变化与适用边界。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
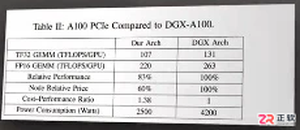
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
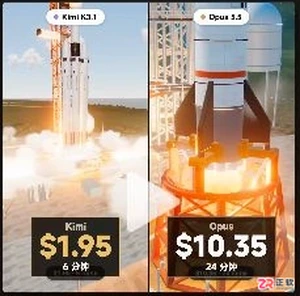
了解 Kimi K3.1 Pro 案例费用、SKY-001 零件构建耗时和 Mercury 3 测试表的限定条件,查看经核实的官方产品说明入口。
想了解Laper AI的真实工资待遇?本文教你如何通过多渠道交叉验证岗位薪资,识别招聘话术中的水分,获取更准确的收入预期参考。
解析字节旗下豆包App、火山引擎、Seedance、TRAE及飞书的定位差异。通过官方文档核对云服务、视频模型、编程工具与办公AI的功能边界,帮助读者准确选择适合的产品入口。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



