

Cursor 自曝黑科技:重写 MoE 生成机制,Blackwell 推理性能直接翻倍!
Cursor团队在BlackwellGPU上重构MoE生成机制,采用输出中心的WarpDecode,绕过传统专家中心路径的内存低效,实现高效推理。推理速度提升至1.84倍,吞吐量达到118-121tokens/s,输出精度接近FP32标准,提升至1.4倍。该成果显著优化了模型部署效率与性能。
最近,Cursor 团队在 Blackwell GPU 上对 MoE 模型的生成机制做了一次彻底的重新设计,结果嘛——推理速度直接翻了 1.84 倍,吞吐量冲到了 118–121 tokens/s,而且输出精度也更接近 FP32,提升了 1.4 倍。
Cursor 在 X 上发了个推,说他们重建了 MoE 模型在 Blackwell GPU 上生成 token 的方式,推理速度直接快了 1.84 倍。
这组数据确实亮眼:
- 吞吐量从 64–66 tokens/s 直接飙升到 118–121 tokens/s,提升了 1.84 倍;
- 输出质量也更接近全精度 FP32,接近度提升了 1.4 倍。
这套方法的核心是“输出中心”的 Warp Decode,它直接把传统 MoE 的“专家中心”生成方式中那些内存效率低、准确性差的问题,一次性全给解决了。
今天,我们就来拆解一下:Cursor 的 Warp Decode 到底做了什么?为什么能同时做到速度和精度的双提升?
传统MoE:专家派单,效率超低
现在的顶级大模型,大多采用 Mixture of Experts 架构——一个模型里边有几十甚至上百个“专家子网络”,输入的时候只激活其中一部分。比如在某层从 128 个专家里挑 8 个来干活,这样既能保持超大参数量,又能控制实际计算量。
传统 MoE 的计算路径大致是这样的:
- 先通过路由决定每个 token 该去哪个专家;
- 然后把属于同一个专家的 token 收集起来;
- 专家完成计算后,再把结果重新组装回去。
这种传统路径在大批量场景下效果很好,因为每个专家上的共享工作足以摊薄数据整理的额外开销。但在自回归解码阶段——也就是我们生成代码的时候——由于一次只生成几个 token,没有足够的共享工作来支撑。传统路径中的八个阶段里,有五个阶段纯粹是“数据管理”,本身并不进行任何实际计算。
到了实际应用里,结果就是:理论上 MoE 很高效,但实际上大部分时间都在运送数据,GPU 带宽利用率低,跑起来慢。
Warp Decode:围绕“输出”,跳过“中间商”
既然搬运数据太慢,Cursor 直接换了一条路。
我们先来了解 warp decode 具体是什么。根据官方描述:在 Blackwell GPU 上进行小批量解码时,围绕输出而非专家来组织 kernel 效果更好,Cursor 将这种方法称为“warp decode”。
现代 GPU 会以由 32 条并行处理通道组成的组来执行指令,这样的一组称为一个 warp。在 warp decode 中,每个 warp 都只负责计算一个输出值。warp 会直接从内存中流式读取所需的权重数据,将所有 8 个路由专家的结果汇总到一个持续累加的总值中,最后写出一个结果。
那么 warp decode 是如何运行的呢?简单来说,从围绕“专家”到围绕“输出”,中间的环节能砍则砍。
warp decode 主要通过两种机制提升性能:一是去掉传统路径所需的阶段和缓冲区,二是实现 warp 的独立性,从而带来更优的调度效果和更好的延迟隐藏能力。
具体做法
- 每个 GPU warp 只负责一个输出标量,并且这个 warp 在整个计算过程中“终身”只干这一件事。
- warps 之间完全独立,没有跨 warp 的同步或共享可变状态。
- 整个 MoE 层被极致压缩成仅两个融合内核:
moe_gate_up_3d_batched 处理 gate 和 up 投影,warp 独立完成 dot product、SiLU 激活等,中间值直接在寄存器里算,不写共享内存;
moe_down_3d_batched 处理 down 投影,每个 warp 循环遍历 top-k 专家,累加结果,最后用 warp 级别的 butterfly reduction 把部分和合并成最终输出。整个过程几乎全在寄存器里完成,避免了大量中间缓冲区和内存往返。 - 蝶形归约将 warp 内 32 个 lane 的局部部分和快速合并成最终的输出标量。当 moe_down_3d_batched 内核处理完一个 token 对应的所有 top-k 专家后,每个 warp 已经把来自不同专家的贡献累加到了自己私有的 FP32 寄存器累加器。这时,一条指令 __shfl_xor_sync 来做 warp 级别的蝶形归约,编译成底层的 PTX 指令 shfl.sync.bfly。
效果爆炸:速度+精度双开挂
完全绕过共享内存,不需要把中间结果写到 shared memory 再读回来;无 L1 缓存往返、无 bank 冲突,所有操作都在寄存器层面完成,延迟极低;无需显式屏障,同步逻辑已经内置在指令的 lane mask 里,直接保证正确性。
根据官方测试,效果确实好到爆炸:
- 在 Cursor 内部推理系统上,针对运行于 NVIDIA B200 的 Qwen-3 风格模型测试:
- 速度方面,端到端解码吞吐量提升 1.84 倍,在不同上下文长度下表现都很稳定(纯生成阶段优化)。
- 精度方面,输出与完整 FP32 参考值相比,接近程度提升 1.4 倍。
- 硬件效率方面,B200 在连续内存读取上的实测峰值为 6.8 TB/s (通过 copy kernel 测得)。在 B=32 时,warp decode 可稳定达到 3.95 TB/s,相当于该峰值的 58%。
网友热议:放到 Vera Rubin 上效果如何?
X 上的网友在体验之后也表示赞叹:“这个模型非常棒,准确度提升了很多。”
也有网友提出关键问题:这个 warp decode 是仅在 Blackwell 上运行,还是可以推广至其他平台?放到 Vera Rubin 上效果会怎么样?
根据 Cursor 官方博客,目前 warp decode 是专为 Blackwell GPU(B200)的小批量自回归解码场景量身打造的。大批量 prefill 阶段,传统 MoE 方式可能还更有优势。至于未来能不能推广到其他 GPU,还得看 Cursor 后续会不会分享更多细节。
OGS团队使用影驰HOFOCLAB版RTX5090D,更换晶振并液氮冷却,核心频率达4002MHz,成为Blackwell架构首款破4GHz显卡,GPUPI测试以35.377秒刷新纪录。
英伟达在犹他州完成测试,将BlackwellAI芯片与瓦拉公司Ward250反应堆对接供电,验证了核能作为算力基荷能源的技术可行性。该反应堆额定热功率100千瓦,峰值250千瓦,仅能支撑不到一个标准AI机架,属原理验证。双方计划建设小型数据中心,探索核能供电与闭环液冷技术。
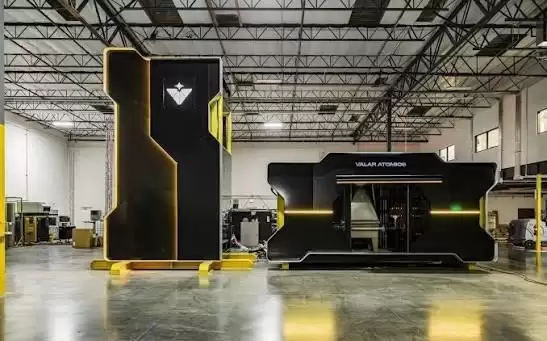
美国核能初创公司Valar在犹他州用Ward250先进反应堆为英伟达Blackwell芯片供电,系美国首次。双方计划共建小型数据中心,验证核能供电与闭环液冷技术以摆脱电网和水资源依赖。该反应堆已临界,但行业仍处起步阶段,尚无商业运营。
人工智能云计算公司科维克斯签署多年期协议,为领先人工智能企业提供搭载英伟达布莱克威尔图形处理器及量子二号无限带宽网络的集群,股价盘前一度飙升近百分之百,凸显顶级人工智能算力资源稀缺性。
苹果公司计划于2028年推出M7Ultra芯片,配备最高一点五太字节统一内存,AI性能对标Blackwell架构,内存带宽或突破每秒一太字节。为适应高功耗,MacStudio将大幅重构内部结构与散热系统,但发货时间受内存芯片供应制约。
英伟达持续优化Blackwell平台,GB200NVL72运行DeepSeekR1模型每兆瓦吞吐量三个月翻4倍,优化成果可跨模型复用。GB300训练性能六个月提升1.5倍,扩展效率接近理论上限。新一代Rubin平台加速部署,软件优化延长了硬件生命周期。
联想发布ThinkStationP4工作站,首次将AMD3DV-Cache技术引入专业领域。该产品搭载AMD锐龙Pro9000系列处理器与NVIDIARTXPro6000Blackwell专业显卡,采用液冷散热,支持256GBDDR5内存及多硬盘扩展。其紧凑机身兼顾高性能与低噪音,并通过多项专业软件认证与环保标准,面向工程、设计及AI密集型应用。
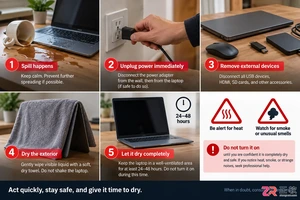
笔记本进水或摔落后无法开机?立即停止通电,按照本指南步骤断开电源和电池,避免二次损伤。了解何时该自行处理,何时必须送修以保护数据安全。
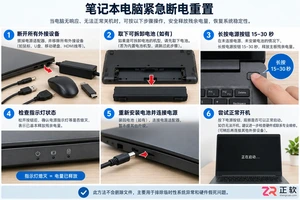
当笔记本电脑出现黑屏、指示灯亮但无反应等假死现象时,可尝试“静电释放”法。本文详解如何安全断开所有电源与外设,并通过长按电源键15-30秒清除主板残余电荷,最后重新接电测试是否恢复。
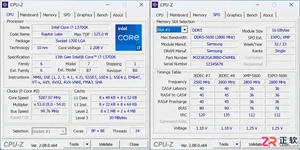
想要看清电脑硬件的真实面貌?本教程详解CPU-Z、HWiNFO64等专业工具的使用场景,教你在购机、排查故障时获取准确的处理器、内存、硬盘及传感器数据,拒绝参数虚标。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



