

C#ASCII码转换实战及其常见问题解决方案
1. 项目概述:从字符到数字的桥梁 在C#编程的日常里,字符处理是绕不开的基础。无论是解析网络协议、处理用户输入,还是进行简单的数据加密,我们常常需要窥探字符背后的“数字身份”——ASCII码。这个项目,就是搭建一座连接字母(字符)与ASCII码的桥梁。乍一看,这似乎是个简单的“一行代码”任务,但深
1. 项目概述:从字符到数字的桥梁
在C#编程的日常里,字符处理是绕不开的基础。无论是解析网络协议、处理用户输入,还是进行简单的数据加密,我们常常需要窥探字符背后的“数字身份”——ASCII码。这个项目,就是搭建一座连接字母(字符)与ASCII码的桥梁。乍一看,这似乎是个简单的“一行代码”任务,但深入下去,你会发现其中涉及编码原理、类型转换的陷阱、性能考量以及在不同场景下的最佳实践。不少新手,甚至是有一定经验的开发者,在处理这类转换时,会因为忽略编码细节或错误处理而引入隐蔽的Bug。因此,这里结合多年实践经验,不仅提供完整的、可直接复用的源码,更要把这背后的门道讲清楚,让你知其然,更知其所以然,在未来的项目中能游刃有余。

2. 核心原理与设计思路拆解
2.1 ASCII码:字符世界的“身份证”系统
ASCII(American Standard Code for Information Interchange)可以理解为计算机早期为英文字符(包括控制字符)分配的一套标准数字编码。它用一个字节(8位)中的后7位(0-127)来表示128个字符,包括大小写英文字母、数字、标点符号和一些不可见的控制符(如换行、响铃)。
为什么是7位?因为在设计之初,通信中需要一位作为奇偶校验位来检测错误。对于字母‘A’,其ASCII码是65(十进制),二进制表示为 01000001 ;小写‘a’则是97。这个映射关系是固定且唯一的,构成了我们进行转换的基石。
在C#中, char 类型本质上是一个16位的Unicode字符(支持全球语言),但当我们处理纯英文环境或与遗留系统交互时,ASCII码依然是最通用、最高效的约定。我们的转换逻辑,核心就是将 char 类型的数据,映射到0-127这个整数区间。
2.2 转换场景与方案选型考量
在实际项目中,字母与ASCII码的转换需求通常出现在以下几个场景:
- 数据序列化与通信协议:自定义的二进制协议中,常用ASCII码值来标识命令类型或状态。
- 简单加密与编码:如凯撒密码、ROT13等古典密码,其操作对象就是字符的ASCII码。
- 硬件交互与数据解析:与单片机、传感器等设备通信时,接收到的原始字节流需要按ASCII规则解析为可读字符串。
- 字符串处理与校验:例如,判断一个字符是否为数字(ASCII码48-57)或字母(65-90, 97-122)。
基于这些场景,设计方案需要满足:
- 准确性:必须正确处理0-127范围内的字符,对于超范围的字符(如中文)要有明确的处理策略。
- 性能:转换操作应高效,尤其是在循环或高频调用的场景下。
- 易用性:提供清晰、直观的API,降低使用者的心智负担。
- 健壮性:考虑边界情况和异常输入,避免程序崩溃。
C#提供了多种方式进行转换,如强制类型转换 (int)‘A’ 、使用 Convert.ToByte 或 Encoding.ASCII 。下面逐一分析其原理和适用场景,并构建一个封装良好的工具类。
3. 核心方法实现与源码解析
3.1 基础转换方法:从char到int
最直接的方法是利用C#中 char 类型可以隐式转换为 int 类型的特性。当你将一个 char 赋值给 int 时,得到的是该字符的Unicode码点(code point)。对于ASCII字符(0-127),其Unicode码点与ASCII码值完全相同。
public static int CharToAsciiBasic(char character)
{
    int asciiCode = character;
    return asciiCode;
}
这个方法简单粗暴,但有一个致命问题:它对于任何 char 都会返回其Unicode码点。如果传入一个中文字符‘中’,它会返回20013,这显然超出了ASCII码的范围(0-127)。在需要严格ASCII转换的场景,这会造成错误。
因此,需要一个安全版本,对非ASCII字符进行约束或提示:
public static int CharToAsciiSafe(char character)
{
    if (character > 127)
    {
        // 处理策略1:抛出异常,让调用者明确知道输入不合法
        // throw new ArgumentOutOfRangeException(nameof(character), "字符超出ASCII范围(0-127)。");

        // 处理策略2:返回一个约定的错误码(如-1),更为温和
        return -1;
    }
    return (int)character;
}
注意:选择抛出异常还是返回错误码,取决于你的应用场景和错误处理策略。在库开发中,抛出异常更规范;在内部工具或性能敏感处,返回错误码可能更合适。
3.2 使用Convert类与Encoding.ASCII
.NET Framework提供了 Convert 类,其中的 ToByte 方法重载可以处理字符到字节的转换,而ASCII码本质上就是一个字节。
public static byte CharToAsciiViaConvert(char character)
{
    try
    {
        return Convert.ToByte(character);
    }
    catch (OverflowException)
    {
        return 0; // 或 throw new ArgumentException("字符值超出单字节范围。");
    }
}
另一种更“语义化”的方式是使用 System.Text.Encoding.ASCII 编码器。它的 GetBytes 方法会将字符串(或字符数组)转换为字节数组,转换过程中,任何非ASCII字符会被替换为‘?’(ASCII码63)。
public static byte CharToAsciiViaEncoding(char character)
{
    byte[] bytes = Encoding.ASCII.GetBytes(new char[] { character });
    return bytes[0];
}

public static string AsciiToStringViaEncoding(byte asciiCode)
{
    return Encoding.ASCII.GetString(new byte[] { asciiCode });
}
这种方法的好处是行为标准(符合ASCII编码规范),且内置了非ASCII字符的处理逻辑(替换为‘?’)。如果需要的是“尽最大努力得到ASCII表示”,这是一个不错的选择。
3.3 逆向转换:从int/byte到char
将ASCII码转换回字母相对直接,因为ASCII码值本身就在 char 的表示范围内。可以使用强制类型转换或 Convert.ToChar 。
public static char AsciiToCharCast(int asciiCode)
{
    if (asciiCode < 0 || asciiCode > 127)
    {
        throw new ArgumentOutOfRangeException(nameof(asciiCode), "ASCII码值必须在0到127之间。");
    }
    return (char)asciiCode;
}

public static char AsciiToCharViaConvert(byte asciiCode)
{
    return Convert.ToChar(asciiCode);
}
使用 Encoding.ASCII.GetString 进行逆转换如前所述,它更擅长处理字节数组到字符串的批量转换。
3.4 完整工具类源码实现
结合以上分析,这里提供一个健壮、实用且带有详细注释的工具类 AsciiConverter 。它提供了多种转换方式,并包含了实用的扩展方法,用于处理字符串。
using System;
using System.Linq;
using System.Text;

namespace AsciiConversionUtility
{
    public static class AsciiConverter
    {
        public static int ToAsciiCodeFast(char character)
        {
            return character;
        }

        public static byte ToAsciiByteSafe(char character, byte nonAsciiReplacement = 63)
        {
            if (character <= 127)
            {
                return (byte)character;
            }
            return nonAsciiReplacement;
        }

        public static char FromAsciiCode(int asciiCode)
        {
            if (asciiCode < 0 || asciiCode > 127)
            {
                throw new ArgumentOutOfRangeException(nameof(asciiCode), $"ASCII码值必须在0到127之间。提供的值:{asciiCode}");
            }
            return (char)asciiCode;
        }

        public static char FromAsciiByte(byte asciiByte)
        {
            return (char)asciiByte;
        }

        public static byte[] StringToAsciiBytes(string text)
        {
            if (string.IsNullOrEmpty(text))
                return Array.Empty();
            return Encoding.ASCII.GetBytes(text);
        }

        public static string AsciiBytesToString(byte[] bytes)
        {
            if (bytes == null || bytes.Length == 0)
                return string.Empty;
            return Encoding.ASCII.GetString(bytes);
        }

        public static int[] GetAsciiCodeSequence(string text)
        {
            if (string.IsNullOrEmpty(text))
                return Array.Empty();
            return text.Select(c => (int)c).ToArray();
        }

        public static bool IsPrintableAscii(char c)
        {
            return c >= 32 && c <= 126;
        }

        public static bool IsAsciiLetter(char c)
        {
            return (c >= 'A' && c <= 'Z') || (c >= 'a' && c <= 'z');
        }

        public static string Rot13(string input)
        {
            if (string.IsNullOrEmpty(input))
                return input;
            char[] array = input.ToCharArray();
            for (int i = 0; i < array.Length; i++)
            {
                int number = array[i];
                if (number >= 'a' && number <= 'z')
                {
                    if (number > 'm')
                        number -= 13;
                    else
                        number += 13;
                }
                else if (number >= 'A' && number <= 'Z')
                {
                    if (number > 'M')
                        number -= 13;
                    else
                        number += 13;
                }
                array[i] = (char)number;
            }
            return new string(array);
        }
    }
}
这个工具类涵盖了从基础转换到高级应用(如ROT13)的多个方面。 ToAsciiByteSafe 方法提供了安全转换和自定义替换策略; IsPrintableAscii 和 IsAsciiLetter 是常见的辅助判断方法; Rot13 则展示了ASCII码转换在简单加密中的一个经典用例。
4. 性能对比与最佳实践选择
不同的转换方法在性能和语义上各有侧重。为了有一个直观的感受,这里用基准测试的思路描述一下。
| 方法 | 适用场景 | 性能 | 安全性/说明 |
|---|---|---|---|
| (int)char | 需要Unicode码点,或确信输入为ASCII且追求极致性能。 | 最快 | 不检查范围,非ASCII字符会得到>127的值。 |
| Convert.ToByte(char) | 需要字节结果,且能接受0-255范围(扩展ASCII)。 | 快 | 如果字符值>255会抛出 OverflowException 。 |
| Encoding.ASCII.GetBytes | 需要标准的ASCII编码行为,自动处理非ASCII字符替换。 | 较慢(涉及编码器) | 最符合“ASCII编码”语义,非ASCII字符被替换为‘?’。 |
| 自定义安全转换(如 ToAsciiByteSafe ) | 需要严格控制输出在0-127,并有自定义的替换逻辑。 | 快(带分支判断) | 行为明确,易于理解和维护。 |
实操心得:
- 对于单次或低频转换:选择语义最清晰、代码最易读的方法,如
Encoding.ASCII或自定义安全方法。性能差异可忽略不计。 - 对于在紧密循环中处理大量字符(例如处理一个几MB的文本文件):应优先考虑性能。这时,使用
(int)char或经过优化的自定义方法(避免在循环内创建新数组或调用复杂编码器)会带来显著提升。可以先快速转换,再对结果数组进行一次性验证或清洗。 - 关于“扩展ASCII”:字节值128-255不属于标准ASCII,在不同编码(如ISO-8859-1, Windows-1252)中代表不同字符。如果数据源可能包含这些字符,务必明确约定编码方式,不能简单地用
(byte)char转换,而应使用指定编码的GetBytes方法。
5. 常见问题与实战排错指南
即使原理清晰,在实际编码中仍会遇到一些典型问题。下面是一份“避坑清单”。
5.1 中文或特殊字符转换后得到意外值
问题描述:将中文字符‘中’转换为ASCII码,期望得到错误提示或替换值,但使用 (int)‘中’ 却得到了20013。
根因分析: (int)char 转换的是Unicode码点,不是ASCII码。‘中’的Unicode码点正是20013。
解决方案:
- 如果业务逻辑要求严格ASCII,必须在转换前进行范围检查,使用工具类中的
ToAsciiByteSafe方法。 - 如果目的是获取字符的任何数字表示,那么使用
(int)char是正确的,但应明确命名该方法为ToUnicodeCodePoint以避免误解。
5.2 从网络或文件读取的字节转换乱码
问题描述:从串口、网络Socket或二进制文件读取的字节数组,用 Encoding.ASCII.GetString 解码后,某些字符显示为‘?’。
根因分析:数据源发送的字节流中包含了超出ASCII范围(0-127)的值。 Encoding.ASCII 解码器会将所有大于127的字节统一替换为‘?’。
排查步骤:
- 检查数据源:确认发送方是否真的发送的是纯ASCII文本。很多时候,数据可能是UTF-8或其他编码。一个UTF-8编码的中文字符由2-4个字节组成,每个字节都可能大于127。
- 核对协议:查阅通信协议文档,明确约定字符编码是ASCII、UTF-8还是其他。
- 十六进制查看:将接收到的原始字节数组以十六进制形式打印出来。例如,收到
[0xE4, 0xB8, 0xAD],这是UTF-8编码下‘中’字的字节序列,显然不是ASCII。正确的解码方式应是Encoding.UTF8.GetString(bytes)。
byte[] receivedData = ...;
string hexString = BitConverter.ToString(receivedData).Replace("-", " ");
Console.WriteLine($"收到字节: {hexString}");
5.3 转换性能在大量数据时成为瓶颈
问题描述:处理一个非常大的字符串或日志文件,逐字符转换感觉速度很慢。
优化策略:
- 批量操作,避免单次调用:不要对字符串中的每个字符单独调用 Encoding.ASCII.GetBytes (这会在内部创建大量单元素数组)。而是直接对整个字符串调用一次。
- 使用 Span
和 Memory :对于高性能场景,可以使用 Span和 Span 来操作,避免不必要的内存分配。
// 优化前:低效
foreach (char c in hugeString)
{
    byte b = AsciiConverter.ToAsciiByteSafe(c);
}
// 优化后:批量处理
byte[] asciiBytes = Encoding.ASCII.GetBytes(hugeString);
// 进一步优化:使用Span
ReadOnlySpan charSpan = hugeString.AsSpan();
- 并行处理:如果转换操作是计算密集型的且数据可分割,可以考虑使用
Parallel.For或Parallel.ForEach进行并行转换。但要注意线程安全和最终合并结果的开销。
5.4 控制字符的处理
问题描述:ASCII码中0-31和127是控制字符(如换行 \n (10),回车 \r (13),制表符 \t (9))。在转换和显示时可能需要特殊处理。
处理建议:
- 在调试输出时:直接转换控制字符可能显示为乱码或不可见。可以编写一个辅助方法,将控制字符转换为类似
\n、\t这样的转义序列字符串,便于查看。 - 在协议处理时:明确识别这些控制字符。例如,在解析文本行时,需要识别
\r\n作为行结束符。
public static string ToDebugString(byte asciiByte)
{
    char c = (char)asciiByte;
    if (c == '\n') return "\\n";
    if (c == '\r') return "\\r";
    if (c == '\t') return "\\t";
    if (asciiByte < 32 || asciiByte == 127) return $"[CTRL:{asciiByte}]";
    return c.ToString();
}
6. 扩展应用:构建一个简单的字符串ASCII分析器
为了将上述知识融会贯通,来实现一个稍微复杂点的工具:一个字符串ASCII分析器。它可以统计字符串中各类ASCII字符的数量,并生成一个简单的报告。
using System;
using System.Collections.Generic;
using System.Text;

namespace AsciiConversionUtility
{
    public class AsciiStringAnalyzer
    {
        public string Input { get; }
        private readonly int[] _asciiCount = new int[128];

        public AsciiStringAnalyzer(string input)
        {
            Input = input ?? string.Empty;
            Analyze();
        }

        private void Analyze()
        {
            Array.Fill(_asciiCount, 0);
            foreach (char c in Input)
            {
                int code = c;
                if (code >= 0 && code < 128)
                {
                    _asciiCount[code]++;
                }
            }
        }

        public int GetCount(int asciiCode)
        {
            if (asciiCode < 0 || asciiCode >= 128)
                throw new ArgumentOutOfRangeException(nameof(asciiCode));
            return _asciiCount[asciiCode];
        }

        public Dictionary GetPrintableStats()
        {
            var stats = new Dictionary();
            for (int i = 32; i <= 126; i++)
            {
                if (_asciiCount[i] > 0)
                {
                    stats[(char)i] = _asciiCount[i];
                }
            }
            return stats;
        }

        public string GetSummary()
        {
            var sb = new StringBuilder();
            sb.AppendLine($"字符串分析报告 (长度: {Input.Length})");
            sb.AppendLine($"ASCII字符总数: {TotalAsciiCharacters}");
            sb.AppendLine($"非ASCII字符数: {Input.Length - TotalAsciiCharacters}");
            sb.AppendLine();

            var printable = GetPrintableStats();
            sb.AppendLine($"可打印ASCII字符分布 (共{printable.Count}种):");
            foreach (var kvp in printable)
            {
                sb.AppendLine($"  '{kvp.Key}' (码值:{(int)kvp.Key}): {kvp.Value}次");
            }

            int controlCount = 0;
            for (int i = 0; i < 32; i++) controlCount += _asciiCount[i];
            controlCount += _asciiCount[127];
            if (controlCount > 0)
            {
                sb.AppendLine($"控制字符出现次数: {controlCount}");
            }

            return sb.ToString();
        }

        private int TotalAsciiCharacters
        {
            get
            {
                int total = 0;
                for (int i = 0; i < 128; i++) total += _asciiCount[i];
                return total;
            }
        }
    }
}
使用示例:
string testText = "Hello, World!\nThis is a test. 你好,世界!";
var analyzer = new AsciiStringAnalyzer(testText);
Console.WriteLine(analyzer.GetSummary());
这个分析器演示了如何利用ASCII码转换进行实际的文本分析。它在构造函数中一次性完成所有统计,后续查询都是O(1)复杂度,效率很高。可以根据需要扩展它,比如增加统计字母频率、找出最常用字符等功能。
7. 总结与个人体会
回顾整个字母与ASCII码转换的过程,从最基础的强制类型转换到考虑编码安全的 Encoding.ASCII ,再到封装成健壮的工具类和实用的分析器,其核心远不止于一行 (int)‘A’ 的代码。它关乎对数据本质的理解、对边界情况的处理以及对性能的细微权衡。
在工业上位机软件中,与老旧的PLC设备通信时,协议字段常常就是一个个ASCII码字符。一个字节解析错误,就可能导致整条生产线状态误判。那时,一个像 ToAsciiByteSafe 这样带有严格范围检查和明确替换策略的方法,比直接转换要可靠得多。而在处理日志文件、进行简单文本过滤时,追求极致的转换速度又变得至关重要。
所以,下次当你需要做字符和ASCII码转换时,不妨先问自己几个问题:数据源绝对可靠吗?需要严格限定在0-127吗?非ASCII字符出现时,是抛出错误、替换还是忽略?这个转换操作会被执行多少次?想清楚这些,选择最合适的工具和方法,这才是资深开发者应有的习惯。提供的完整源码只是一个起点,希望你能根据自己项目的实际需求,打磨出最适合自己的那一套字符处理工具。
加州大学圣地亚哥分校研究发现世界模型产生幻觉的根源是训练数据覆盖不足,归纳为感知幻觉、动作边缘化幻觉和场景发散幻觉三类,并提出三种预测信号及覆盖感知训练、针对性数据收集两种干预方案。
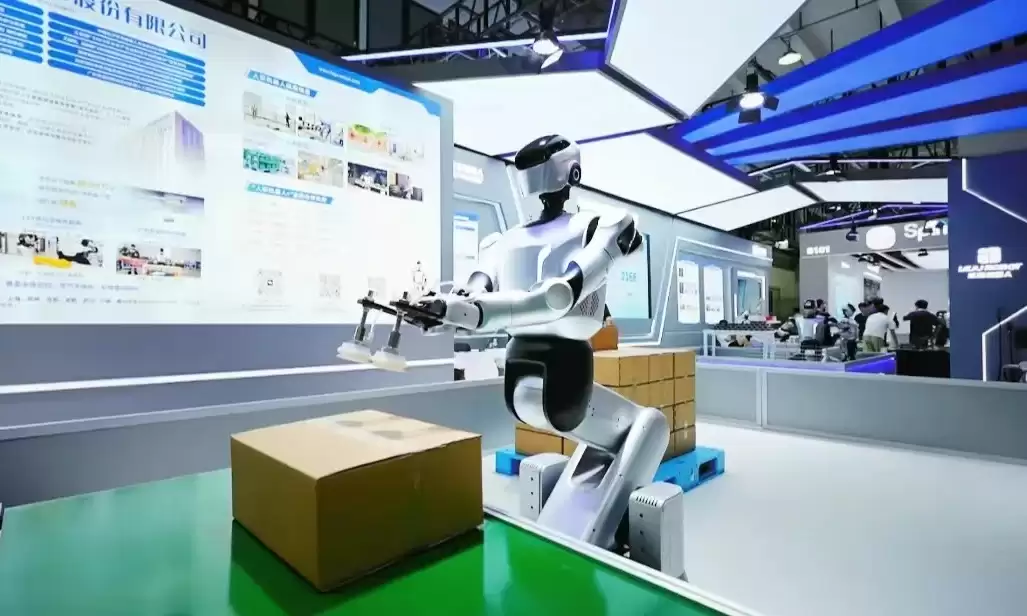
WRC 2026 乐聚「3+N」全场景实干方案亮相2026年8月20日,世界机器人大会(WRC)于北京盛大开幕。乐聚机器人此次带来了行业首发的全栈国产化「3 + N」批量部署行业解决方案,其展台更是本届展会中唯一能实现全场景、全自主、全天候机器人不停机作业的。该展台展示内容涵盖科研、商服、工业三大领
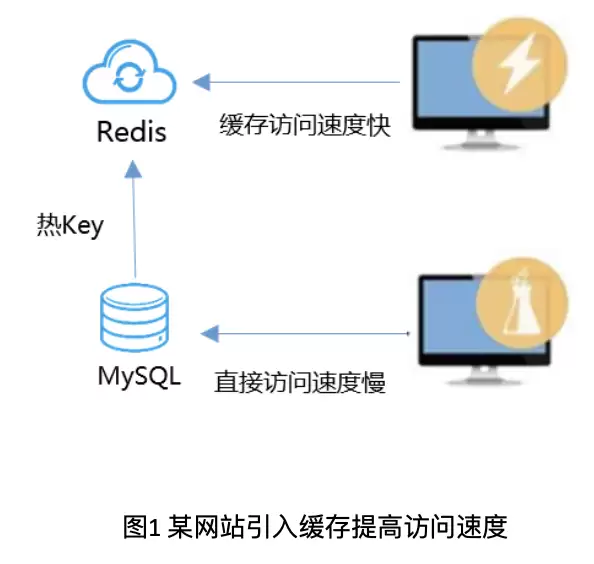
随着云计算十余年的高速发展,作为目前可见的最新阶段,多云正在快步大踏步前进。而多云趋势所带来得数据云间迁移,也逐步常态化。因此,缓存 Redis 已成为高并发场景下提升数据访问速度的标配。不仅是数据云间迁移,目前大型系统对于缓存强依赖,致使大多数企业都会面临大量并发读写数据时访问速度慢、数据库压力大
01、企业发布现状痛点目前企业在选择和实施发布策略时面临以下困境:缺乏云原生能力:由于从传统部署转变为云原生模式后,技术架构改造需要具备相关能力的人才。这使得企业在发布策略方面难以入手。缺乏自动化平台支持:即使找到适合产品现状的发布策略,仍然依赖手工逐步执行。这可能导致流程遗漏或人工操作失误,造成生
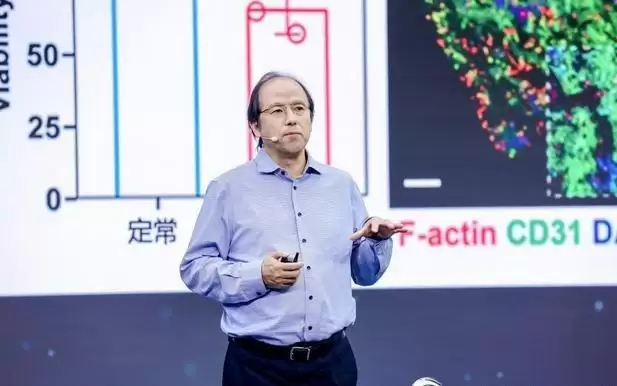
杨华勇院士等专家探讨组织器官生物制造前沿进展。我国发明专利和科研产出居世界前列,骨科植入物等已进入临床。预计未来5-6年功能性皮肤、15-20年大型脏器、30年复杂器官有望临床应用。AI赋能与伦理问题引发关注。
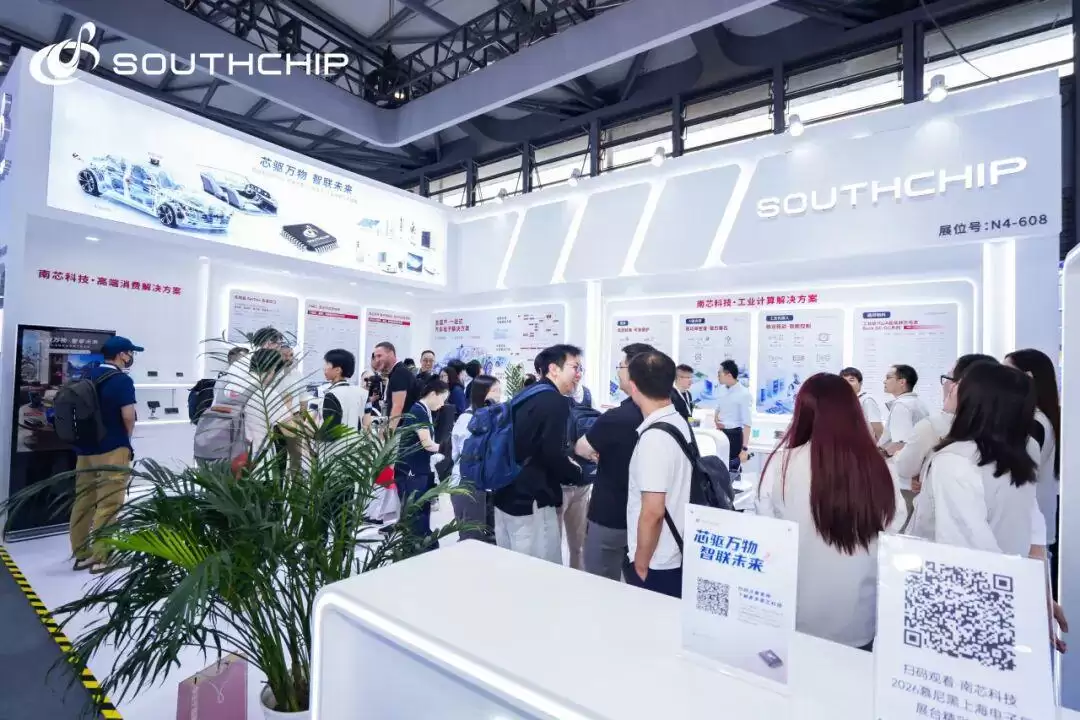
南芯科技在2026慕尼黑上海电子展展出高端消费电子、汽车电子等产品线,覆盖AI眼镜、机器人、智能手机、笔记本电脑、电视、可穿戴及移动电源等领域,提供从电源管理到电机控制的端到端解决方案。
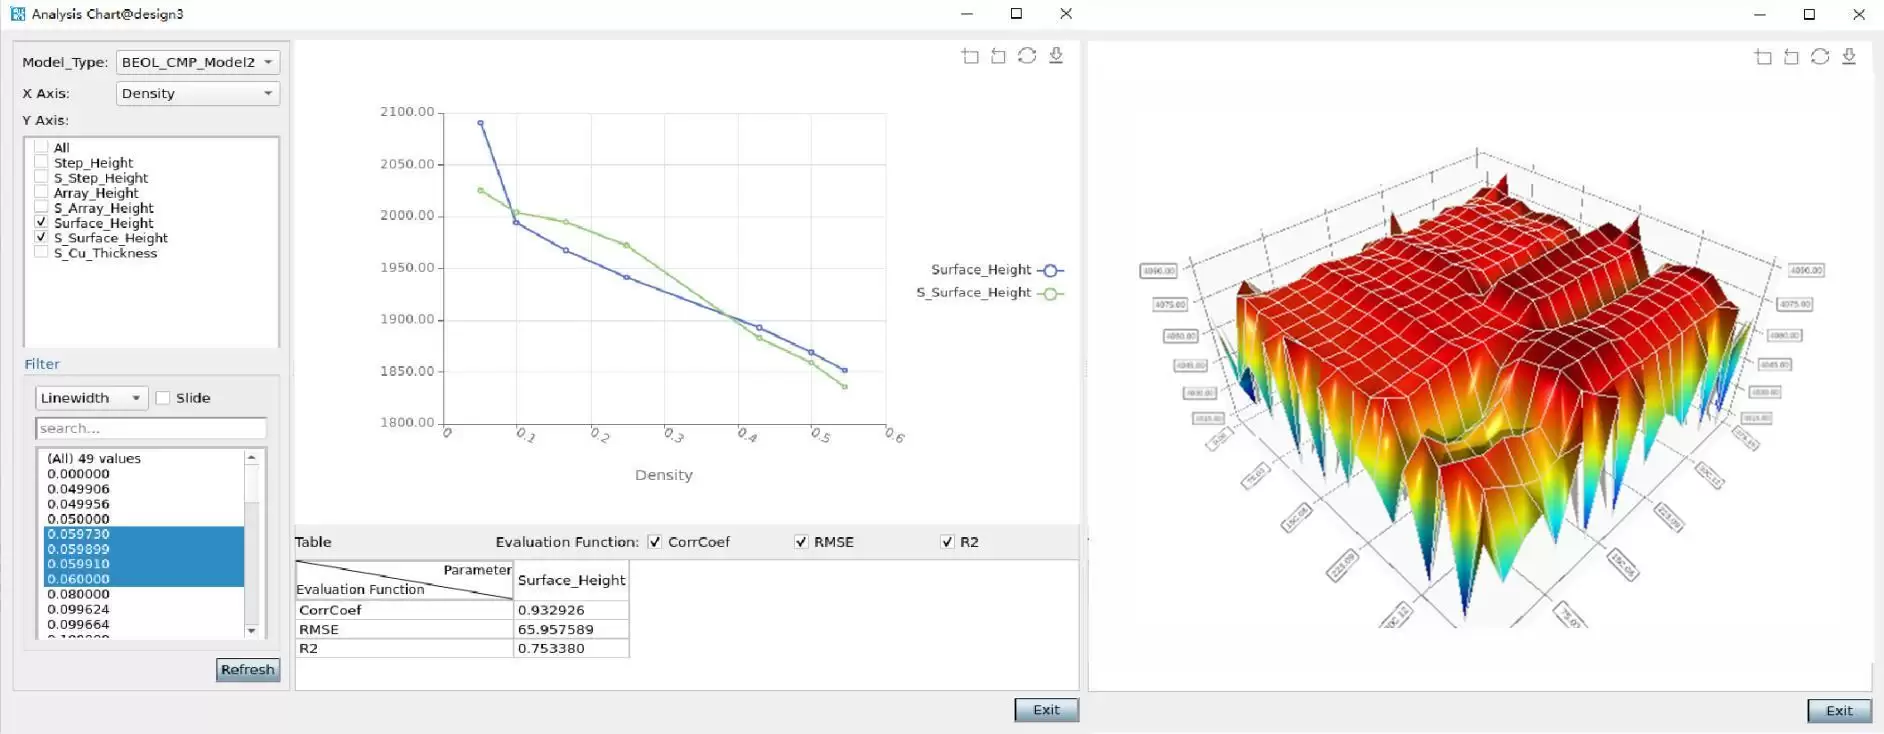
后摩尔时代,韬定律通过逻辑折叠、超细间距混合键合与TSV多层堆叠提升芯片性能,但面临键合缺陷、晶圆参数失配及DFT测试效率瓶颈。广立微打造涵盖DFM仿真、高速电性测试、AI晶圆配对及3D专用DFT的全链路国产方案,助力3DIC规模化量产。
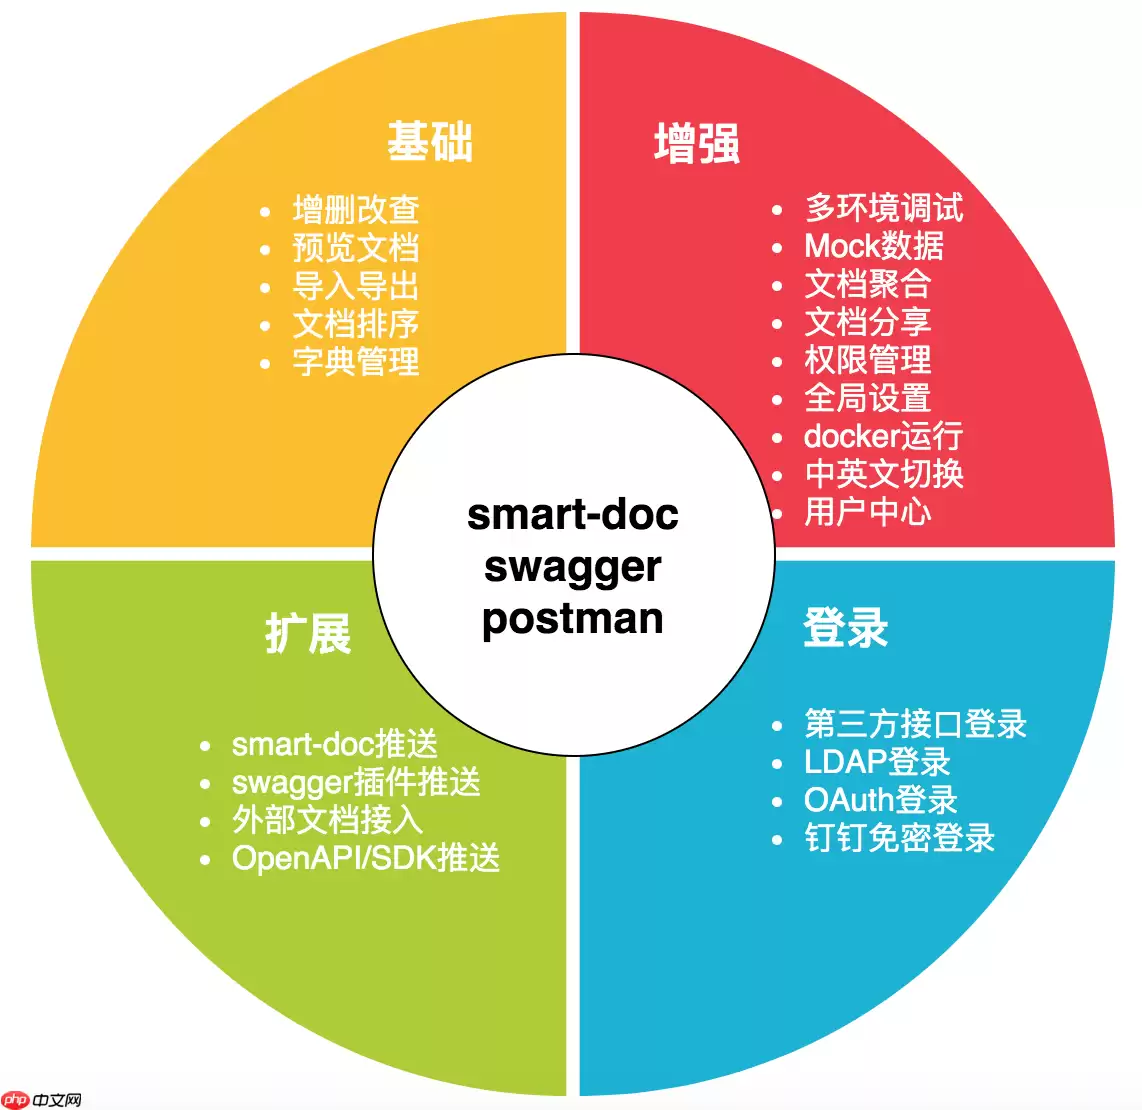
Torna1.35.6与2.1.20版本发布,优化单值返回结果展示逻辑,修复接口名称为空时Tab标签消失问题,新增点击接口名称跳转预览页面,改进Markdown渲染。Torna是一款接口文档管理工具,支持多人协同编辑、多源文档统一归档,扩展了Swagger的易用性与集成性。
遇到iPhone15上的应用删不掉?别急,可以先强制重启设备,或者查查是不是屏幕使用时间给限制了。如果这俩办法都行不通,那么通过电脑上的iTunes(Windows)或Finder(Mac)来恢复系统,通常是解决问题的终极方案。 iPhone15应用删除失败的原因分析 你的iPhone15突然“挽留
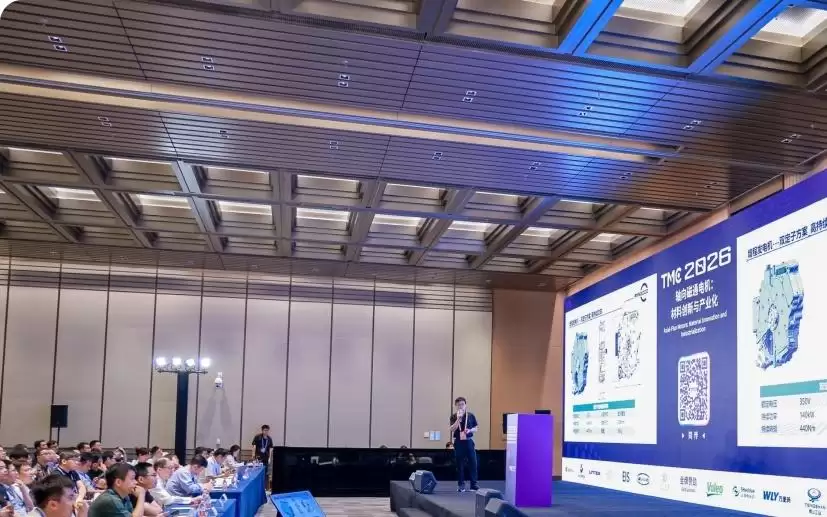
盘毂动力在TMC2026上宣布全球率先实现轴向磁通电机稳定规模化量产。该电机有效功率密度达25.73kW/kg,扭矩密度41.2N·m/kg,超92.5%工况效率达92.5%以上。产品覆盖9大产业赛道、100余类场景,销往30多国,并推出面向新能源车的全场景电驱方案,同等性能下减重超30%。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
