

“小芯片”胜过巨头“大芯片”,国产算力黑马祭出“并行计算”杀手锏
芯动力科技基于自研RPP架构推出全栈AI加速产品,通过分布式多芯片协同,将推理成本压至行业最优,覆盖云边端场景。其小芯片方案在医疗基因测序、AIPC等领域已落地,以成熟工艺实现超越大芯片的性能,为国产算力提供新路径。
大模型一路狂飙到现在,比拼绝对参数规模早就不是主流了。真正棘手的问题,是让AI高效落地,变成实实在在的生产力。
在这场落地浪潮里,Agent的爆发是个关键节点,直接把AI推理的需求推上了指数级暴涨的轨道。现在各种Agent不仅能处理复杂任务,甚至能把过去整个团队一两年才能啃下来的项目,压缩到“天级”完成。当AI终于能直接帮你赚钱,行业的关注点自然就从“谁囤的卡多、算力强”变成了“谁做得又快又好又省”。算力战场的主旋律,也正式从训练加速转向了推理。
面对这些复杂多元的AI推理场景,传统“大芯片”的算力方案开始显得有点力不从心。行业太需要更高效、更灵活、也更便宜的算力了。这恰恰是整个国产算力产业的新机会。
在一番摸索之后,行业慢慢发现,在很多AI推理落地的场景里,“小芯片”反而比“大芯片”更能打。就在这个行业拐点,国产AI算力黑马芯动力科技,在上海WAIC期间亮出了基于自研RPP(可重构并行处理器)架构的全栈AI加速产品矩阵,覆盖云、边、端。最吸引人的一点是,他们能把每10亿Token的推理成本压到行业最优水平,直击大模型落地的核心痛点。
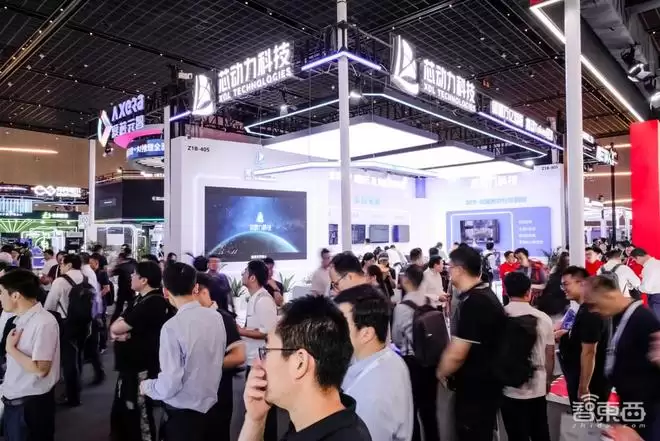
▲芯动力科技WAIC展台
一颗“指甲盖大小”的AE7100E芯片,可以12颗集成到一块加速卡里,这些加速卡又能无缝集成到企业级服务器中。基于8卡高密度服务器,能支持400B到1.6TB参数的LLM部署,单卡的超大显存是它的一大优势。
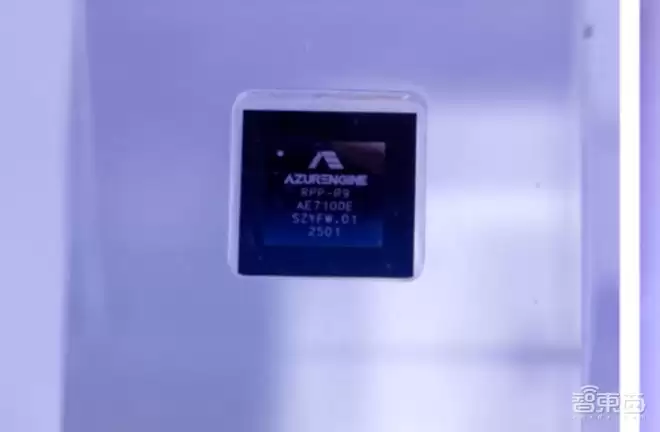
▲基于RPP架构的AE7100E芯片
WAIC期间,芯动力科技CEO李原首次对外详细解读了他们自研芯片如何覆盖云边端全场景的技术路径和背后的思考。把自研芯片AE7100E正式扩展到云端,是芯动力一次关键的战略升级,也是国产算力在AI推理浪潮中,于云端的一次重要突破。
一、AI编程爆发+开源生态带来巨大机遇,分布式计算成为大模型推理时代必然方向
芯动力很早就靠自研的RPP架构在国内算力圈打出了名声。虽然RPP架构本身就有原生灵活、兼顾通用与专用的特点,但选择在这个节点切入云端市场,其实基于他们对AI推理市场的几个关键判断。
李原提到,从去年底开始,大模型在AI编程上有了重大突破,他们团队自己也在深度使用。他发现,AI甚至能在一天内搞定CPU编译器这种“硬骨头”——以往需要专业团队几年才能完成的工作,现在几个小时就解决了。这太有碘伏性了。而且这种能力可以“技能化”,能快速复制到不同工作中。相比大模型闲聊或一些非必要场景,AI编程的商业目的非常明确,直接跟企业的“钱袋子”挂钩。
在芯动力看来,AI编程就是大模型推理落地的绝佳场景,这是个明确的未来方向,会成为所有人都要用的刚需。AI编程能直接转化为生产力,以标准化产品出现,变成每家公司的核心生产力工具。
与此同时,芯动力深入调研发现:全球数据中心大模型调用中,有55%发生在开源模型市场。这无疑是个巨大的机会,意味着AI编程不再是少数巨头独占的游戏,而是人人都能参与的生态。
AI推理核心场景的爆发,必然带来巨大的云端算力新市场,这也是芯动力当下把RPP芯片和解决方案扩展到云端的关键判断依据。
当然,看到趋势只是第一步,技术层面能不能做、能不能实现,还得有更准确的研判。入局新市场的成败,往往关乎企业的生死。芯动力通过深度技术调研发现,目前超大模型(400B以上)占据了70%的市场份额,没有任何单一芯片能把这些超大语言模型“独自吃下”。行业用分布式计算解决问题,已经是必然。
团队研究时发现,在大模型推理的PD分离(Prefill-Decoding)阶段,高算力芯片存在巨大资源浪费:解码阶段所需算力数据比是1:1,但英伟达计算卡提供的算力数据比大约1000:1。这就好比“需要1个人干的工作,派了1000个人来”,整个算力“流水线”上会形成大量闲置和浪费,也推高了方案的成本。
在Token经济时代,面对激烈竞争,相比盲目追求昂贵的高容量HBM,性价比才是最关键的决定性因素。经过大量计算和研究,芯动力团队发现,大模型推理真正需要的是三个核心要素:容量大、带宽足、成本低。相比HBM,成熟的LPDDR技术表现不错,未来甚至更好。
在这样的前提下,分布式思路可能是更正确的方向,能大幅降低成本。数据中心领域的发展已经证明了这一点,英伟达收购Groq,其底层技术原理就是用上百颗、上千颗芯片分布式地跑一个大模型。分布式计算之所以高效,是因为它把每个硬件节点都变成了更专业化的应用,进行专业化分区,硬件效率就会大幅提升。
值得一提的是,云巨头需要动用几百台服务器构建庞大集群,才能从宏观上完成这种专用化分区。而芯动力的芯片体积小,单块板卡就能集成十多颗芯片,在单台服务器内部就能实现极度精细的专用化分区,更灵活,这也是芯动力做分布式计算的差异化优势。
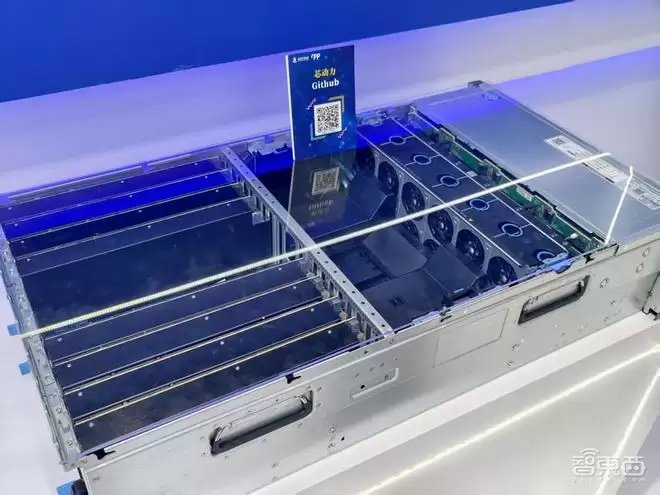
▲基于芯动力RPP架构芯片智能加速卡打造的机架服务器
在逐步摸清底层技术逻辑后,分布式计算自然就成了芯动力全力攻克的方向,而且团队发现既有问题都可以被克服,他们能基于RPP架构做出真正契合市场需求的产品。从对市场趋势和需求的深度观察,到技术层面找到可行路径,芯动力在AI推理时代找到了属于自己的关键机会,也探索出了一条潜力巨大的新路径。
二、多芯片协同SRAM优势凸显,RPP架构让芯片兼顾“通用”与“专用”,成熟工艺实现先进性能
路径明确了,接下来就是解决技术问题,让方案落地,并真正带来差异化优势,让“小芯片”展现出“大能力”。
全球芯片领域的传奇架构师、现任AI芯片公司Tenstorrent CEO的“硅仙人”吉姆·凯勒(Jim Keller)近期提到,AI推理中,不管芯片计算能力多强,对SRAM(片上缓存)的需求都是极强的。实际上,SRAM总量低,是导致很多“大芯片”实际场景表现差的关键因素之一。而芯动力在设计之初,就为芯片规划了比较大的SRAM容量。
单颗芯片的SRAM规模与英伟达H200相差并不多,但大量芯片组合、堆叠后,系统SRAM的总量据称能达到H200的10倍以上,这非常可观。当大量芯片协同跑起来时,系统整体带宽、通讯带宽等都会呈线性增长。这也证明,一味追求用最大、最顶级的单体芯片去实现大模型推理落地,不见得是唯一的最佳方案。中型、小型芯片分布式协同并行解决问题时,对单颗芯片的带宽、通讯、制程以及容量的要求都会随之降低。
当然,多芯片如何高效协同并非易事。但用李原的话来说,系统协同与通讯恰恰是芯动力的老本行,他们是做通讯出身的,目标十分明确:“多芯片间的协同和通讯,芯动力一定要做到极致”。在实际研究过程中芯动力发现,优秀的通讯并不意味着带宽越高越好,而是通讯的拓扑结构必须契合算法的网络架构,这是核心关键。大模型网络架构是有序的,研发人员可以在网络拓扑上找到特定路径,让硬件网络结构完美地适配算法的数据通讯,这也是像Groq这类公司能做好的底层技术原理,其分散的上千颗芯片适应了Transformer的网络流向。
在实现多芯片分布式协同计算的过程中,芯动力自研的RPP架构发挥了至关重要的作用,很好地解决了专用与通用特性的兼顾。
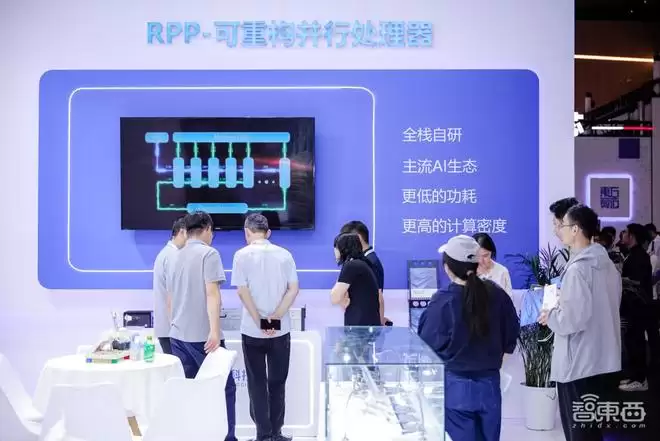
具体来看,RPP芯片在系统不同的位置、不同节点,起到的作用不一样,有一定“专用化”特征。但要让一颗芯片在物理上做到如此专用,实际上很困难。芯动力采取的方法是利用RPP的可重构特性,在软件层面进行动态调整,使得硬件在处理每一件具体任务时,都能激发出不亚于专用芯片的性能——无论在什么时间、什么位置,都能把芯片性能发挥到最大,这就是可重构架构在性能上的最优解。要知道,当前AI模型变化很快,如果能用相对通用的计算能力,通过调整软件来适应可变化、可重构的计算本身,是非常关键且极具价值的。
生态兼容性方面,RPP架构也能帮客户省去后顾之忧。它的独特之处在于直接构建在CUDA语言生态系统之上,能直接用CUDA编译运行程序,使其既有专用芯片(TPU)的高能效、低功耗,又避开了专用芯片缺乏生态的短板。
芯动力认为,如果想让一颗芯片同时具备极强的兼容性、极高的灵活性,并且拥有降维打击般的性价比,统一算力架构就是实现这一目标的必由之路。而RPP架构正完美兼顾了这些特点。芯动力会坚持做“可编程、可重构”芯片,AI推理市场技术迭代迅速,通用和可编程的并行计算能力依然占据绝对重要地位。
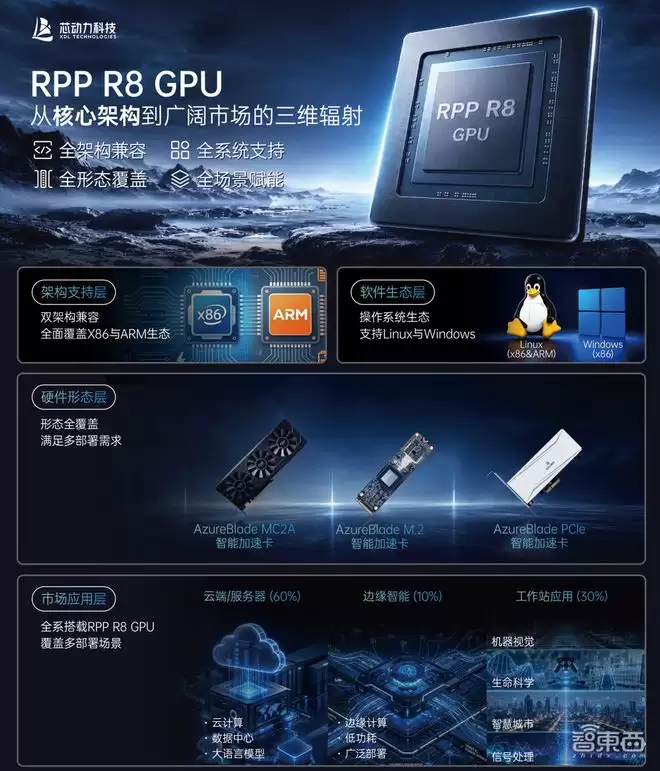
值得一提的是,如此“多面手”、表现胜过一些顶级“大芯片”的全能GPU芯片,可以基于成熟的14nm工艺实现。这极大提升了其供应的稳定性和产能上限,并进一步放大了性价比优势。从纯粹的商业成本和晶体管性价比来看,最高的工艺制程往往不是成本最优、成效最好的。作为一家芯片设计公司,正确的路径是选择最适合当前商业闭环和应用场景的成熟工艺。
关于下一代芯片,芯动力透露,已经充分验证了分布式计算的巨大优势,会沿着这条路继续深化,“会把之前受限、没能完全做透的地方彻底推过去”,下一代产品预计在性价比和核心性能上实现4倍左右的巨大提升。
三、从医疗到消费电子,商业化落地提速,死磕并行计算把细节做到极致
一系列技术细节的攻克和优化,最终让芯动力自研芯片有了拓展至云端并实现差异化优势的底气。在商业化落地层面,芯动力也透露了不少新进展。基于AE7100E的边、云解决方案,进一步凸显了其全场景落地的价值和潜力。
在WAIC展会现场,能看到基于RPP R8 GPU的解决方案已经覆盖了智慧城市、机器视觉、AI PC/NAS以及生命科学等前沿领域。
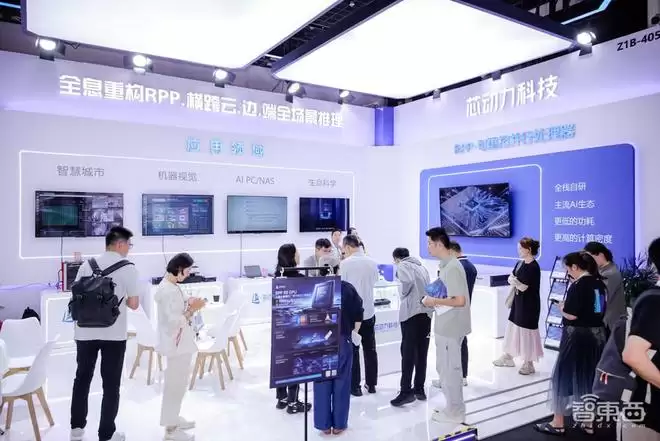
其中极具代表性的,是芯动力通过一块集成了12颗AE7100E芯片的板卡,与一家美国客户深度合作,实现了医疗基因测序的方案落地。最终方案的实际表现,已经超过了使用英伟达5nm芯片的同类产品——而这一方案中的芯片,使用的正是成熟的14nm工艺。
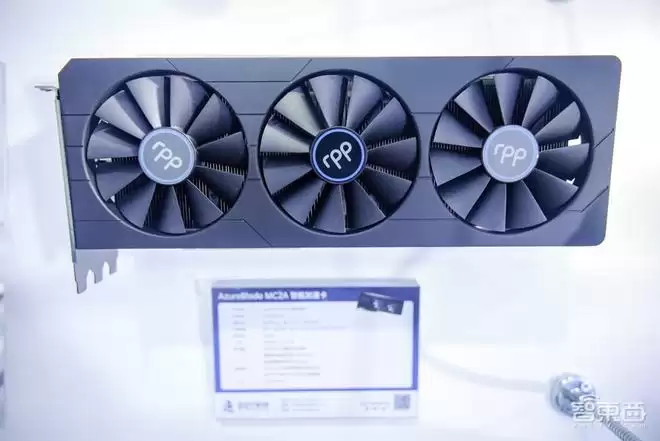
▲在医疗基因测序领域完成落地的AzureBlade MC2A智能加速卡
在交流中了解到,在这一医疗基因测序方案的落地过程中,他们发现这一领域的数据流非常明确,不需要复杂全局网络交换。在这样高度并行的结构下,“小芯片”分布式架构是最优的。那如果面对更复杂的结构——比如大模型这种芯片之间不能简单分开、存在大量数据交换和强烈数据依赖性的场景,是否也能做到?调研和实践证明,答案依然是肯定的。团队研究发现,只要仔细研究并抓住其有序、有规律的数据流向,分布式架构同样能完美胜任。只要能把数据的并行切分好,让它在每一颗芯片上高效完成,分布式就是最优解。
在挑战更高的AI PC/NAS应用场景中,芯动力已经与全球PC领域头部厂商联想实现了深度合作,基于芯动力AE7100E打造的M.2形态产品成功应用于其AI PC产品,这背后的故事令人印象深刻。
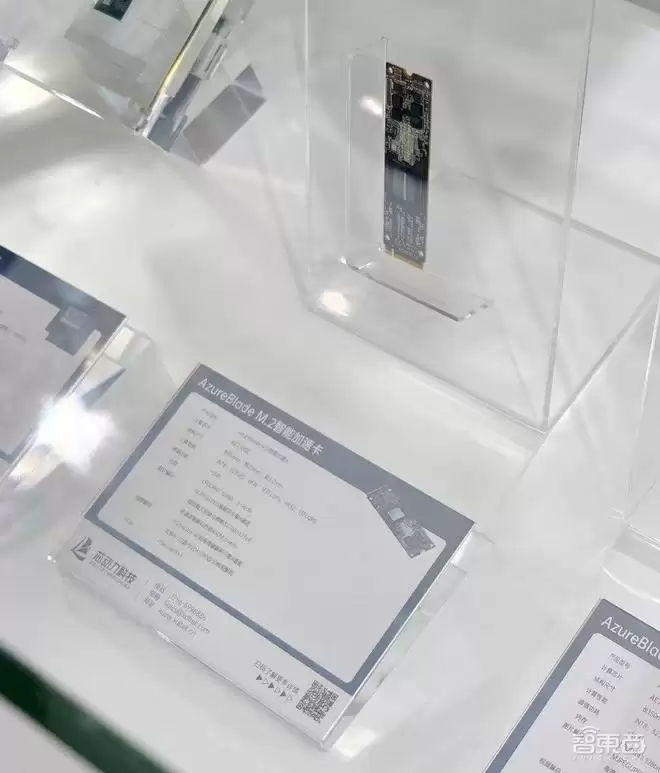
▲应用于AI PC/NAS领域基于AE7100E芯片的M.2规格智能加速卡
芯动力提到,像联想这样的国际化大厂非常严谨,他们在全世界范围内密集筛选,测试了所有能找到的芯片公司方案,前后一共测试了大约80家芯片厂商。在经历极其严苛的筛选后,芯动力成了最终唯一的芯片量产供应商。
很多人喜欢问“技术壁垒”是什么,但在李原看来,尤其是在芯片设计领域,建立技术壁垒绝非易事,它或许不是某一个单点的突破,而是体现在每一个近乎苛刻的细节里。就以这次通过测试为例,有些竞品可能在某些方面也能达到标准,但无法在每个环节都做到最好。用李原的话来说,“前期没有长期的技术预备和积累,当世界级大厂的战略机会来临时,你是根本接不住的。”李原特别提到了苹果公司,在他看来,在芯片设计领域,可能也有人能做到单点,但苹果把每一个微小的细节都做到了极致,这是最终其芯片能每年在数亿设备中落地并稳定运行、带来独特优势体验的关键。而芯动力的特点,正是同样的死磕极高的工程细致度。
面对未来,李原给公司的核心定位,就是在并行计算领域做到最好。团队坚信,这是继CPU之后,人类整个信息产业演进中面临的最大、最核心的市场。如今AI正进一步分化出千姿百态的细分推理场景,很多公司都在努力通过小芯片的思路来应对各种大模型推理需求。这是一个极具想象力的时代趋势,蕴藏着无数的机会。“其决胜关键在于谁能抓得住,能把每一个细节都做到位,在真实的商业场景中脱颖而出。符合浪潮,顺应趋势,才能真正做大。”李原说道。
结语:AI推理落地浪潮澎湃,深耕并行计算给行业提供新解
从在全球80家芯片厂商中脱颖而出,成为联想AI PC的唯一AI芯片供应商,到在基因测序领域用成熟工艺自研芯片板卡,打赢巨头的先进制程方案,芯动力用一系列扎实的商业成果,验证了其RPP架构的独特优势和商业价值。放眼AI算力产业,开源生态加速生长,以AI编程为代表的大模型推理应用加速成熟,效率和成本成为业内更关注的焦点。谁能在竞争中提供更具性价比的方案,谁就是胜出的关键。在并行计算这个潜力巨大的方向上,以珠海芯动力RPP为代表的分布式算力技术路线,正展现出旺盛的生命力。此次向云端的扩展,不仅是其自身战略版图的进一步完善,也给国产算力芯片在AI推理市场中突围,提供了新的方向和思考角度。
CyclicBarrier 与线程池:复杂并行计算中的“分工+协同”实战 在实际的多阶段并行计算中,CyclicBarrier 和线程池是一对黄金搭档。线程池负责干活儿的资源复用与任务调度,CyclicBarrier 则专注于让多个线程在关键节点上集体等待、同步推进。它不替代 CountDownLa
工作窃取算法通过双端队列实现LIFO执行与FIFO窃取,提升CPU密集型任务的整体吞吐量而非单次执行速度。合理设置任务拆分阈值(算术类10万以上,随机访问1万以内),使窃取次数占总任务数5%–30%。默认使用公共池,避免在任务中引入IO或锁操作,并确保子任务耗时大于10微秒。
多核处理器需合理分配任务以提升性能。静态分配适合任务均匀场景,实现简单但缺乏灵活性;动态分配通过任务队列和工作窃取适应运行时变化,负载均衡好但开销大;混合策略结合静态划分与动态调度,兼顾效率与平衡,配合任务粒度优化和性能监测可最大化资源利用率。选择策略应根据应用特征与硬件架构,实现任务与资源的精细匹配。

在现代计算机领域,随着数据规模不断增大,传统的串行计算方式已经不能满足我们日益增长的计算需求。为了提高计算速度和效率,我们需要使用并行计算技术来充分利用多核和分布式计算资源。而Go语言作为一门具有高并发、高效、原生支持并发等特性的语言,为我们提供了很好的并行计算解决方案。本文将介绍如何利用Go语言实现高效的并行计算。一、并发和并行在将来的讨论中,我们
在量子计算领域,python已经成为一种流行的编程语言。它简单易学,具有丰富的库和工具,使其非常适合量子计算的开发和研究。Python在量子计算中的优势Python在量子计算中具有许多优势,包括:简单易学:Python是一种简单的编程语言,即使是初学者也可以快速掌握。这使得它成为学习量子计算的理想选择。丰富的库和工具:Python拥有大量用于量子计算的库和工具,这可以帮助开发者快速开发和测试新的想法。灵活性:Python是一种非常灵活的语言,可以轻松扩展以满足不同的需求。这使得它非常适合量子计算领域快速发
随着互联网的快速发展,大规模分布式系统的需求越来越高,而并发编程和并行计算也成为了互联网开发者所必须掌握的技能。而Go语言正是一门为支持并发而生的语言,它在并发编程和并行计算方面的表现非常优秀。本文将介绍Go语言的并发模式和并行计算,并给出一些实际案例来帮助读者深入理解。一、Go语言的并发模式Go语言的并发模式主要基于goroutine和channel两个基
如何在Java中使用并行流函数实现并行计算随着计算机处理能力的提升,我们常常需要针对大规模数据进行计算。为了提高计算效率,Java引入了并行流函数,可以在多线程的环境下对数据进行并行处理。在这篇文章中,我们将介绍如何在Java中使用并行流函数实现并行计算,并给出具体的代码示例。并行流函数是Java8引入的一种新特性。它可以通过将数据流分成多个子流,在多个线
如何利用Python脚本在Linux系统中实现并行计算,需要具体代码示例在现代计算机领域,对于大规模数据处理和复杂计算任务,使用并行计算可以显著提高计算效率。Linux作为一个强大的操作系统,提供了丰富的工具和功能,可以方便地实现并行计算。而Python作为一种简单易用且功能强大的编程语言,也有许多库和模块可以用于编写并行计算任务。本文将介绍如何利用Pyth
如何在Python中进行并行计算和分布式计算随着计算机技术的不断发展和硬件性能的提升,利用多核处理器进行并行计算和分布式计算已成为提高程序性能的重要手段之一。而Python作为一门简洁易用且功能强大的编程语言,也提供了丰富的库和工具来支持并行计算和分布式计算。本文将介绍如何在Python中进行并行计算和分布式计算,并给出具体的代码示例。一、并行计算在Pyth
Golang开发:实现并行计算的最佳实践,需要具体代码示例概述:并行计算是一种在计算机科学中广泛应用的技术,它可以通过同时执行多个任务来提高程序的性能和效率。Golang是一种支持并发编程的编程语言,它内置了丰富的并发原语和库函数,使得并行计算的实现变得更加简单和高效。本文将介绍一些Golang中实现并行计算的最佳实践,并给出具体的代码示例。并行计算的概





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



