

小鹏集团发布TuringViT,宣称重构视觉大模型训练范式
小鹏集团发布TuringViT高效视觉编码器,通过线性注意力主导、高质量数据治理与原生动态分辨率三大技术,仅用0.85B图文对训练即在多项基准上超越10B数据基线,全面支撑智能驾驶、智能座舱及人形机器人场景。
小鹏集团今天发布了一款名为 TuringViT 的高效视觉编码器,这可不是一次普通的迭代——它从架构设计、数据范式到训练流程,几乎是针对 VLM/VLA 时代做的系统性重构。
有意思的是,TuringViT 的定位不仅仅局限于智能驾驶。根据官方说法,它将全面支撑智能驾驶、智能座舱,以及小鹏的 IRON 人形机器人这三个业务场景。换句话说,这是一个为“视觉大模型普惠化”铺路的技术路径,目标是把过去只有头部团队才能玩转的 SOTA 级视觉 Transformer,推向更广泛的行业应用。
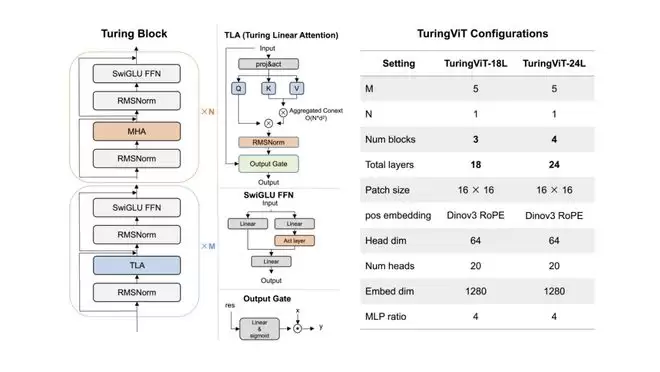
▲ TuringViT 的块架构和模型配置
从技术层面来看,TuringViT 的突破点是“线性注意力主导 + 高质量数据治理 + 原生动态分辨率”这三个维度的同步推进。简单说,就是既要效果好,又要反赌,还得能落地。
它目前推出了两个规格版本:
一个是 TuringViT-18L,包含 3 组 Turing Block(共 15 层 TLA + 3 层 MHA),主打动态分辨率下的高效部署;另一个是 TuringViT-24L,包含 4 组 Turing Block(共 20 层 TLA + 4 层 MHA),在保持线性计算主导的前提下,进一步提升了表征能力。
实测数据很能说明问题。随着输入分辨率提升,TuringViT 的延迟增长曲线比标准 softmax ViT 平缓得多,高分辨率下的效率优势愈发显著。在 1536×1536 分辨率下,TuringViT-18L 的推理吞吐量达到了 Seed1.5-ViT 的 3.04 倍,相比 SigLIP2-ViT-L 也提升了 2.16 倍。这个成绩,直接为高分辨率感知、多摄像头输入、长时序视频处理的端侧部署扫清了核心障碍。
不过,真正值得关注的,是它在数据方面的思路。行业里常见的做法是“堆数据规模”,但 TuringViT 走了一条完全不同的路。它打造了一套名为 VISTA-Curation 的多模态数据治理流水线,核心逻辑是:通过提升单样本的监督价值,实现数据效率的量级提升——从“用更多数据”转向“用更优质的监督”。
针对图文数据,这套流水线通过三步精细化筛选来保证质量:
第一步,过滤掉低分辨率、模糊、低纹理的低质量图片;第二步,通过多模型、多提示词生成多样化候选字幕,并交叉验证视觉一致性;第三步,在统一对比池中,根据相对图文对齐度、文本信息量、歧义度综合打分,筛选出视觉贴合度高、语义信息密度高的优质标注,同时淘汰掉那些模糊、泛化、弱对齐的样本。
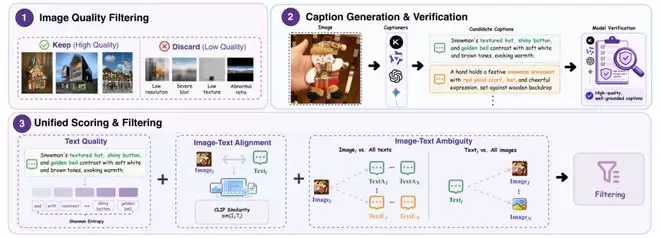
▲ 图像-文本筛选及处理流程
针对视频数据,流水线同样进行了全流程治理:先是将长视频切分为连续短片段并均匀采样代表帧;再通过语义一致性与运动一致性双重过滤,保留语义连贯、变化信息有效的片段;最后融合局部帧级细节字幕与全局时序语义字幕,生成具备变换感知能力的视频标注,让模型能从连续画面中学习更鲁棒的视觉表征。
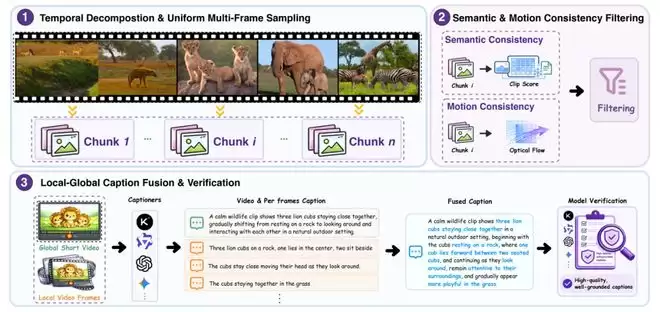
▲ 视频-语义筛选及处理流程
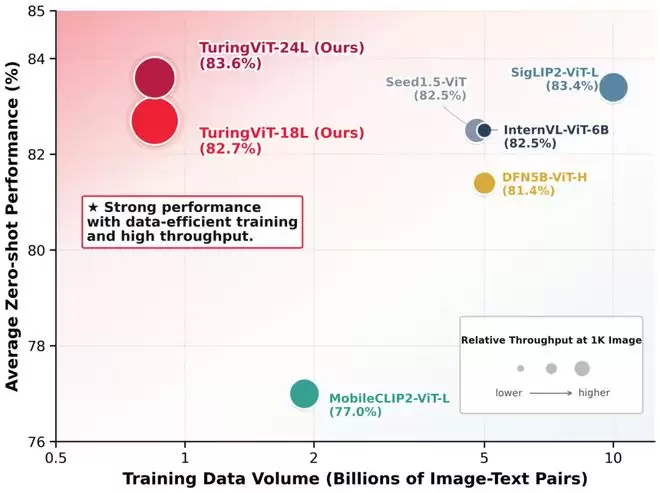
最终结果很有说服力:TuringViT 仅用 0.85B 图文对进行训练(这大约是 SigLIP2-L 训练数据规模的 10%),就在 ImageNet-1K 等六项零样本分类基准上,取得了 83.6% 的平均准确率,超越了使用 10B 数据训练的主流开源基线。在 COCO、Flickr30K 图文检索任务上,优势同样显著——这才是真正的“十分之一数据,更优效果”。
此外,TuringViT 还采用了四阶段渐进式原生动态分辨率训练范式。从预训练之初就适配下游 VLM/VLA 的输入特性,彻底告别了“固定分辨率预训练 + 事后适配”的传统模式。
在应用场景上,TuringViT 的布局相当清晰:在智能驾驶领域,它是第二代 VLA 模型的核心视觉编码器,负责处理多路环视摄像头的高分辨率、多帧动态道路场景输入,为预测式世界模型提供视觉 token;在智能座舱与驾泊一体化场景中,它的 VLM 原生特性让视觉特征与语言模型实现了更高效的对齐,能提供更高的识别精度,以及不同画幅和比例的视觉输入,支撑更多未来车辆与用户的交互功能;而在小鹏 IRON 人形机器人的技术体系中,TuringViT 则充当着“视觉视网膜”的核心角色,为具身智能提供物体细粒度识别、空间关系理解、可操作区域检测、动态环境追踪等基础感知能力。
答案:使用scikit-learn训练模型需经历数据准备、模型选择、训练与评估。以鸢尾花数据集为例,通过加载数据、划分训练测试集、选择逻辑回归模型、训练、预测及评估完成流程。初学者宜从逻辑回归、决策树、KNN等易理解的模型入手。数据预处理至关重要,常用方法包括标准化、归一化、缺失值填充和独热编码,Pipeline与ColumnTransformer可整合预处理步骤。为避免过拟合,可采用正则化、交叉验证、简化模型或增加数据;应对欠拟合则需提升模型复杂度或特征数量。
文本分类是自然语言处理(NLP)任务之一,它旨在将文本归类到预定义的类别中。文本分类有很多实际应用,例如电子邮件过滤、垃圾邮件检测、情感分析和问答系统等。使用pythonNLTK库完成文本分类的任务可以分为以下几个步骤:数据预处理:首先,需要对数据进行预处理,包括去除标点符号、转换成小写、去除空格等。特征提取:接下来,需要从预处理后的文本中提取特征。特征可以是词语、词组或句子。模型训练:然后,需要使用提取的特征来训练一个分类模型。通常使用的分类模型包括朴素贝叶斯、支持向量机和决策树等。评估:最后,需要对训

随着机器学习的广泛应用和深度学习的不断发展,高效的模型训练和验证逐渐成为一个非常重要的问题。Go语言是一种开发高效、可靠、简洁的系统级编程语言,其在计算机科学领域的应用日益广泛。本文将介绍如何在Go语言中实现高效的模型训练和验证。一、Go语言与机器学习Go语言作为一种系统级编程语言,被广泛应用于Web应用、网络编程、云计算等领域,并且近年来在机器学习领域也逐
Python底层技术揭秘:如何实现模型训练和预测,需要具体代码示例作为一门易学易用的编程语言,Python在机器学习领域中被广泛使用。Python提供了大量的开源机器学习库和工具,比如Scikit-Learn、TensorFlow等。这些开源库的使用和封装为我们提供了很多便利,但如果我们要深入了解机器学习的底层技术,仅仅会使用这些库和工具是不够的。本文将深入
数据稀缺对模型训练的影响问题,需要具体代码示例在机器学习和人工智能领域,数据是训练模型的核心要素之一。然而,现实中我们经常面临的一个问题是数据稀缺。数据稀缺指的是训练数据的量不足或标注数据的缺乏,这种情况下会对模型训练产生一定的影响。数据稀缺的问题主要体现在以下几个方面:过拟合:当训练数据量不够时,模型很容易出现过拟合的现象。过拟合是指模型过度适应训练数据,
如何在PHP微服务中实现分布式算法和模型训练引言:随着云计算和大数据技术的快速发展,数据处理和模型训练的需求越来越大。分布式算法和模型训练是实现高效、快速、可扩展性的关键。本文将介绍如何在PHP微服务中实现分布式算法和模型训练,并提供一些具体代码示例。一、什么是分布式算法和模型训练分布式算法和模型训练是利用多台机器或者服务器资源同时进行数据处理和模型训练的技
本文将介绍微信基于PyTorch进行的大规模推荐系统训练。推荐系统和其它一些深度学习领域不同,仍在使用Tensorflow作为训练框架,被广大开发者诟病。虽然也有使用PyTorch进行推荐训练的一些实践,但规模较小,也没有实际的业务验证,很难推动业务尝鲜。2022年2月,PyTorch团队推出了官方推荐库TorchRec。我们团队在5月开始在内部业务上尝试TorchRec,并且与TorchRec团队展开了一系列的合作。在几个月的试用过程中,我们体会到TorchRec非常
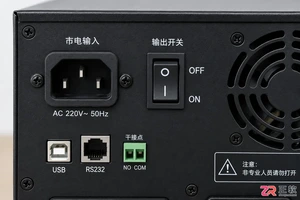
当UPS发出蜂鸣警报或断电后无法支撑设备时,通常只需更换内部蓄电池。本教程提供详细的安全断电、拆卸旧电池、连接新电池的操作步骤及注意事项,帮助用户自行完成维护。
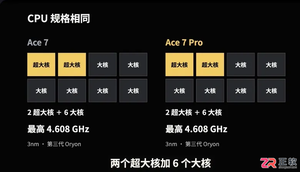
了解一加 Ace 7 与 Pro 的核心配置差异。本文详细对比两款机型的 CPU 规格、GPU 切片数量对图形性能的影响,以及主摄、超广角与长焦镜头的不同组合,结合视频中的游戏测试数据,为您提供选购参考。
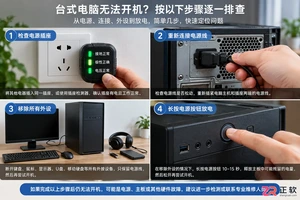
电脑按开机键没有任何反应,指示灯不亮且风扇不转?本指南教你逐步检查插座供电、重新插拔电源线、移除外设进行静电释放复位,以及判断内部电源模块故障,帮助你快速定位问题或安全送修。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



