

ai人工智能培训 常见报错与处理办法汇总
人工智能项目实践中,常见问题涉及环境配置、数据处理、模型训练及部署。环境问题需检查依赖与驱动;数据处理应注意路径与维度;训练时可调整学习率应对收敛问题;显存不足时可减小批次;部署时需确保格式兼容与预处理一致,容器化有助于环境稳定。
环境配置与依赖问题引发的报错
在开始人工智能项目实践时,环境配置是首要步骤,也是最容易遇到问题的环节。一个常见的错误是“ModuleNotFoundError: No module named 'xxx'”,这通常意味着所需的Python库没有安装。解决方法是使用pip或conda等包管理工具进行安装,例如执行“pip install xxx”命令。在安装特定版本时,需要注意版本兼容性,过新或过旧的版本都可能与其他依赖库产生冲突。建议在项目初期就使用虚拟环境工具,如venv或conda,来隔离不同项目的依赖,避免全局环境的混乱。
另一个棘手的问题是CUDA相关错误,例如“CUDA error: no kernel image is a vailable for execution on the device”或“Failed to get convolution algorithm.”这类错误往往与深度学习框架(如PyTorch、TensorFlow)的版本、CUDA驱动版本以及显卡计算能力不匹配有关。处理时,需要首先确认显卡型号和支持的CUDA版本,然后去框架官网查找与之匹配的预编译版本进行安装。对于从源码编译安装的情况,则需要确保编译参数正确设置了计算能力架构。
数据处理与加载过程中的典型错误
数据是人工智能模型的燃料,在数据准备阶段也常会报错。“FileNotFoundError: [Errno 2] No such file or directory”是最直接的错误之一,表明代码指定的数据路径不存在。这需要仔细检查文件路径字符串是否正确,注意绝对路径与相对路径的区别,尤其是在不同操作系统间迁移代码时,路径分隔符的差异可能导致问题。使用os.path.join()等方法来构建路径可以提高代码的跨平台兼容性。
在数据加载时,可能会遇到“ValueError: cannot reshape array of size X into shape (Y,Z)”。这通常意味着数据的实际维度与模型期望的输入维度不匹配。例如,一个期望输入为[32, 3, 224, 224](批次大小、通道、高、宽)的模型,如果喂入的数据形状是[32, 224, 224, 3],就会触发此类错误。解决方法是检查数据预处理流程,确保数据增强、归一化、维度转换等步骤的顺序和结果符合模型要求。使用调试工具打印出数据在每个关键节点的形状是有效的排查手段。
模型训练与优化阶段的常见问题
进入模型训练阶段,损失值(Loss)相关的问题尤为突出。如果损失值在训练初期就变为“NaN”(Not a Number),这通常被称为梯度爆炸。可能的原因包括学习率设置过高、网络层中未使用适当的归一化(如BatchNorm)、或损失函数在某些输入下产生了数学上的未定义值(如对负数取对数)。解决方法包括:降低学习率、为损失函数添加微小的epsilon值以避免数学异常、使用梯度裁剪技术,以及检查输入数据中是否存在异常值或全零样本。
另一个常见现象是模型“不学习”,即损失值几乎不下降,准确率维持在随机猜测水平。这可能是由多种原因造成的:可能是优化器选择不当,例如对稀疏数据使用SGD而不搭配动量;可能是网络权重初始化方式不佳,导致梯度消失;也可能是数据标签本身存在错误,导致模型无法找到有效规律。排查时可以从简化模型和问题入手,例如在一个极小的、已知能收敛的数据集上测试,以排除代码逻辑错误,再逐步恢复复杂设置。
内存与显存不足的报错与应对
“RuntimeError: CUDA out of memory.”是让许多开发者头疼的报错信息,尤其是在使用大型模型或大批次数据时。显存(GPU内存)是有限的资源,当模型参数、梯度、优化器状态以及中间激活值所占用的空间超过显卡容量时,就会发生溢出。处理此问题有一系列策略:最直接的方法是减小批次大小;其次,可以尝试使用更高效的优化器,如AdamW相比Adam有时占用显存更少;此外,采用梯度累积技术可以在不增加显存占用的情况下,模拟更大批次大小的训练效果。
对于模型本身,可以考虑使用混合精度训练,即让部分计算使用半精度浮点数,这能显著减少显存占用并可能加快训练速度。模型剪枝、量化等模型压缩技术也是解决内存瓶颈的长远方案。在代码层面,注意及时释放不再需要的张量变量,可以使用“del variable”命令,并配合“torch.cuda.empty_cache()”来清空缓存。对于非常大的模型,可能需要借助模型并行或流水线并行等技术,将模型拆分到多个设备上。
部署与推理时可能遇到的障碍
当模型训练完成,准备投入实际应用时,部署阶段又会面临新的挑战。一个典型错误是“ONNX export failure”或类似模型格式转换失败。不同框架(PyTorch, TensorFlow)导出的模型,在转换为通用格式(如ONNX)或特定终端格式(如TensorRT引擎、Core ML模型)时,可能会因为使用了不支持的算子或动态维度问题而失败。解决方法是查阅转换工具的支持算子列表,对不支持的算子进行自定义实现或寻找等效替代方案,并尽量将模型的动态输入维度(如可变批次大小)固定下来。
在推理服务中,可能会遇到“维度不匹配”或“数据类型错误”。这常常是因为训练/预处理时使用的配置与推理时的配置不一致造成的。例如,训练时对图像进行的归一化(如减去均值[0.485, 0.456, 0.406]除以标准差[0.229, 0.224, 0.225]),在推理时必须严格一致。最佳实践是将整个预处理流程(包括 resize、crop、normalize 的参数)序列化并与模型一同保存,确保端到端的一致性。使用Docker等容器技术将模型和其完整的运行环境打包,可以极大减少因环境差异导致的部署问题。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。
llama.cpp b12344的预发布构建调整了MCP工具调用的取消行为:客户端断连或调用超时时,服务器会向MCP服务发送带请求ID的取消通知。使用服务端工具的Web界面也属于这项变更范围。
llama.cpp b12342新增面向少列矩阵计算的CUDA量化内核,覆盖2至24个src1列等场景,例如推测解码的验证阶段。新增内核针对Ampere及更新的NVIDIA GPU,并限定于发行说明列出的量化类型;它不是所有硬件与模型都会得到相同收益的通用开关。
LiteLLM 1.111.0-dev.1是预发布版本。核对这一镜像是否由对应项目密钥签署,可使用cosign,并把公钥固定到发行说明指定的提交。镜像签名校验与应用功能测试分别进行,校验通过不代表升级后的计费和网关配置已经验证。
想了解Claude怎么收费?本文梳理了Claude Free、Pro及Team版的最新月费价格、消息限额与高级功能权益,并对比了不同层级的性价比,助你快速找到适合的AI办公伙伴。
本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。
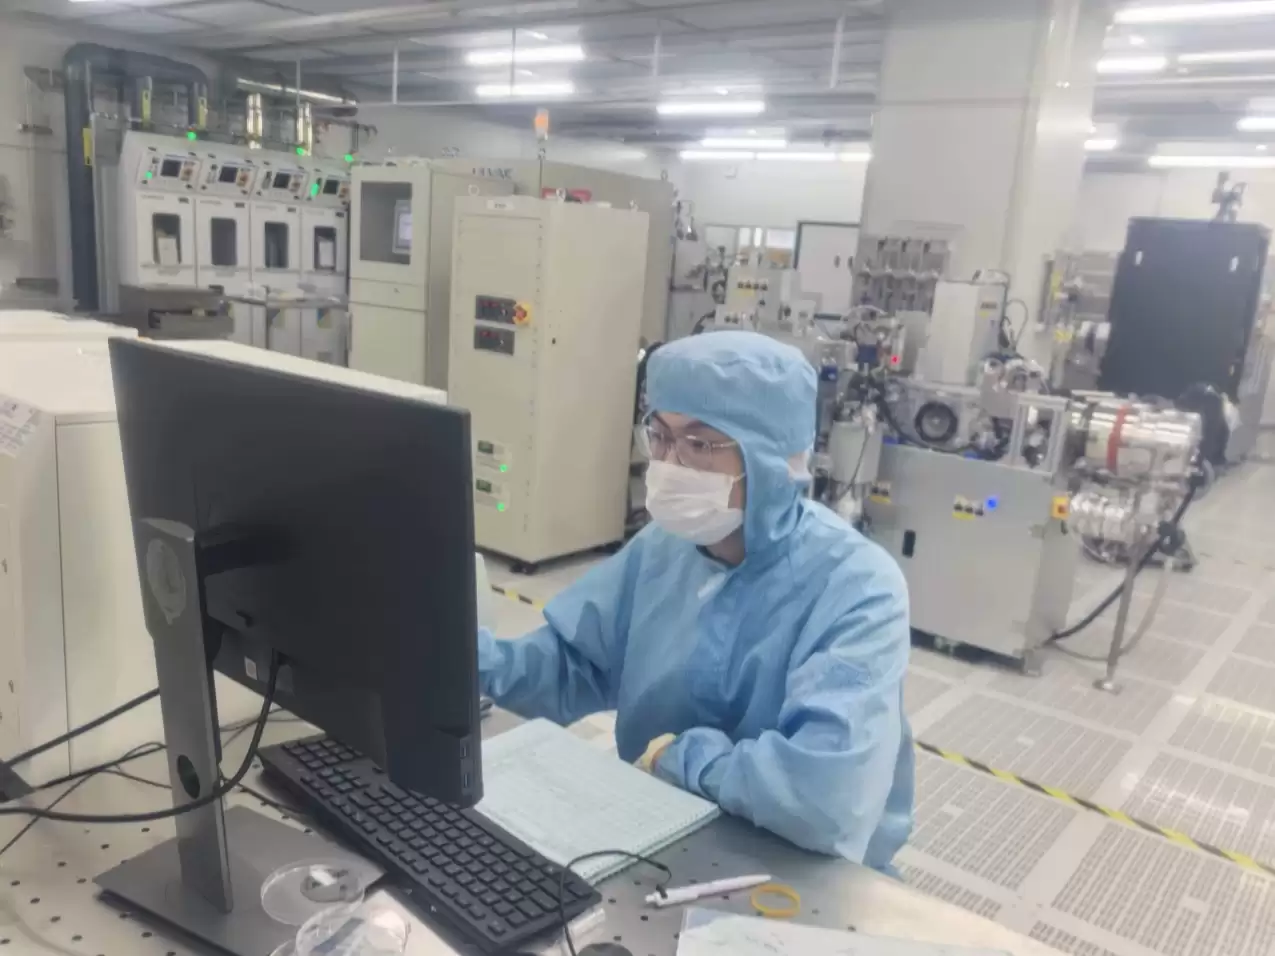
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。
苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。
一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。
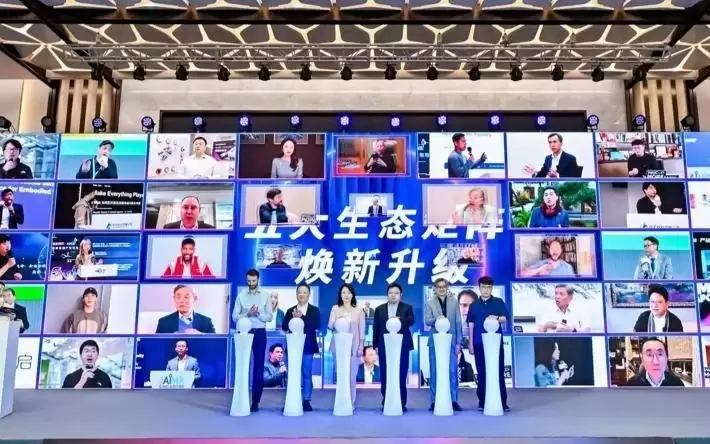
2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



