

有效提升大型语言模型效果的关键:增加Agent数量
腾讯的研究团队进行了一项关于agent的可拓展性的研究。他们发现,通过简单的采样投票,大型语言模型(LLM)的性能随着实例化agent数量的增加而增强。这项研究首次在各种场景中验证了这一现象的普遍性,并与其他复杂方法进行了对比,探讨了这一现象背后的原因,并提出了进一步发挥scaling效应的方法。论文标题:MoreAgentsIsAllYouNeed论文地址:https://arxiv.org/abs/2402.05120代码地址:https://github.com/MoreAgentsIsAllYou
腾讯的研究团队进行了一项关于agent的可拓展性的研究。他们发现,通过简单的采样投票,大型语言模型(LLM)的性能随着实例化agent数量的增加而增强。这项研究首次在各种场景中验证了这一现象的普遍性,并与其他复杂方法进行了对比,探讨了这一现象背后的原因,并提出了进一步发挥scaling效应的方法。

论文标题:More Agents Is All You Need
论文地址:https://arxiv.org/abs/2402.05120
代码地址:https://github.com/MoreAgentsIsAllYouNeed/More-Agents-Is-All-You-Need

论文详细探讨了多种集成LLM的相关研究,其中包括LLM的自集成、异构LLM的集成,以及多个LLM代理协作框架的研究。通过与提出的方法进行对比,可以看出论文进行了更为全面的研究和分析。

将任务 query 输入到单个 LLM 或多个 LLM Agents 协作框架中,生成多个输出; 通过多数投票确定最终结果


基于 LLama13B

基于 LLama70B

基于 GPT-3.5-Turbo
固有难度:随着任务固有难度的增加,性能提升(即相对性能增益)也会增加,但当难度达到一定程度后,增益会逐渐减少。这表明在任务过于复杂时,模型的推理能力可能无法跟上,导致性能提升的边际效应递减。 步骤数量:随着解决任务所需的步骤数量增加,性能提升也会增加。这表明在多步骤任务中,通过增加 agent 数量可以帮助模型更好地处理每一步,从而整体提高任务的解决性能。 先验概率:正确答案的先验概率越高,性能提升越大。这意味着在正确答案更有可能的情况下,增加 agent 数量更有可能带来显著的性能提升。

逐步采样和投票(Step-wise Sampling-and-Voting):这种方法将任务分解为多个步骤,并在每个步骤中应用采样和投票,以减少累积错误并提高整体性能。 分层采样和投票(Hierarchical Sampling-and-Voting):这种方法将低概率任务分解为多个高概率子任务,并分层解决,同时可以使用不同模型来处理不同概率的子任务以降低成本。 
据媒体报道,腾讯被曝计划退出对多家日本游戏工作室的股权投资,包括Marvelous等多家公司,或将以折价方式回售。腾讯回应称将保持对日本游戏市场的长期关注和投入,游戏是核心业务之一,不会改变。
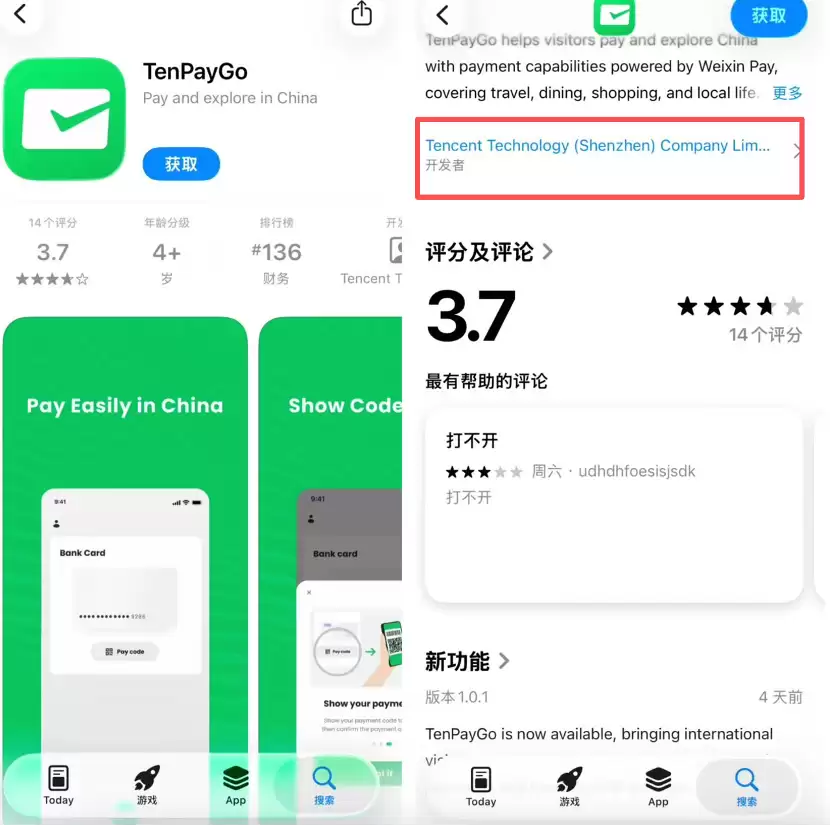
腾讯TenPayGo在苹果商店上架,面向境外来华人员,支持邮箱注册并绑定Visa等国际信用卡或ApplePay,无需内地手机号及银行卡,简化移动支付门槛,目前处于内测阶段。
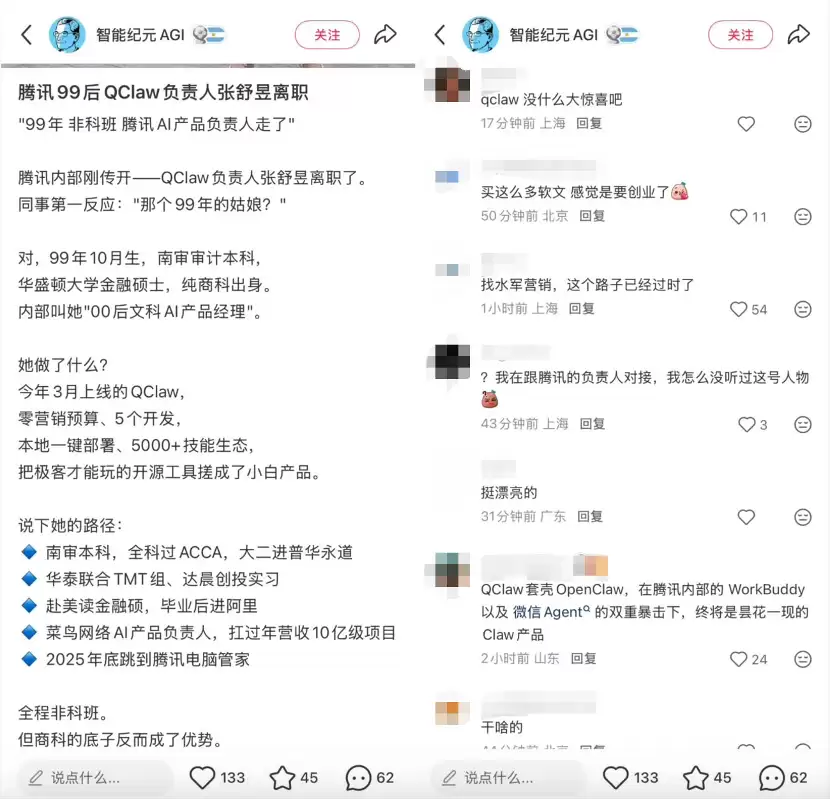
腾讯QClaw负责人张舒昱(1999年,纯商科背景)离职。其率5人团队开发打通微信QQ接口的龙虾产品QClaw,但体验不佳,出海版访问量环比暴跌99.19%,且bug多、内部竞争激烈。
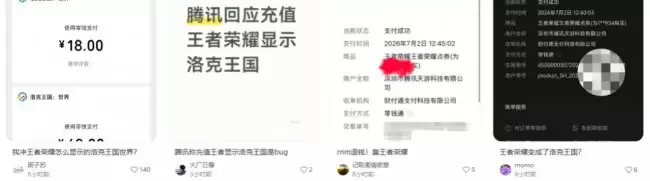
腾讯回应《王者荣耀》充值界面误显示《洛克王国》为临时bug,实际充值资金和点券正常到账,不影响用户。技术团队正优化系统稳定性,修复时间未定。
李未可携手腾讯云推出端云一体AI穿戴解决方案,融合WakeeMemory记忆OS与WAKE-AI3.0架构,依托腾讯云算力底座和WorkBuddy全域智能体,打通终端感知、云端存储与AI执行闭环,构建覆盖商务、文旅、企业服务的随身记忆智能体体系,解决算力瓶颈与数据互通难题。
七月六日,腾讯混元Hy3正式发布,智能水平显著提升,性能卓越,比肩参数大二至五倍的旗舰模型。定价下调:输入一元/百万tokens,输出四元,缓存低至零点二五元。采用Apache2.0开源协议,已接入多个业务并上线国内外API平台。
码上飞打造面向人工智能智能体的商业到智能体基础设施,帮助小商家将生意从互联网搬运至人工智能世界。平台已拥有一百万注册用户、二百万个生成应用,链接超十亿人次,年经常性收入突破一千万,相当于人工智能时代的收款机。
腾讯会议创建者可通过五种方式导出或查询参会名单:一、会中实时导出;二、会后从历史会议详情页导出;三、通过官网个人中心导出;四、移动端快速导出;五、免导出直接核验。 作为腾讯会议的组织者,如果需要掌握谁参加了会议,却发现名单无处可寻,别急。这通常不是功能缺失,而是路径或权限问题。下面这份操作指南,能帮
想要快速生成一份结构清晰、还能协同编辑的日历?这几个路径总有一条适合你:一,直接在模板中心搜索“日历”并点击启用;二,从“新建”下拉菜单里选模板新建;三,用空白表格手动填充日期打造专属日历;四,在手机App的模板页里搜索使用。 想在腾讯文档里快速弄出一份日历,用来规划日程或者团队协作,这事儿其实挺简
腾讯会议提供了四种途径来发送点赞表情,为会议互动增添活力:一是直接点击右下角的点赞按钮,会触发随机动画;二是通过【更多】菜单进入【举手】选项,启用表情回应功能;三是需要主持人预先在会议设置中开启“表情回应”权限;四是点击左下角的【回应】按钮,手动挑选特定表情进行发送。 想在腾讯会议里给主持人点个赞,






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
