

Pandas DataFrame数据对比与差异查找教程
本教程详细介绍了如何高效比较两个PandasDataFrame,以识别并定位其中的数据差异。文章通过直接的布尔比较、自定义函数以及apply方法,展示了如何准确找出发生数据不匹配的行和列,并以清晰的格式输出差异报告,适用于数据验证和质量控制场景。

1. 引言
在数据分析和处理过程中,经常需要对比两个DataFrame,例如,比较不同时间点的数据快照、验证数据清洗结果或核对报告数据与源数据的一致性。本教程将介绍一种简洁有效的方法,用于识别两个结构相同(或可对齐)的Pandas DataFrame中所有不匹配的数据点,并以易于理解的格式输出差异报告,明确指出差异所在的行和列。
2. 核心概念:DataFrame的元素级布尔比较
Pandas DataFrame支持直接的元素级比较操作。当对两个DataFrame使用!=(不等于)运算符时,结果会是一个与原DataFrame形状相同的布尔型DataFrame。在这个布尔型DataFrame中,True表示对应位置的元素在两个原始DataFrame中不相同,而False则表示相同。
示例数据准备:
首先,我们创建两个示例DataFrame,df_actual代表实际数据,df_rpt_all1代表报告数据,其中包含一些预设的差异。
import pandas as pd

df_actual = pd.DataFrame({
    'Partner': ['P1', 'P2', 'P3'],
    'lobName': ['L1', 'L2', 'L3'],
    'sublobName': ['S1', 'S2', 'S3'],
    'channelName': ['C1', 'C5', 'C3'], # P2的channelName与df_rpt_all1不同
    'value1': [1, 2, 3] # P3的value1与df_rpt_all1不同
})

df_rpt_all1 = pd.DataFrame({
    'Partner': ['P1', 'P2', 'P3'],
    'lobName': ['L1', 'L2', 'L3'],
    'sublobName': ['S1', 'S2', 'S3'],
    'channelName': ['C1', 'C2', 'C3'], # P2的channelName与df_actual不同
    'value1': [1, 2, 6] # P3的value1与df_actual不同
})

print("df_actual:")
print(df_actual)
print("\ndf_rpt_all1:")
print(df_rpt_all1)
执行元素级比较:
difference_df = df_actual != df_rpt_all1
print("\n差异布尔DataFrame (difference_df):")
print(difference_df)
输出结果解释:
difference_df中的True值精确指示了两个DataFrame中不一致的单元格。例如,在索引为1的行(第二行),channelName列为True,表示df_actual和df_rpt_all1在该位置的值不同。同样,在索引为2的行(第三行),value1列为True。
差异布尔DataFrame (difference_df):
   Partner  lobName  sublobName  channelName  value1
0    False    False       False        False   False
1    False    False       False         True   False
2    False    False       False        False    True
3. 定位并格式化不匹配信息
为了生成清晰的差异报告,我们需要遍历difference_df,找出每一行中所有为True的列,并将其格式化为指定的输出字符串。
自定义函数 filter_different_columns:
我们将定义一个辅助函数,该函数接收difference_df的每一行(在reset_index()之后),识别出其中值为True的列,并构建一个描述该行差异的字符串。
def filter_different_columns(row_series):
    """
    根据布尔Series识别出值为True的列,并格式化输出。
    row_series: 一个Pandas Series,代表difference_df中的一行,
                其中包含一个名为'index'的列(原始行索引)和布尔值列。
    """
    row_dict = dict(row_series)
    # 提取原始行索引,通常在reset_index()后作为'index'列
    original_index = row_dict.pop('index')

    # 找出所有值为True(即存在差异)的列名
    mismatched_columns = [col for col, is_diff in row_dict.items() if is_diff]

    # 如果存在差异列,则格式化输出字符串
    if mismatched_columns:
        return f"(Row {original_index + 1}, columns=[" + ",".join(mismatched_columns) + "]),"
    else:
        return "" # 如果没有差异,返回空字符串
应用函数并聚合结果:
接下来,我们将difference_df重置索引(以便在函数中获取原始行号),然后使用apply方法将filter_different_columns函数应用于每一行。最后,通过sum()方法将所有非空字符串连接起来,形成最终的差异报告。
# 将difference_df的索引重置为普通列,以便在apply函数中访问原始行号
# original_index + 1 是为了将0-based index转换为1-based index,更符合人类阅读习惯
mismatched_data_parts = difference_df.reset_index().apply(filter_different_columns, axis=1)

# 将所有差异字符串连接起来,并移除末尾可能多余的逗号
mismatched_report = "".join(mismatched_data_parts).strip(',')

if mismatched_report:
    print(f"\nMismatched Rows:\n{mismatched_report}")
else:
    print("\nNo mismatches found.")
完整代码示例:
import pandas as pd

# 示例数据
df_actual = pd.DataFrame({
    'Partner': ['P1', 'P2', 'P3'],
    'lobName': ['L1', 'L2', 'L3'],
    'sublobName': ['S1', 'S2', 'S3'],
    'channelName': ['C1', 'C5', 'C3'],
    'value1': [1, 2, 3]
})

df_rpt_all1 = pd.DataFrame({
    'Partner': ['P1', 'P2', 'P3'],
    'lobName': ['L1', 'L2', 'L3'],
    'sublobName': ['S1', 'S2', 'S3'],
    'channelName': ['C1', 'C2', 'C3'],
    'value1': [1, 2, 6]
})

# 1. 执行元素级比较,生成布尔型DataFrame
difference_df = df_actual != df_rpt_all1

# 2. 定义辅助函数,用于识别并格式化每行的差异
def filter_different_columns(row_series):
    row_dict = dict(row_series)
    original_index = row_dict.pop('index') # 获取原始行索引

    mismatched_columns = [col for col, is_diff in row_dict.items() if is_diff]

    if mismatched_columns:
        # 转换为1-based index
        return f"(Row {original_index + 1}, columns=[" + ",".join(mismatched_columns) + "]),"
    else:
        return ""

# 3. 应用函数并聚合结果
# reset_index() 将原始索引作为名为 'index' 的列添加到 DataFrame 中
mismatched_data_parts = difference_df.reset_index().apply(filter_different_columns, axis=1)

# 使用 join() 方法连接所有字符串,并去除末尾可能多余的逗号
mismatched_report = "".join(mismatched_data_parts).strip(',')

# 4. 打印最终报告
if mismatched_report:
    print(f"Mismatched Rows:\n{mismatched_report}")
else:
    print("No mismatches found.")
预期输出:
Mismatched Rows:
(Row 2, columns=[channelName]),(Row 3, columns=[value1])
4. 注意事项与扩展
DataFrame对齐:
- 此方法假设两个DataFrame的列名和索引是相同且对齐的。如果两个DataFrame的列顺序不同,或者索引不完全一致,直接使用!=可能会导致比较结果不准确。在这种情况下,可能需要先使用df1.reindex(columns=df2.columns)或df1.align(df2)等方法进行对齐。
- 如果需要基于特定ID列进行比较,且两个DataFrame的行数或顺序可能不同,可以考虑先通过merge操作将它们连接起来,再进行比较。
缺失值(NaN)处理:
- 在Pandas中,NaN != NaN 的结果是 True。这意味着如果两个DataFrame在相同位置都包含NaN,它们会被视为不匹配。如果希望NaN与NaN视为匹配,可以先使用df.fillna(value)将NaN替换为特定值(如0或空字符串),或者使用df1.equals(df2)(它将NaN视为相等)进行精确比较。
性能考量:
- 对于非常大的DataFrame,元素级布尔比较(df1 != df2)是高度优化的,性能良好。
- apply(..., axis=1)在Python循环中执行,对于极大的DataFrame,其性能可能不如完全矢量化的操作。但对于生成这种特定格式的差异报告,它通常是一个可接受且易于理解的方案。如果需要极致性能,可能需要探索更复杂的矢量化方法,例如使用stack()和groupby()。
输出格式定制:
- filter_different_columns函数可以根据需求轻松修改,以生成不同格式的差异报告。例如,可以返回一个包含字典的列表,每个字典描述一个差异点(包括行号、列名、df_actual值和df_rpt_all1值),而不是一个字符串。
5. 总结
通过利用Pandas DataFrame的元素级布尔比较能力,结合自定义函数和apply方法,我们可以有效地识别并报告两个DataFrame之间的数据差异。这种方法不仅提供了清晰的差异定位,而且具有良好的可读性和可扩展性,是数据验证和质量控制任务中的一个实用工具。正确理解其工作原理和注意事项,可以帮助我们更准确、高效地管理和分析数据。
iSlide设计工具侧边栏不见了怎么办?本教程详解在Windows版PPT中通过【设计工具】按钮恢复侧边栏的方法,涵盖面板拖拽、模块隐藏检查及插件加载异常的处理,同时提供macOS用户的使用指引。

全面盘点Flutter主流状态管理框架,深度解析Provider、Riverpod、Bloc与GetX的核心机制、优缺点及适用场景,提供系统化的状态管理选型指南。
新手入门 NetLimiter 必读指南。详解 Activity 实时监控、DL/UL Limit 限速设置、Blocker 阻止规则及 Stats 流量统计功能。图文结合展示规则编辑器操作,助你轻松管理 Windows 应用网络带宽。
在Linux系统中,复制文件并改名并没有单独的独立命令,而是通过标准复制命令cp在指定目标路径时直接写上新文件名来完成。本文详解cp命令复制并重命名的操作语法、同目录与跨目录示例、常用安全参数及目录复制实践。
学习如何将Blender中的动态材质导出为图片序列。涵盖输出路径设置、PNG格式选择、帧范围确认及Image Sequence贴图的重新载入方法,适合需要保留透明通道或后期处理的动画贴图工作流。
想在iPhone或iPad上实现锁屏一键直达?本文详解“锁屏启动”的安装前检查清单、系统权限配置步骤及小组件添加方法,解决组件不显示、点击无反应等常见问题,确保快捷指令、网页和App快速启动。
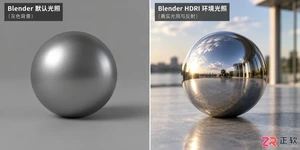
学习如何在Blender中使用HDRI进行渲染。通过World着色器连接Environment Texture节点,调整光照强度与环境方向,解决背景显示与曝光问题,快速提升场景真实感。
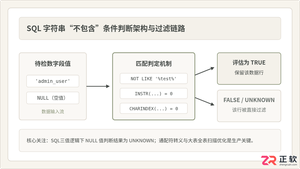
深入详解在SQL中进行条件判断字符串不包含某个子串的方法,涵盖标准NOT LIKE、各主流数据库(MySQL、PostgreSQL、SQL Server、Oracle)专有位置函数、正则表达式判断,剖析NULL值三值逻辑陷阱及全表扫描性能优化策略。
新手必读的IDM安装配置教程。从官方下载开始,逐步讲解如何完成Windows安装、启用Chrome/Edge/Firefox浏览器扩展、设置默认保存目录及调整连接线程,解决IDM不弹窗接管下载的常见问题。
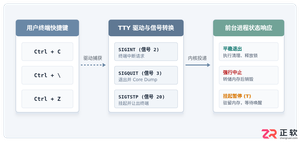
全面解析Linux终端中终止进程的核心快捷键(Ctrl+C、Ctrl+Z、Ctrl+\)的原理、区别与具体使用方法,附后台恢复与强制终止全流程指南。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。