

如何使用 LangChain 构建基于 JSON 文档的 URL 检索问答系统
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
介绍如何利用LangChain构建基于JSON文档的URL检索问答系统。核心在于加载JSON时通过元数据绑定URL,确保切分和向量化过程中不丢失链接信息。随后构建检索增强问答链,使用强约束提示词使模型仅返回相关URL,从而精准响应用户的自然语言查询。

本文介绍如何利用 langchain 高效加载、切分和检索结构化 json 数据(含页面内容与对应 url),构建一个能根据用户自然语言查询精准返回相关网页链接的轻量级问答系统。
当你手头的知识库是一堆结构清晰的 JSON 文件,比如每个条目都包含页面内容和对应的 URL,想把它变成一个能“听懂人话”、并精准返回链接的问答系统时,直接套用标准的 RAG 流程往往会掉进坑里。最常见的问题就是:经过文本切分和向量化后,原始的 URL 信息莫名其妙就丢了,导致系统虽然能回答问题,却给不出正确的来源链接。
问题的核心在于方法。正确的思路其实很明确:在保证文本语义完整性的同时,必须将 URL 作为关键元数据显式地绑定到每一段文本上,并通过精准的检索来驱动最终的 URL 输出。下面,我们就来拆解这个端到端的实现方案。
步骤一:用 JSONLoader 加载并结构化解析
第一步是数据加载,这里的关键是“原汁原味”地保留结构。LangChain 提供的 JSONLoader 是这个环节的利器。它能够将 JSON 中的键值对转化为携带元数据的 Document 对象,确保 URL 不会在加载阶段就被丢弃。
from langchain.document_loaders import JSONLoader
import os

# 假设 data.json 内容为 { “about”: {“data”: “This site...”, “url”: “/about”}, ... }
loader = JSONLoader(
    file_path=“data.json”,
    jq_schema=“.[] | {page_name: .page_name, data: .data, url: .url}”,  # 自定义提取逻辑
    text_content=False,  # 关键!禁用自动转字符串,避免破坏结构
    metadata_func=lambda record, metadata: {
        “url”: record.get(“url”, “”),
        “page_name”: record.get(“page_name”, “”)
    })
docs = loader.load()
这里有个技术要点:`jq_schema` 参数让你能用灵活的 jq 语法提取所需字段;而 `metadata_func` 则负责将 URL 等信息作为元数据注入每个 Document 对象,为后续的检索铺平道路。
步骤二:合理切分 + 向量化(保留元数据)
加载后的文档需要切分以适应模型的上下文窗口,但切记,元数据必须跟随文本片段一起走。使用 RecursiveCharacterTextSplitter 时,我们的目标是只对内容部分(如 `page.data`)进行切分,并确保每个切分后的 chunk 都完整继承了原始的 URL 和页面名称。
from langchain.text_splitter import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=300,
    chunk_overlap=50,
    separators=[“\n\n”, “\n”, “. “, “! “, “? “])

# 仅对 .page.data 切分,但保留元数据
for doc in docs:
    doc.page_content = doc.metadata.pop(“data”, “”)  # 将 data 提升为 page_content
splits = text_splitter.split_documents(docs)
完成这一步后,每个 Document 对象的 `page_content` 是纯文本片段,而其 `metadata` 字典里则稳稳地保存着对应的 `“url”`。这正是后续能够精准返回 URL 的基石。
步骤三:构建检索增强问答链(RetrievalQA),定制输出格式
接下来进入检索与生成环节。你可以选择 Chroma 作为向量数据库,搭配 GoogleGenerativeAIEmbeddings 或其他嵌入模型。但这个环节的重中之重,在于设计一个强约束的提示词(Prompt),用以“管教”大语言模型,让它只输出我们想要的 URL。
from langchain.vectorstores import Chroma
from langchain_google_genai import GoogleGenerativeAIEmbeddings
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate

embeddings = GoogleGenerativeAIEmbeddings(
    model=“models/embedding-001”,
    google_api_key=GOOGLE_API_KEY)
vectordb = Chroma.from_documents(splits, embeddings, persist_directory=“./chroma_url_db”)
retriever = vectordb.as_retriever(search_kwargs={“k”: 3})

# 强约束 prompt:只返回 URL,不编造、不解释
prompt_template = “”“You are a precise URL lookup assistant.
Given the user‘s question and relevant document snippets (each with ’url‘ metadata), return ONLY the most relevant URL as a plain string (e.g., ’/contact‘), nothing else.

Question: {question}
Context:{context}
Answer (URL only):”“”
PROMPT = PromptTemplate(template=prompt_template, input_variables=[“question”, “context”])

qa_chain = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type=“stuff”,
    retriever=retriever,
    return_source_documents=True,
    chain_type_kwargs={“prompt”: PROMPT},
    verbose=True)

# 使用示例
result = qa_chain.invoke({“question”: “How do I contact support?”})
print(result[“result”])  # 输出类似:“/contact”
注意事项与优化建议
为了让系统更稳健,这里有几个细节值得你关注:
- 避免 URL 丢失的陷阱:切勿简单地将 URL 字符串拼接到 `page_content` 里(比如写成‘URL: /about Data: ...’)。这样做会污染文本的语义向量,反而降低检索的准确性。
- 元数据过滤(进阶用法):如果只需要在特定范围的页面内检索(例如仅搜索 `/docs/` 路径下的内容),可以在构建检索器时添加过滤条件,如 `search_kwargs={“filter”: {“url”: {“$regex”: “^/docs/”}}}`。
- 零样本微调提示:对于数据量很小(比如少于100条记录)的简单场景,可以考虑跳过向量检索,直接使用 StuffDocumentsChain 配合一个精心设计的提示词来提取和总结 URL。
- 评估验证必不可少:在投入实际使用前,务必用真实的查询语句测试 `retriever.get_relevant_documents(...)` 返回的 Document 是否包含了正确的 `metadata[“url”]`。这是整个流程可靠性的根本。
遵循以上设计,你最终得到的是一个轻量、可控且过程可解释的 JSON 驱动 URL 检索系统。它既充分利用了大语言模型的语义理解能力,又严格保障了 URL 这类关键结构化元数据在流程中的端到端无损传递。
深入解析Java发送JSON格式POST请求的实现机制,对比原生API与第三方库的代码差异,提供可复制的代码示例,并探讨超时设置、编码处理及微服务场景下的例外情况。
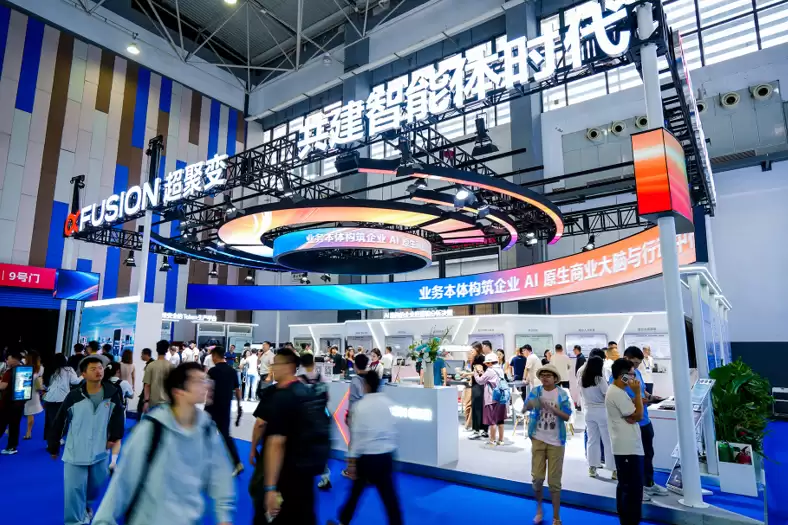
本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。
从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。
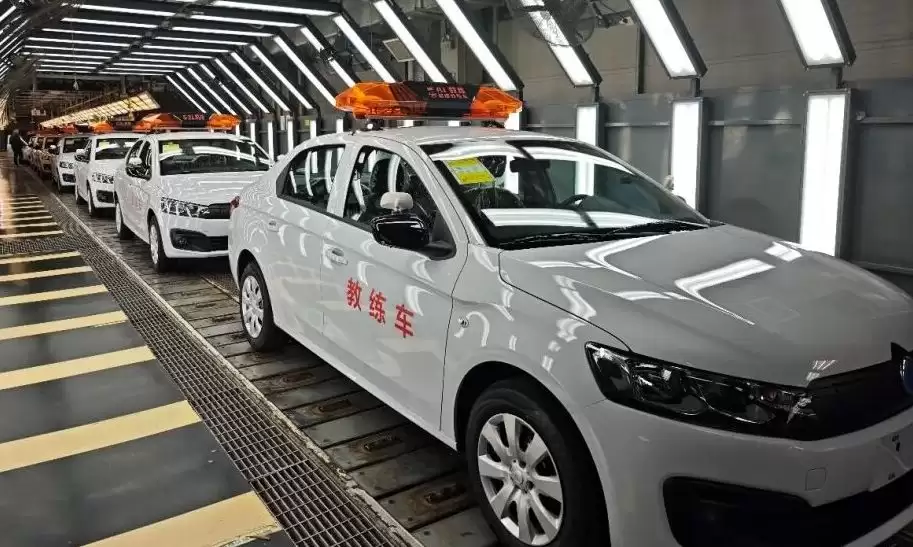
2026届高考生学车时多采用AI教练,逐步适应人机共驾。作为与生成式AI共同成长的一代,他们更易接受智能驾驶,未来可能成为首批“原生AI司机”。至2030年前后,其人生首辆车或具备L3级自动驾驶能力,驾驶角色将从操控者转向监督者。
全球股市因AI热潮呈现K型分化,半导体板块估值逼近百倍市盈率。历史警示:2000年互联网泡沫中的“四骑士”最终市值暴跌或长期盘整。投资者应警惕“错失恐惧症”,重视安全边际、护城河与能力圈,避免被高估值裹挟,关注稳健性与股息率。
Cloudflare报告显示,完成应用现代化的企业从AI投资中获得可衡量回报的概率是未现代化企业的三倍。93%的决策者视系统更新为AI先决条件,91%的领先企业已嵌入AI功能。安全与现代化协同推进可使AI成熟度提升四倍,精简技术架构成为竞争力分水岭。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。