

怎么通过 Stream.findAny() 在并行处理大数据流时获取任意一个符合条件的过滤结果
Stream.findAny()方法在并行流中能快速筛选数据,找到任意符合条件的元素后立即终止搜索,提升大数据处理效率。它适用于无需保证顺序、注重速度的场景,如检查异常或查找特征。使用时需确保为并行流,并注意其返回结果的“任意性”。与findFirst()相比,它在并行环境中因避免协调开销而更具性能优势。
在处理海量数据流时,我们常常面临一个效率难题:如何快速找到一个符合条件的元素,而不必遍历整个数据集?Ja va Stream API 中的 findAny() 方法,尤其是在并行流中,就是为了解决这类“大海捞针”的场景而生的。它像一个高效的侦察兵,只要在任何一个分区里发现了目标,就会立刻鸣金收兵,避免无谓的消耗。

简单来说,Stream.findAny() 的核心价值在于并行流中的“短路”能力。它不保证返回的是第一个匹配项,但能确保在找到任何一个匹配项时立即结束整个搜索过程,这对于性能至上的大数据处理场景至关重要。
为什么 findAny() 适合并行流中的快速筛选
并行流的优势在于分而治之。当数据被分割成多个子流并行处理时,findAny() 的策略是“谁先找到,谁就胜出”。只要有一个子流发现了符合条件的元素,整个操作就会立刻终止,其他还在工作的子流也会被叫停。这种机制天生就支持无序的短路操作。
相比之下,findFirst() 在并行流中就显得有些“束手束脚”。为了保持元素的原始顺序,它必须协调所有子流,确保返回的是全局意义上的第一个匹配项,这不可避免地会带来额外的协调开销。
因此,在以下这些“存在即合理”的场景里,findAny() 的优势尤为明显:
- 快速检查是否存在违规订单或异常日志条目。
- 在任务队列中查找任意一个已超时的任务进行处理。
- 探测海量数据中是否出现了某个特定特征或模式。
其底层实现依赖于 Spliterator 的 tryAdvance 和 trySplit 方法,配合 ForkJoinPool 框架,实现了高效的“就近命中并返回”。这意味着,即便面对百万级的数据集,只要匹配项出现在靠前的数据分块中,整个查找过程可能在毫秒级别就能完成。
正确使用 findAny() 的关键写法
想要发挥 findAny() 的最大威力,有几个关键点必须把握住。首先,必须确保你操作的是一个真正的并行流。
- 务必显式调用
.parallelStream()(从集合创建)或.parallel()(将现有流并行化)。如果在普通串行流上调用 findAny(),它的行为将退化为 findFirst(),失去了并行的意义。 - 流操作链中的过滤条件(通常是
filter()中的 Predicate)必须是无状态且线程安全的。这意味着不能在其中修改共享变量,或者依赖可能被其他线程改变的外部状态,否则会导致不可预知的结果。 - 它的返回值是
Optional。这是一个重要的安全设计,因为完全有可能没有任何元素匹配条件。因此,后续的判空处理必不可少,直接调用get()可能会抛出 NoSuchElementException。
来看一个典型的应用示例:
Listorders = /* 百万级订单列表 */; Optional firstOverdue = orders.parallelStream() .filter(order -> order.getStatus() == OrderStatus.PENDING && order.getDeadline().isBefore(Instant.now())) .findAny(); // 可能返回任意一个逾期待处理订单 firstOverdue.ifPresent(order -> System.out.println("发现逾期单:" + order.getId()));
注意 findAny() 的“任意性”边界
“任意”这个词,是理解 findAny() 行为的关键,也常常是误解的来源。这里的“任意”指的是,Ja va 虚拟机并不承诺会返回哪一个特定的匹配元素——它可能是数据源中的第一个,也可能是最后一个,或者中间任何一个,这完全取决于并行执行时哪个线程最先完成任务。
但这绝不意味着结果是随机的或不可预测的:
- 在单次程序运行中,给定相同的数据集和并行度,多次调用 findAny() 通常会返回相同的结果。这是因为 ForkJoinPool 的任务调度在单次运行中具有一致性。
- 然而,在不同的程序运行之间,或者当 CPU 负载、JVM 版本、默认并行度发生变化时,结果就可能会不同。
- 所以,如果业务逻辑强依赖于“第一个”这个顺序语义(例如,必须按照订单提交顺序处理最早的那一个),那么就应该明确使用 findFirst(),并接受它在并行流中可能稍低的效率。
提升命中率与稳定性的实用建议
为了更高效、更可控地使用 findAny(),可以结合一些实践技巧:
- 轻量预筛:如果怀疑匹配项很可能出现在数据集的前部,可以先用
subList(0, 10000)对源集合做一个轻量级的切片,然后对这个切片调用并行 findAny()。这样能在速度和结果的可控性之间取得一个不错的平衡。 - 权衡并行开销:当匹配概率极低(例如千万分之一)时,并行处理本身的开销可能会超过其收益。此时,或许使用
limit(1)配合串行流的 findFirst() 是更简单有效的选择。 - 调试技巧:在调试复杂的并行流逻辑时,可以通过
ForkJoinPool.commonPool().setParallelism(1)临时将公共线程池的并行度设为1。这相当于将并行流“降级”为串行流,有助于验证过滤和业务逻辑的正确性,排除并发问题。
总而言之,findAny() 是并行流处理中一把锋利的“快刀”,专为“快速确认存在”的场景打造。理解其“任意性”的本质,并遵循正确的使用范式,就能在保证性能的同时,写出既高效又健壮的代码。
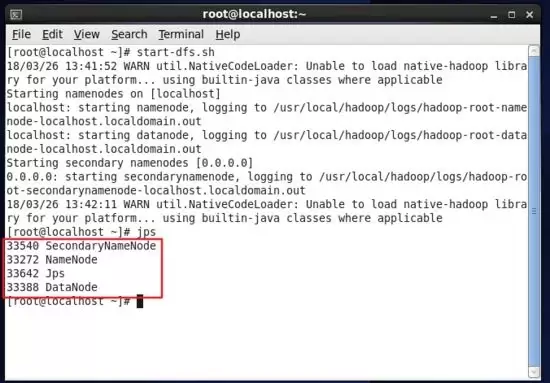
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
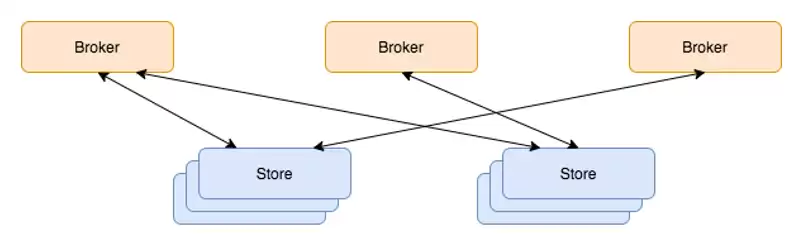
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
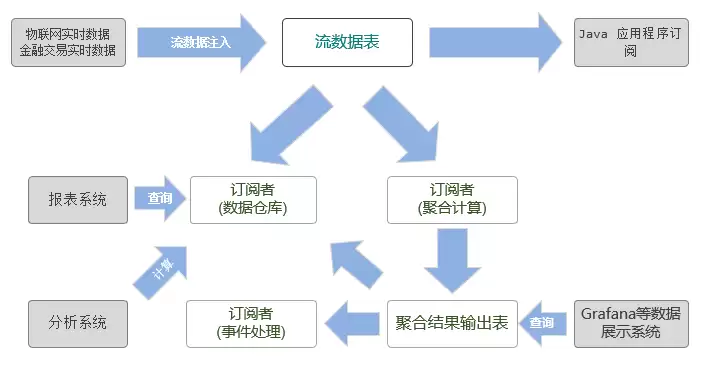
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高
导读:为了解决大数据、AI 等数据密集型应用在云原生场景下,面临的异构数据源访问复杂、存算分离 I/O 速度慢、场景感知弱调度低效等痛点问题,南京大学PASALab、阿里巴巴、Alluxio 在 2020 年 6 月份联合发起了开源项目 Fluid。Fluid 是云原生环境下数据密集型应用的高效支撑
什么是FluidFluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernet
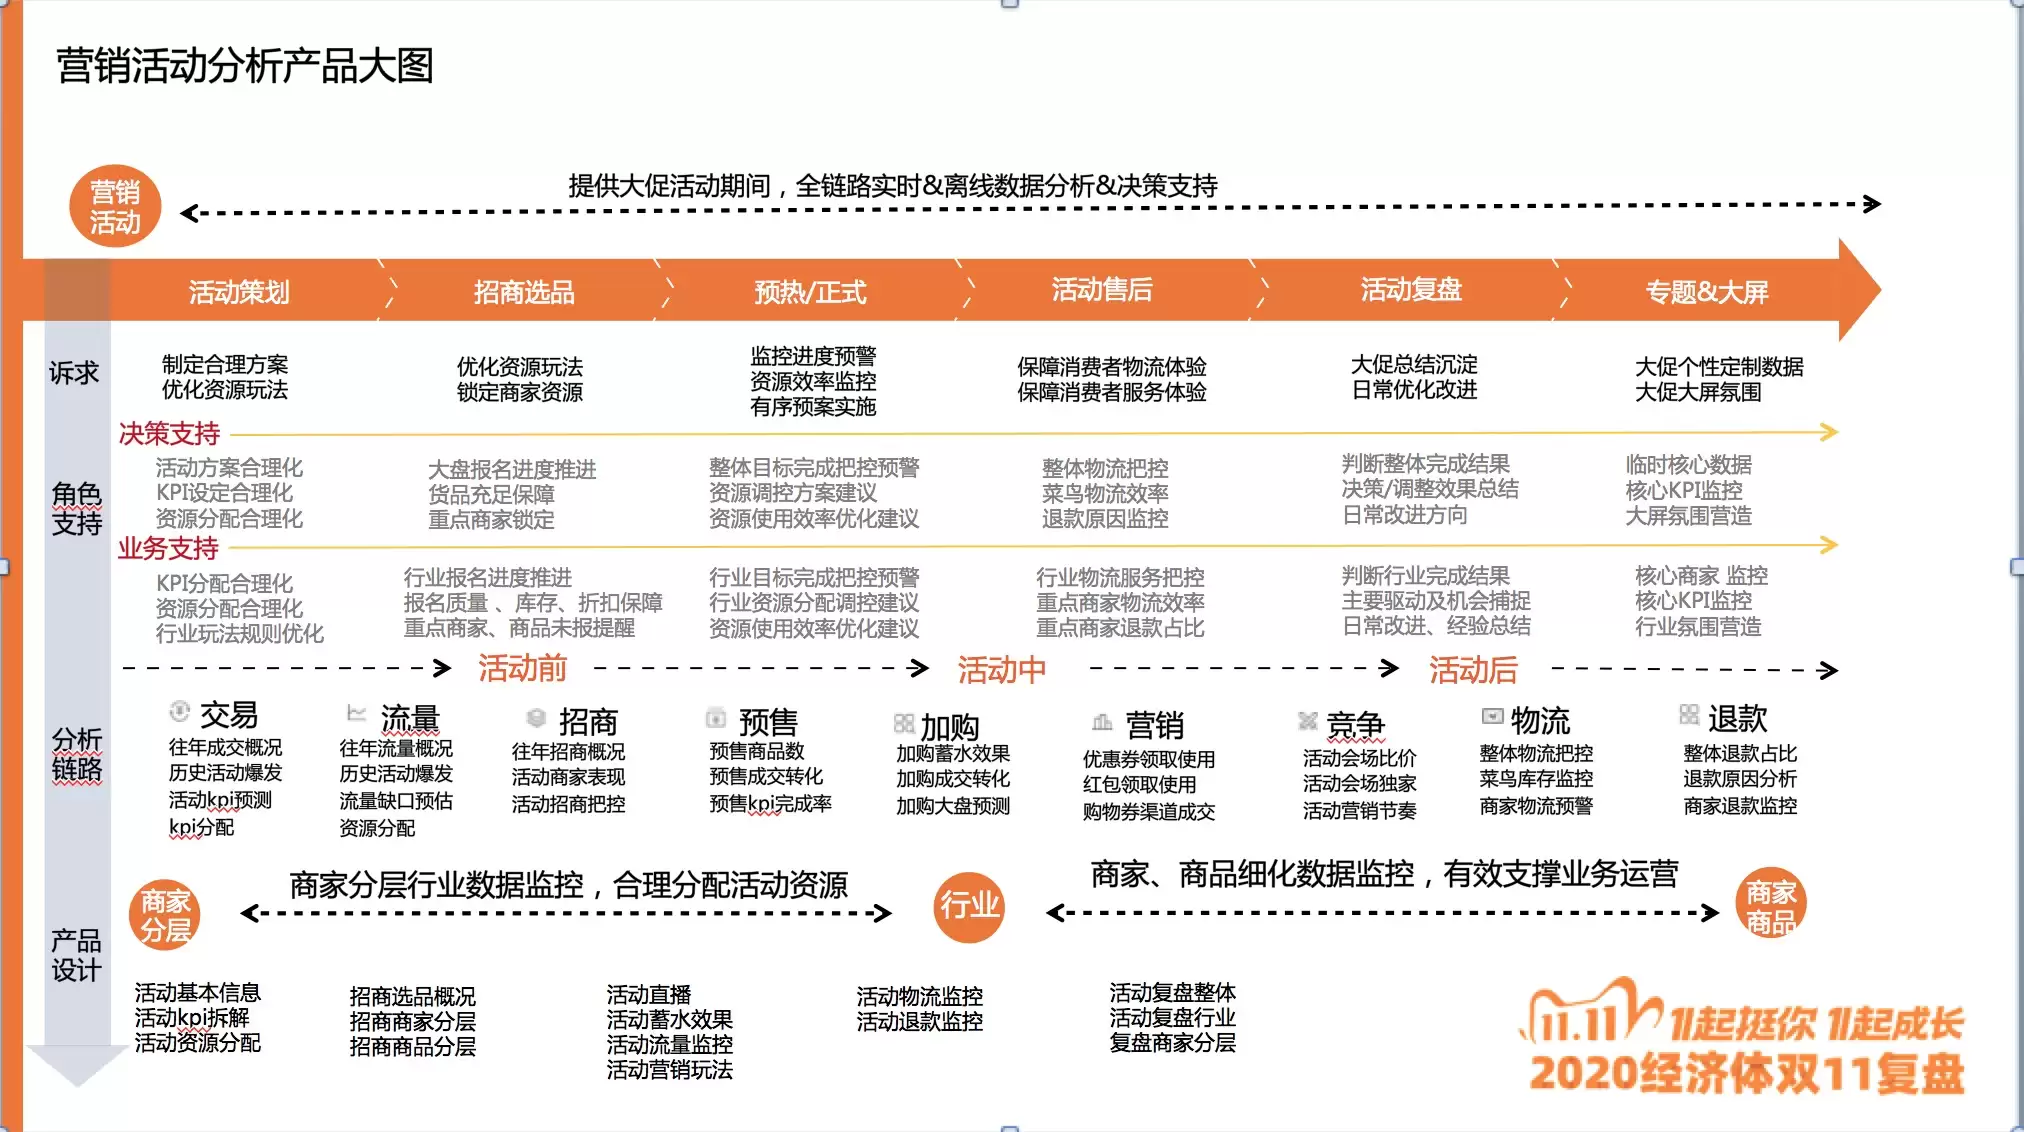
简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓
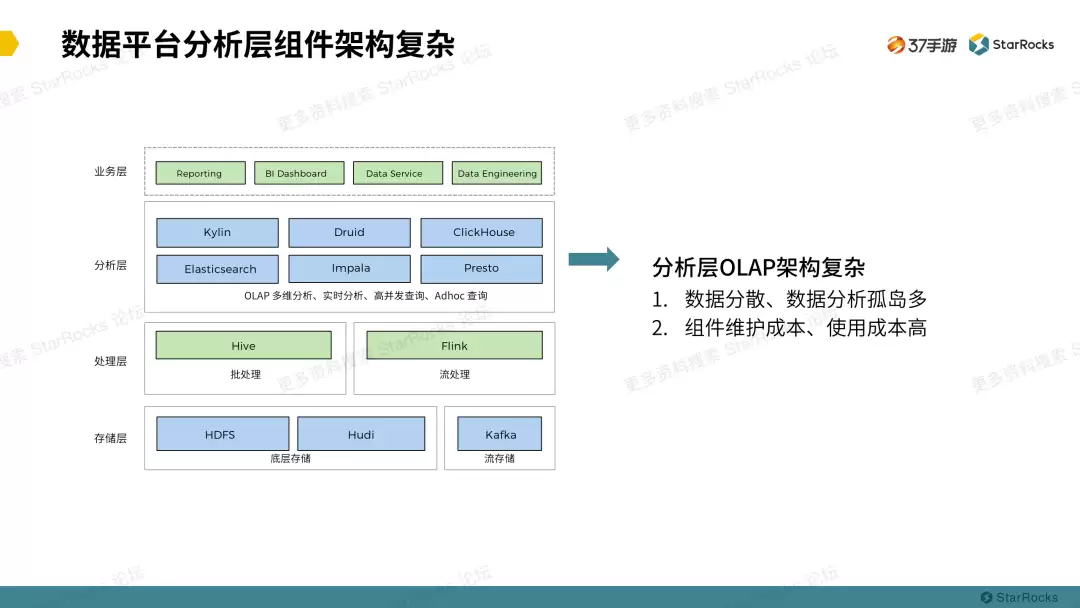
作者:向伟靖,37 手游大数据开发工程师37 手游使用 StarRocks 已有半年多,在此期间非常感谢 StarRocks 团队的积极协助,感受到了服务速度和产品速度一样快,辅导我们解决了产品使用上的一些问题。首先介绍下 37 手游的背景。37 手游主要专注于移动端游戏发行和游戏运营,成功发行运营




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,