

瑞士联邦理工学院的研究者们发现了一个让AI"记忆力"更好的秘密
Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
瑞士联邦理工学院研究团队为大型语言模型引入轻量级“短期记忆”模块,通过在前文词向量中融入衰减印记,显著缓解了处理长文本时效率与精度的矛盾。在多项测试中,该模块使多种稀疏计算加速方法的信息检索准确率大幅提升,甚至接近完整处理水平,为优化长文本处理提供了新方向。
如果你用过语音助手,或者让AI帮忙润色过一段文字,那你已经接触过“大型语言模型”了。这类模型理解文字的能力很强,但有个业界公认的老大难问题:当文本太长时,它的计算量就会指数级暴增,速度慢、成本高,让人头疼。更麻烦的是,为了让它快起来而采用的种种“加速技巧”,往往会牺牲掉准确性——省了时间,却丢了准头。
最近,瑞士联邦理工学院(EPFL)CLAIRE实验室的一项研究,为这个困境提供了一个新的解法。他们发现,只要给AI模型的核心架构加上一个精巧的“短期记忆”模块,那些为了提速而不得不“偷懒”的模型,其准确率就能得到惊人的恢复,有时甚至接近仔细读完所有信息时的水平。这项研究于2026年5月以预印本形式发布在arXiv平台,论文编号为arXiv:2605.28640。
这个发现指出了一个新方向:让AI又快又准,未必只能死磕“如何更好地偷懒”,换个思路,增强它“偷懒时的本钱”也许更有效。
一、为什么AI处理长文章会这么“费劲”
你可以想象一个每天都在处理海量邮件的行政人员。绝大多数邮件只需快速浏览,但偶尔会有一封至关重要的合同混杂其中,必须被精准地找到并处理。
当前的大型语言模型面对长文本时,处境与此类似。为了理解文本,它需要计算文中所有词语两两之间的关系,以此判断信息的轻重。文本长度如果翻倍,需要计算的关系数量就会变成原来的四倍。这种“二次方复杂度”的特性,正是导致AI推理速度慢、成本高的核心瓶颈。
于是,研究者们开发了各种“偷懒”策略,比如Quest、MoBA、SnapKV。它们的核心思路都一样:既然大多数词语间的关联很弱,那就只计算最重要的部分,跳过其余的。这些方法确实提升了速度,但代价是准确率,尤其是在需要精确检索特定信息的任务上,模型的表现会大打折扣。
二、一个“短期记忆手册”如何改变游戏规则
EPFL团队换了个思路。他们想,与其不断修补“偷懒”的方法,不如改造一下AI的“基本功”,让它即便在偷懒时,手头的信息也更丰富。
他们借助了一项名为RAT+的架构设计。这个设计的核心理念很直观:在标准的注意力模块旁边,添加一个轻量级的“记忆更新”机制。让每个词语的特征向量在模型中流动时,不仅能代表自己,还会悄悄融入前面词语留下的“印记”。
这个印记是衰减的:越近的词语影响越浓,越远的则越淡。这就像一本随手翻阅的短期记忆手册——你记不住前天看过的每个字,但昨天留下的关键印象,会帮助你理解今天的新内容。
从技术实现看,这个更新过程通过一个简单的递推公式完成,有效记忆范围被控制在64个词语左右。因此,它带来的额外计算和存储开销几乎可以忽略不计,却能让每个词语的向量都承载更丰富的上下文信息。
这对“偷懒”的加速方法意味着什么?当模型进行稀疏计算,只查看少数关键片段时,这些被选中的片段,现在每一个都悄悄带着附近词语的记忆。即便标准答案所在的位置没被直接选中,其“残影”也可能通过附近被选中的片段传递过来,从而帮助模型做出正确判断。
三、三种“偷懒”方法都从中受益了吗
为了验证这个“记忆手册”是否真有普适性,研究团队选取了三种针对不同效率瓶颈的经典稀疏推理方法进行测试。
Quest主要在模型生成答案的每个步骤时“偷懒”,只调取最重要的几块信息。MoBA的思路类似,但作用于模型理解问题的阶段。SnapKV则更激进,它在理解完问题后,会直接丢弃大部分存储的中间信息,只保留精华部分。
测试非常严格。在同样的模型上,研究者分别使用原始架构和加了记忆模块的RAT+架构,以同样的“偷懒”比例运行上述三种方法。测试任务选自RULER基准,是一系列经典的“大海捞针”挑战——把关键信息深藏在冗长的无关文本中,考验模型精准检索的能力。任务难度从简单的单数字检索,到复杂的多组键值对匹配,跨度很大。
四、数字说话:记忆模块带来了多大的改善
实验结果一目了然。记忆模块在几乎所有任务和所有“偷懒”比例下,都带来了显著的准确率提升。
以SnapKV方法为例,在一个70亿参数的模型上,当只使用1/4的信息量时,RAT+架构比标准架构平均提升了超过34个百分点;当预算紧缩到1/8时,提升幅度扩大到40个百分点。在最极端的1/16预算下,简单检索任务的准确率从39.2%直接飙升至84.2%。
Quest方法在简单任务上表现原本就不错,差距主要体现在复杂任务上。例如,在多键匹配任务中,RAT+架构将准确率从70%多的水平,提升到了接近完美的99%。
MoBA在RAT+架构下的表现尤为亮眼。在1/16的极低信息预算下,八个测试任务的准确率几乎全部达到或逼近100%,而标准架构在同样条件下的准确率在一些任务上仅为50%左右。
更关键的是,这种改进不仅存在于从零训练的模型。研究团队在成熟的OLMo2-7B模型(由Allen AI研究所预训练)上也进行了验证。他们仅用100亿词语的额外训练(相对于原模型的数万亿训练量,微乎其微),就成功为模型加装了记忆模块。即便如此,效果依然显著:Quest在某个复杂任务上的准确率从68.0%跃升至98.6%。这证明,该思路具备向现有大型商业模型迁移的潜力。
五、为什么会有这样的效果?两个假设
面对如此一致的提升,研究团队深入探究了背后的原因,并提出了两个互补的假设。
假设一:记忆让选择更精准。 这好比图书馆管理员给书贴标签。标准架构下,标签只反映书本身的内容;而有了记忆模块,标签还隐含着“邻近书架有什么书”的线索。这样一来,为查询寻找目标时,定位自然更准。实验数据支持了这一假设:在RAT+架构下,模型内部负责检索的“注意力头”,其选中关键信息块的命中率确实更高。
假设二:记忆能弥补选择的失误。 即便选错了信息块,由于每个被选中的块都携带了更丰富的上下文记忆,答案的相关线索也可能被间接传递过来。为了验证这一点,研究者进行了一个巧妙的实验:他们将智能选择器换成随机选择器。如果提升 solely 源于“选得更准”,那么随机条件下两种架构的表现应该差不多。但结果显示,即便是随机选择,RAT+架构的准确率依然大幅领先。这强有力地证明了,记忆模块确实提升了每个信息块本身的“信息含金量”。
有意思的是,在这个随机选择实验中,SnapKV的表现反而超过了Quest。研究者的解释是:SnapKV只在开始时做一次随机选择,噪声是集中的;而Quest在生成每个词时都重新随机选择,噪声在整个过程中持续累积,干扰更大。
六、这项研究说明了什么更深层的道理
长期以来,高效AI推理的研究重心都放在设计更精巧的“偷懒”算法上。EPFL的这项研究开辟了另一个视角:通过改进模型的基础架构,使其内部表示天生蕴含更丰富的上下文信息,从而让任何一种“偷懒”方法都能站在更好的起跑线上。
这个视角的意义在于,它增加了一个新的优化维度。就像打好地基能让上层建筑更稳固一样,一个更好的基础架构可以让多种上层加速方法普遍受益。本研究测试的三种方法覆盖了不同的效率优化目标,它们全部从中获益,这暗示了该路径的普适性。
当然,这项研究也有其边界。所有实验均在4096个词语的上下文长度内进行,更长的文本场景效果如何尚未可知。评测任务也主要集中于“大海捞针”型检索,未广泛覆盖问答、摘要等更复杂的任务。此外,仅有三种加速方法被纳入测试。
尽管如此,这项研究清晰地指出了一个方向:让AI在“偷懒”时变得更聪明,除了教它更好的偷懒技巧,还可以赋予它更强的短期记忆能力。这对于未来处理长文本的AI系统设计而言,无疑是一个值得深入探索的新路径。
Q&A
Q1:RAT+里的“指数衰减记忆”到底是怎么工作的?
简单说,RAT+在模型处理每个词时,会将当前词的关键向量与前一时刻的向量按一个动态比例混合。这个比例由“门控信号”控制,决定了保留多少旧记忆、吸收多少新信息。远处词语的影响会指数级淡化,就像记忆自然消退。研究将有效记忆范围控制在64个词内,因此额外开销极小,却能显著增强每个向量的上下文信息。
Q2:Quest、MoBA和SnapKV这三种方法有什么区别?
三者针对的瓶颈不同:Quest在模型生成答案的每个步骤时“偷懒”,减少解码计算量,但保留完整存储。MoBA主要在理解问题时“偷懒”,同样保留完整存储。SnapKV最为激进,在理解问题后会丢弃大部分存储信息,只保留核心部分,因此同时节省了存储空间和后续计算量,但丢弃的信息无法找回。
Q3:OLMo2-7B加装记忆模块只需要训练100亿词语,这是否足够?
研究团队承认,100亿词语的训练量远少于OLMo2-7B原始的数万亿预训练数据,记忆模块的训练并不充分。为了公平比较,他们在评测前对两种架构都进行了针对性的有监督微调。即便如此,加装记忆模块的模型仍展现出显著优势,这说明该机制即便在训练有限的情况下也能带来实质改进。当然,如果给予更充分的训练,效果有望进一步提升。
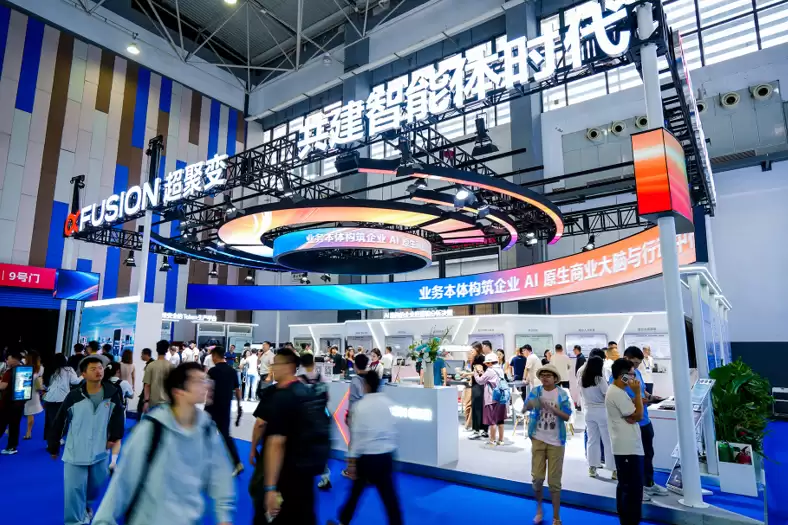
本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。
从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。
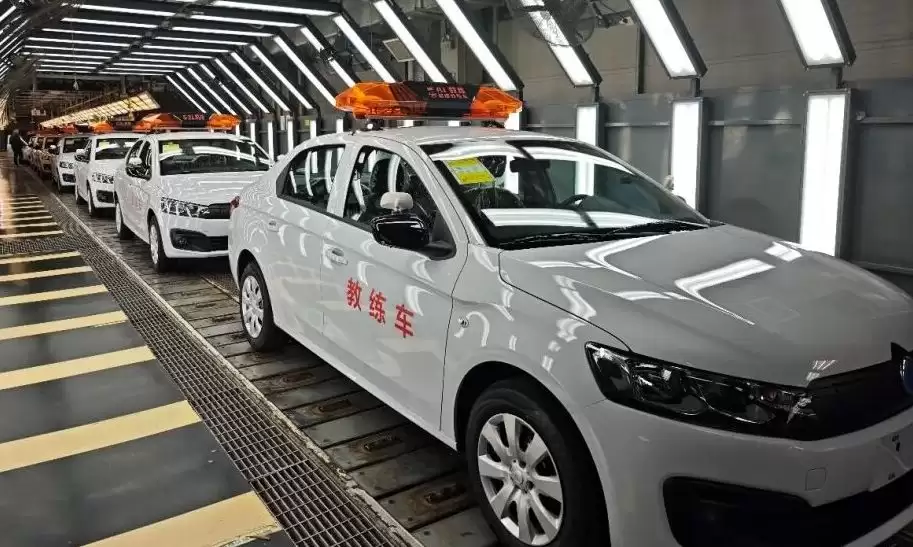
2026届高考生学车时多采用AI教练,逐步适应人机共驾。作为与生成式AI共同成长的一代,他们更易接受智能驾驶,未来可能成为首批“原生AI司机”。至2030年前后,其人生首辆车或具备L3级自动驾驶能力,驾驶角色将从操控者转向监督者。
全球股市因AI热潮呈现K型分化,半导体板块估值逼近百倍市盈率。历史警示:2000年互联网泡沫中的“四骑士”最终市值暴跌或长期盘整。投资者应警惕“错失恐惧症”,重视安全边际、护城河与能力圈,避免被高估值裹挟,关注稳健性与股息率。
Cloudflare报告显示,完成应用现代化的企业从AI投资中获得可衡量回报的概率是未现代化企业的三倍。93%的决策者视系统更新为AI先决条件,91%的领先企业已嵌入AI功能。安全与现代化协同推进可使AI成熟度提升四倍,精简技术架构成为竞争力分水岭。
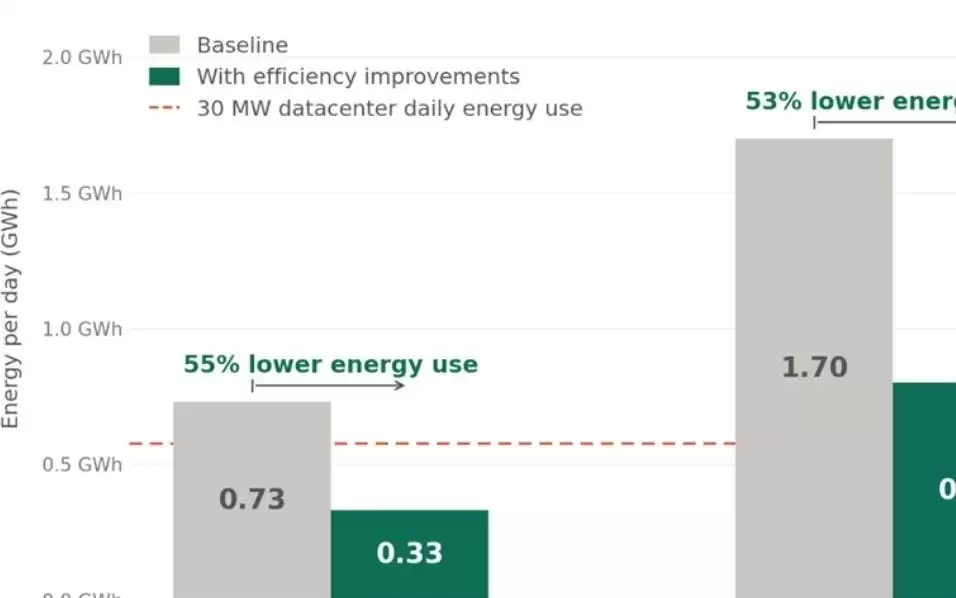
据微软引用《Joule》期刊的一项研究指出,每一次典型人工智能查询耗电量零点一六至零点六零瓦时,其冷却用水量中位数不足一滴水。大规模部署下,单位查询的效率会更高,总能耗可以降低一半以上。
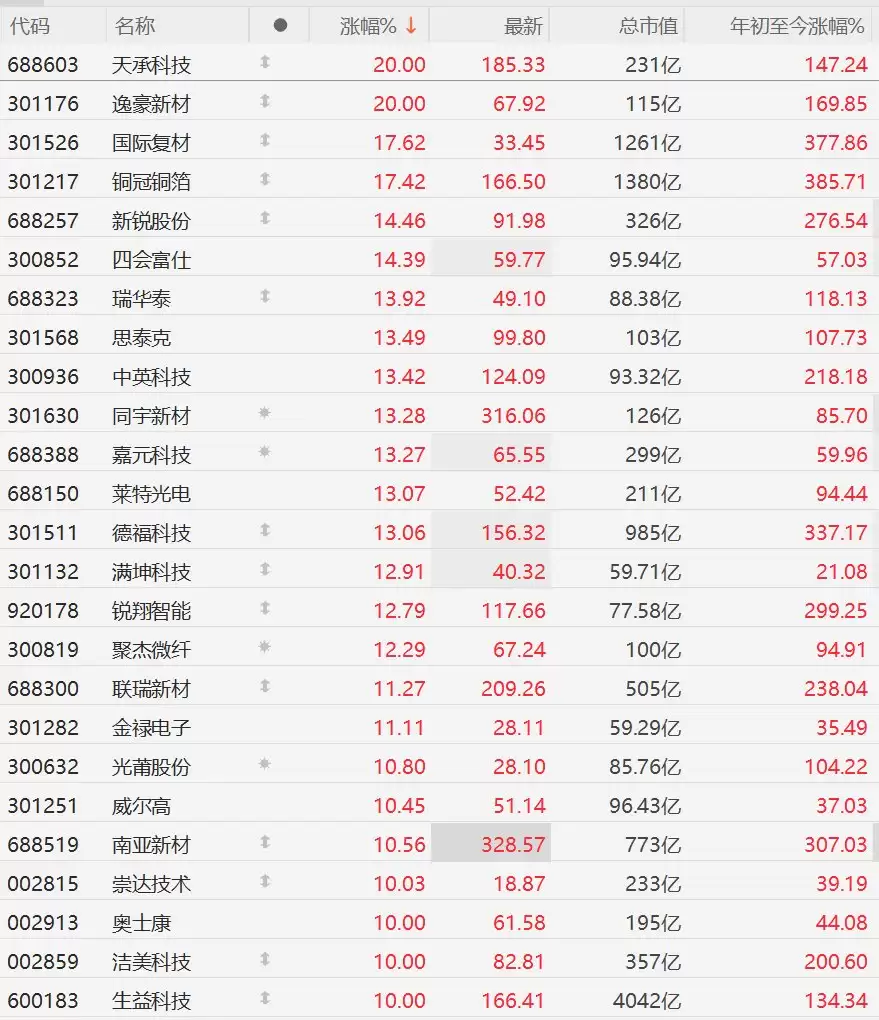
A股PCB概念板块掀起涨停潮,因摩根士丹利报告预测AI光模块PCB市场三年增长超5倍,2025至2028年规模从6.2亿美元增至37.7亿美元,年复合增速高达83%,远超光模块整体增速。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。