

Python开发中使用read()读取大文件导致内存溢出问题解决办法
Python开发中,使用read()一次性读取大文件常导致内存溢出。根本原因是整个文件被读入内存。解决方案是采用流式读取,如按行迭代、固定大小分块、mmap等,可控制内存占用。处理文本时应默认使用forlineinfile,处理二进制时用固定分块循环。
文件读写乍看起来没什么门槛——不就是打开文件、读数据、处理完收工吗?但说出来你可能不信,就这条“最简单的路”,恰恰是无数Python开发者翻过车的地方。
很多人习惯用f.read()一把梭,把整个文件一股脑儿塞进内存。小文件这么写确实省事,代码也干净。可一旦文件膨胀到几百MB甚至几个GB,这招就行不通了——轻则程序卡顿、系统慢得像蜗牛,重则直接抛出MemoryError,连个招呼都不打,进程就被操作系统干掉。理解这背后的机制,掌握流式读取的方法,才是写出靠谱数据处理程序的根基。

一、问题复现:一行read()引发的崩溃
with open('huge_log.txt', 'r') as f:
    content = f.read()
# 如果 huge_log.txt 大小为 10 GB,服务器内存只有 8 GB,
# 程序会卡死或抛出 MemoryError
执行上面几行代码后,运气好的话你会看到:
MemoryError
运气不好的话,啥都看不到——操作系统直接掐掉了Python进程(这在Linux上叫OOM Killer介入)。即便文件大小刚好没超过可用内存,read()也会瞬间把大量数据填进RAM,导致系统里其他进程被“挤出去”,整个环境严重拖慢。
二、底层原理:read()是“一口吞”
我们来看看read()到底干了什么。文件对象的read(size=-1)方法:
- 如果不传
size或传入负值,它会读取文件的全部剩余内容直到文件结束(EOF)。 - 返回一个字符串(文本模式)或字节串(二进制模式),这个对象在内存中是连续的,大小基本等于文件的原始字节数(Python字符串内部表示可能还会多出一些开销)。
所以处理大文件时,它要求的条件是:可用内存 ≥ 文件大小。但实际干活时,我们往往只需要一次看一行或一个数据块,完全没必要把整个文件同时放在内存里。
三、常见误区与陷阱场景
1. 使用readlines()同样危险
with open('huge.csv', 'r') as f:
    lines = f.readlines()   # 同样将所有行读入一个列表
readlines()一次性返回包含所有行的列表,每行是一个字符串。由于列表本身也有开销,内存占用比read()只大不小。
2. 对大文件使用splitlines()前先read()
content = f.read()
for line in content.splitlines():
    process(line)
这依然要把整个文件塞进内存,本质没有任何改变。
3. Pandas / JSON 等库隐含的全量读取
import pandas as pd
df = pd.read_csv('big_data.csv')   # 默认一次性加载全部数据
很多高级库虽然提供了分块读取参数,但如果你忘记设置,照样会内存爆炸。
四、解决方案:流式读取,按需加载
好在Python提供了多种优雅的流式处理方法,让内存占用只跟单次处理的数据块大小有关,而不随文件大小线性增长。
方案一:固定大小分块读取(二进制模式最可靠)
chunk_size = 4096  # 或 8192, 64*1024 等
with open('large_file.bin', 'rb') as f:
    while True:
        chunk = f.read(chunk_size)
        if not chunk:
            break
        # 处理 chunk (bytes)
- 适用场景:处理二进制文件,或进行简单文本处理(但需自行处理行边界)。
- 优点:内存占用恒定,文件再大都稳如老狗。
- 注意:文本模式下按字符读取,需注意多字节字符可能被截断。通常建议在二进制模式下处理非文本或自行解码。
方案二:将文件对象作为迭代器(按行读取)
以文本模式打开的文件对象是一个可迭代对象,它会逐行产出str。
with open('huge_log.txt', 'r', encoding='utf-8') as f:
    for line in f:
        process(line)
- 底层机制:文件对象内部有一个缓冲区,按需从磁盘读取数据并按换行符分割,每次只返回一行。内存中只保留当前行及少量缓冲数据,非常高效。
- 适用场景:日志分析、CSV初步过滤、任何基于行的文本处理。
- 额外好处:代码极简,不需要显式写
readline()循环。
注意:如果行特别长——比如单个JSON对象占一整行且高达数百MB——逐行迭代仍可能因为单行过大而内存暴涨。这时需要切换为分块读取并自行解析。
方案三:使用fileinput模块处理多个大文件
import fileinput

with fileinput.input(files=['log1.txt', 'log2.txt'], mode='r',
                     openhook=fileinput.hook_encoded('utf-8')) as f:
    for line in f:
        process(line)
fileinput同时串联多个文件,逐行遍历,自动关闭打开的文件。适合需要按行处理一系列大文件的场景,内存开销低。
方案四:内存映射文件——mmap
如果需要随机访问或部分读取大文件,可以使用mmap模块将文件映射到虚拟内存空间,由操作系统按需加载页。
import mmap

with open('huge.dat', 'r+b') as f:
    with mmap.mmap(f.fileno(), 0) as m:
        # m 是一个类似字节数组的对象,支持切片
        first_kb = m[:1024]
        # 可以通过 find 等方法高效搜索
        pos = m.find(b'ERROR')
mmap不会把整个文件读入物理内存,而是利用操作系统的内存页管理,只有实际访问的区域才会被加载。处理超大文件时性能极佳,随机访问也很方便。- 缺点:API是字节级操作,文本处理需要手动解码;不是所有文件(如管道或网络流)都支持
mmap。
方案五:利用高级库的分块参数
很多数据处理库原生支持流式读取:
- Pandas:
pd.read_csv('data.csv', chunksize=10000)返回一个迭代器,每次产出一个包含chunksize行的DataFrame。for chunk in pd.read_csv('big.csv', chunksize=50000): # 对 chunk 进行操作 - JSON:使用
ijson库进行增量解析,避免一次性加载整个JSON对象。 - XML:
xml.etree.ElementTree的iterparse支持流式处理。 - SQLAlchemy:使用
yield_per()分批获取查询结果。
五、内存与性能对比
| 方法 | 内存占用 | 适用场景 | 复杂度 |
|---|---|---|---|
f.read() | 等于文件大小 | 小文件(< 几MB) | 极简 |
f.readlines() | 大于文件大小(+ 列表开销) | 小文件读所有行 | 简单 |
for line in f | 约等于最长行的字节数 | 基于行的文本处理 | 极简 |
分块 f.read(chunk_size) | 固定为 chunk_size | 任意二进制或需定界解析的文本 | 简单 |
mmap | 恒常低内存(页缓存) | 需要随机访问的巨大文件 | 中等 |
pandas chunksize | 单块大小 | 表格数据分析 | 简单 |
这里必须说清楚一点:流式读取在内存上确实占据绝对优势,但如果处理逻辑需要同时知道所有数据——比如全局排序、全数据集统计分析——单纯靠流式读取解决不了。这时可能需要外部排序、数据库或采样等其他技术。
六、调试与监控
1. 使用memory_profiler分析内存
# pip install memory_profiler
from memory_profiler import profile

@profile
def read_large():
    with open('big.txt') as f:
        return f.read()
运行这个脚本会输出每行代码的内存增量,read()的暴涨一目了然。
2. 估算文件大小
用os.path.getsize()获取文件大小,再决定是否使用流式读取:
import os

def smart_open(path, chunk_threshold=50*1024*1024):  # 50 MB
    size = os.path.getsize(path)
    if size < chunk_threshold:
        with open(path) as f:
            return f.read()
    else:
        # 返回一个生成器,按行读取
        with open(path) as f:
            for line in f:
                yield line
3. 操作系统工具
- Linux:
htop/free -m观察进程内存。 - Windows:任务管理器。
psutil库在代码中监控进程内存:import psutil, os process = psutil.Process(os.getpid()) print(process.memory_info().rss) # 字节
七、最佳实践总结
- 永远别觉得“文件肯定不大”。用户输入、生产环境日志随时可能膨胀。
- 默认使用
for line in file处理文本,这是Pythonic且安全的习惯。 - 处理二进制文件,用固定大小的
while chunk := f.read(CHUNK):循环。 - 面对结构化数据,先查查相关库有没有流式API(如
chunksize、iterparse)。 - 如果函数封装了文件读取逻辑,别返回整个文件内容,改返回一个生成器或文件对象本身,让调用方去迭代。
- 写单元测试时,用大文件(比如生成几百MB的临时文件)验证流式逻辑,防止重构后退化成全量读取。
- 注意关闭文件和上下文管理,流式读取时依然要用
with语句,确保文件描述符不泄漏。
八、结语
“用read()读取大文件导致内存溢出”这个坑,从刚入门的新手到经验丰富的工程师都可能踩进去。最麻烦的地方在于:测试环境和少量数据下一切正常,换到真实环境、数据量一暴涨,瞬间崩盘。流式读取不是什么高深技巧,它是Python文件处理的基本素养。把它变成肌肉记忆——看到 f.read() 时,先问自己:“这个文件可能有多大?”——你就能避开无数头疼的问题,写出稳健、可扩展的数据处理程序。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
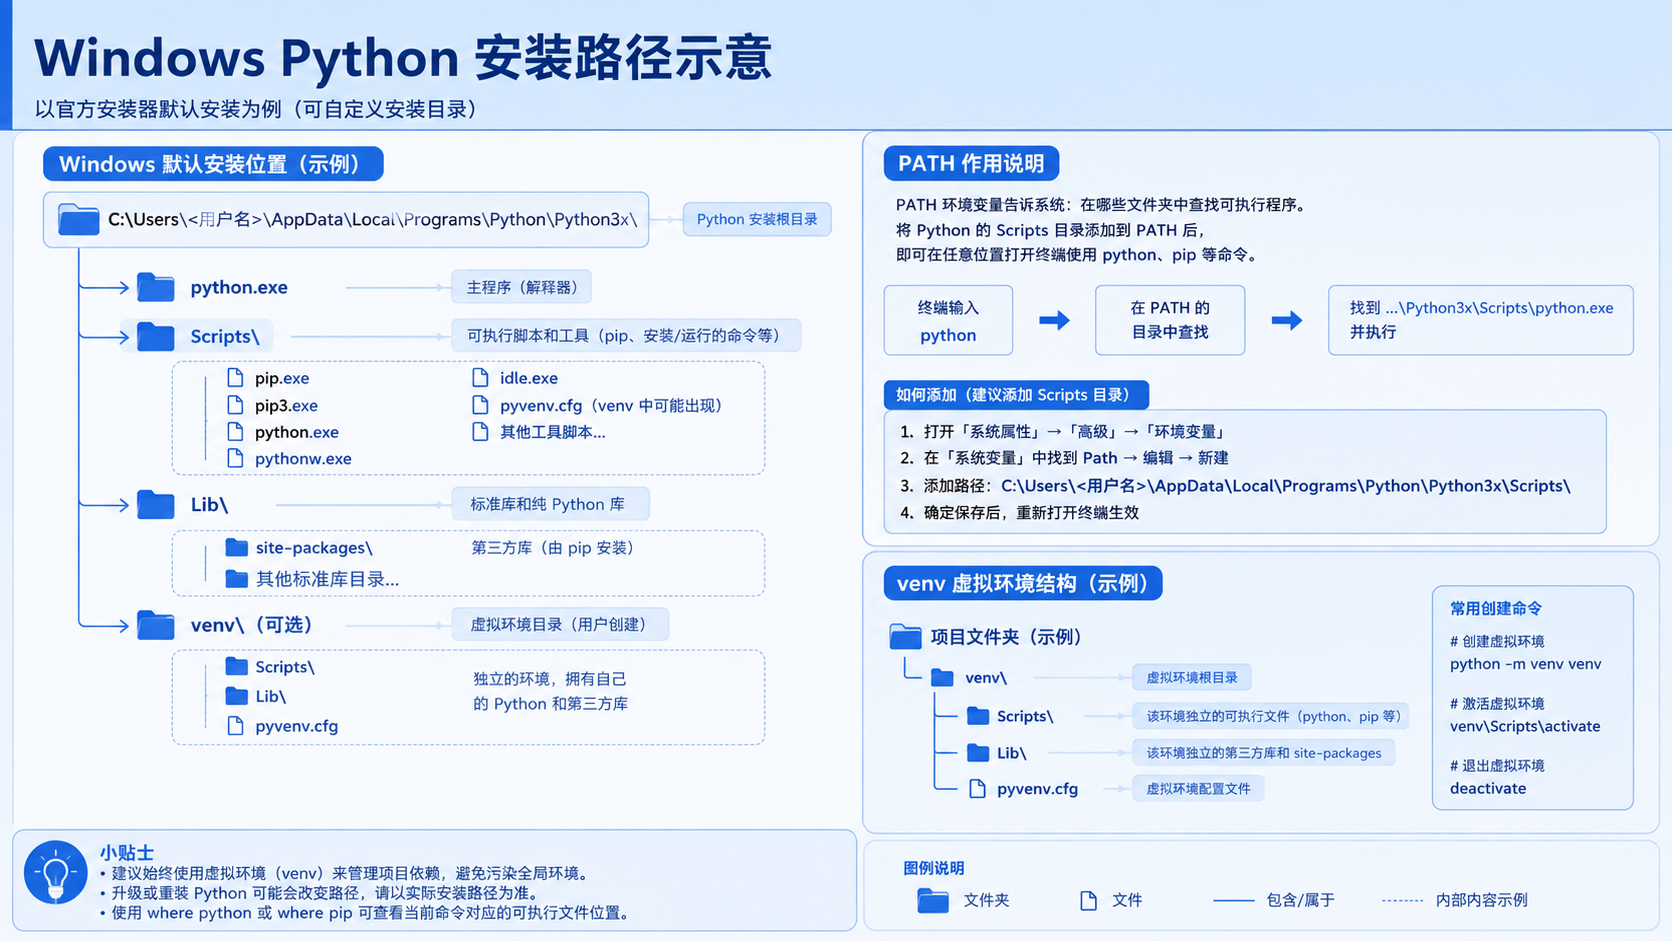
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
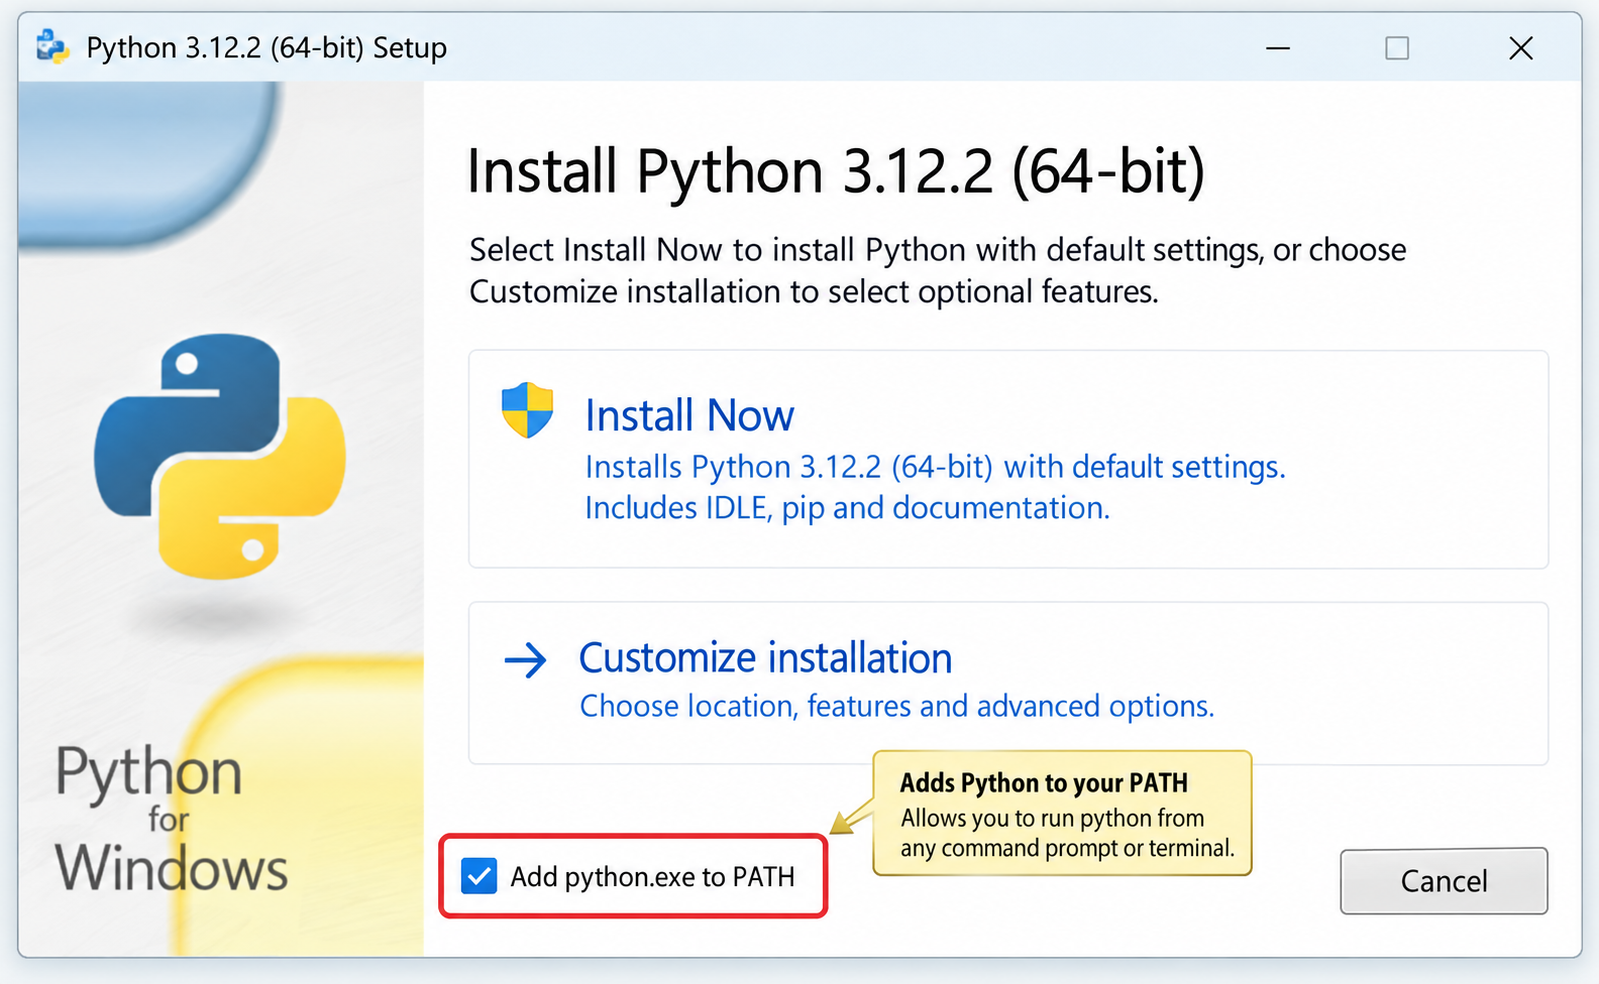
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
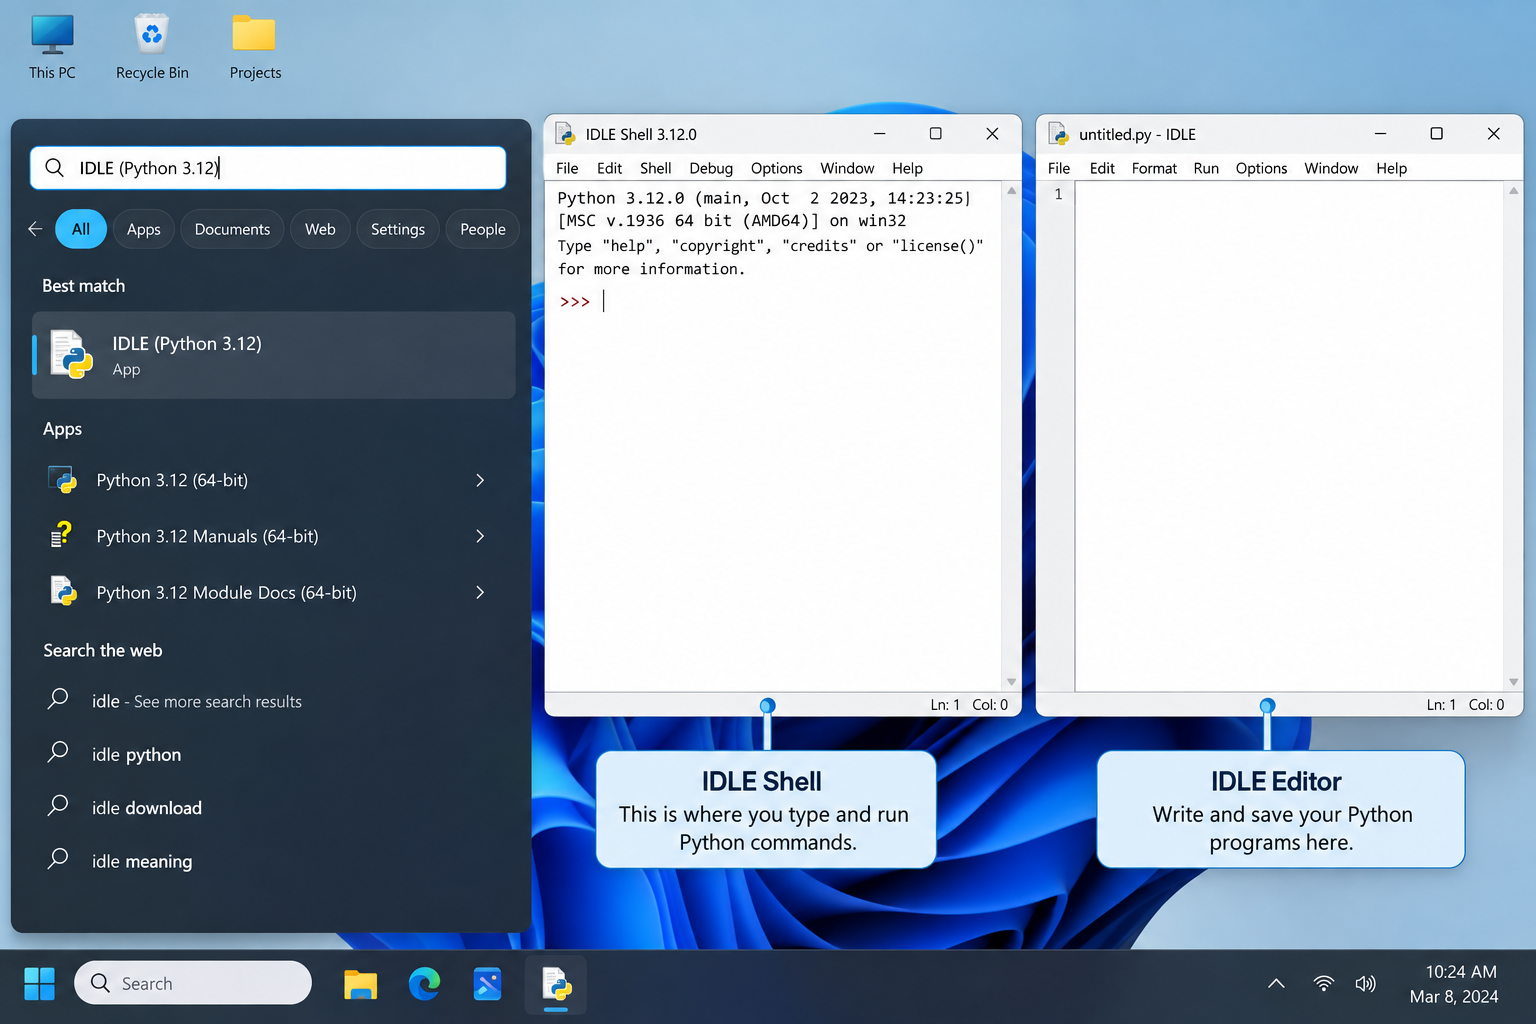
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
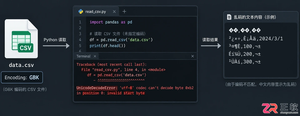
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
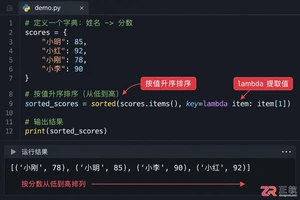
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
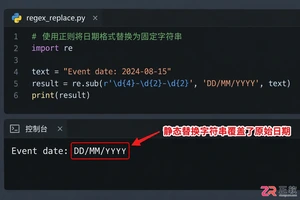
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
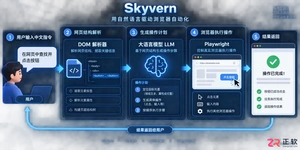
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。