

Python模块multiprocessing&实现多进程并发方式
Pythonmultiprocessing模块提供基于进程的并发方案,充分利用多核CPU优势。核心组件包括Process(创建子进程)、Queue和Pipe(进程间通信)、Pool(进程池管理)及Lock(同步锁),支持守护进程、状态监测与多任务并行执行,适用于CPU密集型任务加速,显著提升性能。
说到Python的多进程编程,multiprocessing 模块绝对是绕不开的核心工具。它基于进程而非线程,能真正利用多核CPU的优势,让程序跑得更快,同时提供了进程间通信和数据共享的完整方案。下面就把这个模块的用法拆开揉碎了聊一聊。
1. 参数说明
1.1. Process(控制进程)
用于创建子进程对象,必须指定要执行的目标函数。Process(target = [函数名])
语法
multiprocessing.Process(
    target   #必选参数,表示进程所执行的目标函数。
    group    #预留参数,不需要使用。
    name     #指定子进程的名称,通过 [子进程].name 获取
    args     #指定子进程(函数)需要传递的参数,以元组方式传递,例如:args=('A', 'B', 'C')
    kwargs   #指定子进程(函数)需要传递的参数,以字典方式传递,例如:args={'name':'xiaowang', 'age':18}
    daemon   #将子进程设置为守护进程(True|False)。
)
- 守护进程:主进程退出后,不论该子进程是否结束,强制退出。
- 非守护进程:主进程退出后,子进程若未结束,会继续执行。
所有方法如下
p = multiprocessing.Process(target = xxx)

    p.run       #表示进程在启动后要执行的方法,需要应用程序开发人员重写。
    p.start     #启动进程。
    p.join      #等待进程终止。
    p.is_alive  #判断进程是否存活。
    p.ident     #获取子进程PID
    p.name      #获取子进程名称
    p.kill      #强制结束子进程。
    p.terminate #强制结束子进程。
    p.close     #关闭与进程关联的所有管道和文件。
    authkey     #返回用于身份验证的进程通信的密钥。
1.2. Queue(进程通信)
用于实现进程间通信的队列,支持多个进程向同一个队列中读写数据。
参数选项
multiprocessing.Queue([maxsize])
- maxsize(可选)参数是一个int型整数,用于指定队列中最多可以存放的实例数,超过此值会保持阻塞,直到队列中有位置出现。
- 如果maxsize是负数,则表示队列的长度为无限。如果maxsize是零,则表示队列的长度为无限。
- 但由于诸如pickle等协议的缘故,正在发送或接收的大型对象可能会导致程序死锁,因此不建议这样使用。
所有方法如下
'''向消息队列发送信息'''
Queue.put(item[, block[, timeout]])
    #如果block参数是True,而且队列已满,那么程序就会在队列有空间之前停滞等待。
    #如果block参数是False,并且队列已满,那么就会引发Full异常。
    #如果给出了可选参数timeout,它会阻塞timeout秒。
'''向消息队列发送信息,如果队列已满,会引发Full异常,'''
Queue.put_nowait(item)
    #等同于Queue.put(item, False)。

'''获取队列中元素并删除'''
Queue.get([block[, timeout]])
    #如果队列为空,且block参数为True,那么程序会一直停滞等待,或者阻塞timeout秒。
    #如果block参数是False,而且队列为空,那么就会引发Empty异常。
'''获取队列中元素并删除,如果队列为空则引发Empty异。'''
Queue.get_nowait()

'''关闭进程间通信通道,以防止有些进程被阻塞,从而导致程序死锁或者内存泄露'''
Queue.close()

'''判断队列是否为空'''
Queue.empty()    #为空返回True,不为空返回False。
'''判断队列是否已满'''
Queue.full()     #队列已满返回True,未满返回False。

'''获取队列中的元素个数'''
Queue.qsize()    #注意:此方法不可靠,因为在 Queue.put() 和 Queue.get() 方法的过程中仍然可能发生改变。
1.3. Pipe(管道通信)
创建进程间通信管道,支持两个进程之间的通信。
语法
multiprocessing.Pipe([duplex])
duplex:是否创建一个双向通信的管道(默认True),代表创建一个双向管道。如果设置为False,则创建一个单向管道(只能从某一端写入数据,从另一端读出数据)。
所有方法如下
'''向管道中写入消息'''
Pipe.send('消息')    #如果发送失败会抛出 BrokenPipeError 异常。
'''从管道中读取数据,会阻塞直到有数据可读'''
Pipe.recv():         #如果管道已关闭,则会返回一个 EOFError 异常。

'''关闭管道'''
Pipe.close()

'''返回管道的文件描述符'''
Pipe.fileno()

'''判断读取管道是否阻塞(如果管道可读或者关闭,返回True)'''
Pipe.poll([timeout]) #如果设置了 timeout,则会在指定时间内返回。

'''二进制数据-向管道中写入消息'''
Pipe.send_bytes(buf[, offset[, size]]) #与send一样功能,但是接受的参数为二进制字符串。
'''二进制数据-从管道中读取数据'''
Pipe.recv_bytes([maxlength])           #与recv类似,但是返回的是二进制字符串。
1.4. Pool(进程池)
语法
multiprocessing.Pool(
    processes         #可选参数,指定进程池中的线程数(默认CPU最大数)
    initializer       #可选参数,指定每个工作进程启动时要调用的函数。默认值为 None。
    initargs          #可选参数,指定传递给初始化器函数的参数元组。默认值为 ()。
    maxtasksperchild  #可选参数,限制每个工作进程可以执行的任务数量,然后被终止,以避免内存泄漏问题。默认值为 None,表示进程将一直存在。
)
所有方法如下
Pool.[方法]

'''进程池中同步执行函数, 类似于 func(*args, **kwds) 表达式'''
Pool.apply(func, args=(), kwds={})    #如果进程池中的一个进程崩溃,那么就将函数重新提交到池中。

'''在进程池中异步执行函数'''
apply_async(func, args=(), callback=None)  #支持回调函数。

'''进程池中同步执行函数,将执行结果存储于列表中返回, 类似于 map(func, iterable) 表达式'''
Pool.map(func, iterable, chunksize=None)  #返回一个包含结果的列表。如果进程池中的一个进程崩溃,那么就将函数重新提交到池中。

'''进程池中异步执行函数,并返回生成器对象, 可以逐个获取函数执行结果'''
Pool.imap(func, iterable, chunksize=1)  #这可以在内存有限的情况下处理大型数据集。如果进程池中的一个进程崩溃,那么就将函数重新提交到池中。

'''类似于 imap() 函数,但是结果不保证按照迭代器的顺序产生'''
Pool.imap_unordered(func, iterable, chunksize=1)  #如果进程池中的一个进程崩溃,那么就将函数重新提交到池中。

'''关闭进程池'''
Pool.close()

'''等待所有进程完成'''
Pool.join()

'''强制关闭所有进程'''
Pool.terminate()
1.5. Lock(进程锁)
语法
multiprocessing.Lock(locking = True)
    locking=True:使用底层操作系统提供的锁机制,例如 POSIX 信号量或 Windows 临界区。这是默认值。
    locking=False:会更快地获取和释放锁,但是在一些平台上可能会出现未定义的行为。
所有方法如下
'''获取锁'''
Lock.acquire(block=True, timeout=None)  #如果 block=True,则会阻塞直到获取到锁,否则立即返回。如果 timeout 不是 None,则在超时之前没有获取到锁就会抛出 TimeoutError 异常。如果锁已经被当前进程持有,则会抛出 AssertionError 异常。
'''释放锁'''
Lock.release()  #如果锁没有被当前进程持有,则会抛出 AssertionError 异常。

Lock.locked()            #返回当前锁是否被持有的布尔值。
Lock.notify(n=1)         #唤醒 wait() 方法中等待锁的 n 个线程。
Lock.notify_all()        #唤醒 wait() 方法中等待锁的所有线程。
Lock.wait(timeout=None)  #等待锁。如果锁已经被释放,则会立即返回。如果锁仍然被持有,则会释放锁,并阻塞直到其他线程唤醒该线程或者超时,则会抛出 TimeoutError 异常。
2. 进程管理
2.1. 判断子进程状态
通过is_alive 判断某个子进程是否存活
import multiprocessing
from time import sleep

# 定义一个函数(作为子进程)
def proc():
    print('=========== 子进程开始运行 ===========')
    sleep(3)
    print('=========== 子进程运行结束===========')

if __name__ == '__main__':
    # 将函数proc定义为子进程
    p = multiprocessing.Process(target=proc)

    # 启动子进程
    p.start()

    # 判断子进程是否结束
    while p.is_alive():
        print('[CHECK] 子进程运行中')
        sleep(1)
    else:
        print('子进程已死亡!')
结果
[CHECK] 子进程运行中
=========== 子进程开始运行 ===========
[CHECK] 子进程运行中
[CHECK] 子进程运行中
[CHECK] 子进程运行中
=========== 子进程运行结束===========
子进程已死亡!
2.2. 获取子进程信息
获取子进程名称和PID
import multiprocessing

def proc1():
    '''模仿一个子进程'''
    pass

def proc2():
    '''模仿一个子进程'''
    pass

if __name__ == '__main__':
    # 创建2个子进程
    p1 = multiprocessing.Process(target=proc1, name='【自定义的p1】')
    p2 = multiprocessing.Process(target=proc2)

    # 启动进程1
    p1.start()
    # 启动进程2
    p2.start()

    # 获取子进程的名称和PID
    print(f'进程1的名称为:{p1.name}, PID为:{p1.ident}')
    print(f'进程2的名称为:{p2.name}, PID为:{p2.ident}')
- 可以通过参数 name 设置子进程名称,未设置默认Process-[n]
结果
进程1的名称为:【自定义的p1】, PID为:20136
进程2的名称为:Process-2, PID为:15816
2.3. 子进程执行多任务
实现简单的多任务执行
import multiprocessing
import time

def progress1():
    '''模仿一个子进程'''
    for i in range(1,6):
        print(f'[{i}/5] 这是进程1,每隔1s输出一次...')
        time.sleep(1)

def progress2():
    '''模仿一个子进程'''
    for i in range(1,5):
        print(f'[{i}/4] 这是进程2,每隔2s输出一次...')
        time.sleep(2)

if __name__ == '__main__':
    # 创建2个子进程
    p1 = multiprocessing.Process(target=progress1)
    p2 = multiprocessing.Process(target=progress2)

    # 启动进程1
    p1.start()
    # 启动进程2
    p2.start()

    # 程序执行其他事情
    time.sleep(1)
    print('=============== 结束 =============== ')
输出结果(主进程并没有去等待子进程结束,直接做其他事)
[1/5] 这是进程1,每隔1s输出一次...
[1/4] 这是进程2,每隔2s输出一次...
=============== 结束 ===============
[2/5] 这是进程1,每隔1s输出一次...
[3/5] 这是进程1,每隔1s输出一次...
[2/4] 这是进程2,每隔2s输出一次...
[4/5] 这是进程1,每隔1s输出一次...
[3/4] 这是进程2,每隔2s输出一次...
[5/5] 这是进程1,每隔1s输出一次...
[4/4] 这是进程2,每隔2s输出一次...
使用 join 等待某个子进程结束再运行主进程
import multiprocessing
import time

def progress1():
    '''模仿一个子进程'''
    for i in range(1,6):
        print(f'[{i}/5] 这是进程1,每隔1s输出一次...')
        time.sleep(1)

def progress2():
    '''模仿一个子进程'''
    for i in range(1,5):
        print(f'[{i}/4] 这是进程2,每隔2s输出一次...')
        time.sleep(2)

if __name__ == '__main__':
    # 创建2个子进程
    p1 = multiprocessing.Process(target=progress1)
    p2 = multiprocessing.Process(target=progress2)

    # 启动进程1
    p1.start()
    # 启动进程2
    p2.start()

    # 等待子进程结束
    p1.join()
    p2.join()

    # 程序执行其他事情
    print('=============== 结束 =============== ')
结果
[1/5] 这是进程1,每隔1s输出一次...
[1/4] 这是进程2,每隔2s输出一次...
[2/5] 这是进程1,每隔1s输出一次...
[2/4] 这是进程2,每隔2s输出一次...
[3/5] 这是进程1,每隔1s输出一次...
[4/5] 这是进程1,每隔1s输出一次...
[3/4] 这是进程2,每隔2s输出一次...
[5/5] 这是进程1,每隔1s输出一次...
[4/4] 这是进程2,每隔2s输出一次...
=============== 结束 ===============
将 进程1(p1) 设置为守护进程(随主进程退出而退出)
import multiprocessing
import time

def progress1():
    '''模仿一个子进程'''
    for i in range(1,6):
        print(f'[{i}/5] 这是进程1,每隔1s输出一次...')
        time.sleep(1)

def progress2():
    '''模仿一个子进程'''
    for i in range(1,5):
        print(f'[{i}/4] 这是进程2,每隔2s输出一次...')
        time.sleep(2)

if __name__ == '__main__':
    # 创建2个子进程
    p1 = multiprocessing.Process(target=progress1, name='【自定义的p1】', daemon=True)
    p2 = multiprocessing.Process(target=progress2)

    # 启动进程1
    p1.start()
    # 启动进程2
    p2.start()

    # 程序执行其他事情
    time.sleep(2)
    print('====================== 结束 ======================')
    print(f'进程1的名称为:{p1.name}, PID为:{p1.ident}')
    print(f'进程2的名称为:{p2.name}, PID为:{p2.ident}')
    print('====================== 结束 ======================')
结果
[1/5] 这是进程1,每隔1s输出一次...
[1/4] 这是进程2,每隔2s输出一次...
[2/5] 这是进程1,每隔1s输出一次...
====================== 结束 ======================
进程1的名称为:【自定义的p1】, PID为:21252
进程2的名称为:Process-2, PID为:21253
====================== 结束 ======================
[2/4] 这是进程2,每隔2s输出一次...
[3/4] 这是进程2,每隔2s输出一次...
[4/4] 这是进程2,每隔2s输出一次...
2.4. 运行多个并发
通过循环的方式去构造多个并发
import multiprocessing
from time import sleep

class MyClass(object):
    def __init__(self, thread_num=1, sleep_proc=None):
        # thread_num表示进程数,sleep_proc表示是否等待退出
        self.thread_num = thread_num
        self.sleep_proc = sleep_proc

    def proc(self):
        # 定义一个并发的子进程
        for i in range(1,4):
            print(f'[{i}/3] 我是一个子进程')
            sleep(1)

    def call_proc(self):
        # 调用子进程
        processes = []
        # 循环调用多个子进程
        for num in range(self.thread_num):
            # 定义子进程属性
            p = multiprocessing.Process(target=MyClass().proc)
            # 启动子进程
            p.start()
            # 将循环的子进程放入列表,用于后面的等待退出
            processes.append(p)

        # 判断是否等待子进程结束
        if self.sleep_proc is True:
            for p in processes:
                p.join()

if __name__ == '__main__':
    # 指定2个并发,并等待子进程结束
    mc = MyClass(2,True)
    mc.call_proc()

    print('=============== 结束 ===============')
结果
[1/3] 我是一个子进程
[1/3] 我是一个子进程
[2/3] 我是一个子进程
[2/3] 我是一个子进程
[3/3] 我是一个子进程
[3/3] 我是一个子进程
=============== 结束 ===============
2.5. 强制杀死子进程
通过 terminate 或者 kill 强制杀死子进程
import multiprocessing
from time import sleep

# 定义2个函数(作为子进程)
def proc1():
    print('=========== 子进程1开始运行 ===========')
    sleep(10)
    print('=========== 子进程1运行结束===========')

def proc2():
    print('=========== 子进程2开始运行 ===========')
    sleep(10)
    print('=========== 子进程2运行结束===========')

if __name__ == '__main__':
    # 将函数定义为子进程
    p1 = multiprocessing.Process(target=proc1)
    p2 = multiprocessing.Process(target=proc2)

    # 启动子进程
    p1.start()
    p2.start()

    # 3秒后手动杀死子进程
    sleep(3)
    p1.kill()       #使用kill杀死子进程
    p2.terminate()  #使用terminate杀死子进程
    print('子进程p1、p2已被强制杀死!')

3. 进程间的通信
进程间通信(IPC,Interprocess communication)是一组编程接口,让程序员能够协调不同的进程,使之能在一个操作系统里同时运行,并相互传递、交换信息。这使得一个程序能够在同一时间里处理许多用户的要求。因为即使只有一个用户发出要求,也可能导致一个操作系统中多个进程的运行,进程之间必须互相通话。IPC接口就提供了这种可能性。
python 的 multiprocessing 模块中,可以使用 Queue、Pipe、Manager 等数据结构实现进程间通信(IPC),也就是进程之间交换数据。进程间通信是多进程编程中非常重要和常见的一部分,通常用于在多个进程之间共享并传递信息、数据或任务结果。
3.1. Queue 进程通信
from multiprocessing import Process, Queue
from time import sleep


def proc1(q):
    '''这是一个发送消息的函数'''
    msgs = ["香蕉", "苹果", "水蜜桃"]
    for msg in msgs:
        # 将迭代对象放入通信队列
        q.put(msg)
        # 打印当前迭代的内容
        print(f"[进程1] 发送信息({msg})")
        sleep(1)
    # 迭代完成后关闭通信
    q.close()


def proc2(q):
    '''这是一个接收消息的函数'''
    while True:
        try:
            # 删除通信队列中的一个元素
            msg = q.get(block=False)
            print(f"[进程2] 收到信息({msg}), 并删除该信息")
        except:
            q.close()   # 通信完成后关闭
            break
        sleep(1)


if __name__ == '__main__':
    # 使用Queue方法通信
    q = Queue()
    # 定义子进程属性,将 Queue 方法传入子进程
    p1 = Process(target=proc1, args=(q,))
    p2 = Process(target=proc2, args=(q,))

    # 启动2个子进程
    p1.start()
    p2.start()

    # 等待2个子进程结束
    p1.join()
    p2.join()

    print("=============== 结束 ===============")
- 进程1发送信息,进程2读取信息并删除队列(生产者-消费者)

逻辑视图

3.2.Queue控制多个子进程
- 设置多个子进程,一个用于控制,其他执行对应程序
- 控制的方法:运行子进程通过消息队列判断是否继续运行。
若消息队列为空,继续运行子进程;若消息队列不为空,停止子进程。由控制子进程决定
from multiprocessing import Process,Queue
from time import sleep


class MyClass(object):
    def __init__(self, time):
        self.time = time    #指定n秒后退出子进程
        self.q = Queue()    #将Queue赋值给公共方法

    def sed_msgs(self):
        '''该方法决定子进程是否退出'''
        sleep(self.time)    #按指定时间休眠
        self.q.put('over')  #休眠后向消息队列发送一条消息
        self.q.close()      #关闭通信

    def proc1(self):
        '''这是一个子进程,当消息队列不为空则停止运行'''
        while self.q.empty():
            print('[进程1] 执行当前任务...')
            sleep(1)
        self.q.close()

    def proc2(self):
        '''这是一个子进程,当消息队列不为空则停止运行'''
        while self.q.empty():
            print('[进程2] 执行当前任务...')
            sleep(1)
        self.q.close()

if __name__ == '__main__':
    mc = MyClass(3)     #给定休眠时间3s

    # 定义子进程
    s1 = Process(target=mc.sed_msgs)
    p1 = Process(target=mc.proc1)
    p2 = Process(target=mc.proc2)
    communication = [s1, p1, p2]

    # 启动所有子进程
    for s in communication:
        s.start()

    # 等待所有子进程结束
    for s in communication:
        s.join()

    print('====================== 结束 ======================')

逻辑视图

3.3. Pipe 管道通信
Pipe()支持多个进程间的管道通信。管道可以被多个进程访问,但是一次只能有一个进程对管道进行操作。
Pipe()赋值给两个对象:p1,p2 =Pipe(),p1是发送消息的方法,p2是接收消息的方法。
定义2个进程,分别向管道中发送消息和接收消息
from multiprocessing import Pipe, Process

class MyClass(object):
    '''定义2个管道和2个进程,相互发送和接收消息'''
    def __init__(self):
        # parent_conn表示发送消息,child_conn表示接收消息
        self.parent_conn1, self.child_conn1 = Pipe()
        self.parent_conn2, self.child_conn2 = Pipe()

    def proc1(self):
        # 向管道1中发送消息
        self.parent_conn1.send('苹果')
        # 接收管道2中的消息
        received_message = self.child_conn2.recv()
        print(f'[进程1] 收到的消息是:{received_message}')
        # 关闭管道1
        self.parent_conn1.close()

    def proc2(self):
        # 接收管道1中的消息
        received_message = self.child_conn1.recv()
        print(f'[进程2] 收到的消息是:{received_message}')
        # 向管道2中发送消息
        self.parent_conn2.send('香蕉')
        # 关闭管道2
        self.parent_conn2.close()

if __name__ == '__main__':
    mc = MyClass()

    # 创建子进程
    p1 = Process(target=mc.proc1)
    p2 = Process(target=mc.proc2)

    # 启动子进程
    p1.start()
    p2.start()

    # 等待子进程结束
    p1.join()
    p2.join()

    print('=================== 结束 ===================')

说明:
进程1向管道1中发送一条消息(苹果),发送完成之后接收管道2消息,如果没有则等待。
进程2接收管道1的消息并输出,再向管道2中发送一条消息(香蕉)。

4. 进程池
4.1. 同步与异步并发区别
- 同步(阻塞):同步并发类似于串行。例如A、B两个进程,必须A执行完成后才能执行B;若A出现意外(一直阻塞),那么B将无法执行。
- 异步(非阻塞):异步并发在执行多任务时不会出现相互阻塞的情况(进程池限制除外)。如有A、B两个进程,他们俩可以同时进行,不会出现相互等待的情况。
同步的简单代码如下
from multiprocessing import Pool
from time import sleep

def proc1():
    '''子进程1'''
    for i in range(2):
        print(f'[进程1] 执行{i}...')
        sleep(1)

def proc2():
    '''子进程2'''
    for i in range(2):
        print(f'[进程2] 执行{i}...')
        sleep(1)

if __name__ == '__main__':
    # 定义进程池
    pool = Pool()
    # 同步执行2个子进程
    pool.apply(proc1)
    pool.apply(proc2)
    # 关闭和等待子进程结束
    pool.close()
    pool.join()
使用
pool.apply ([函数名])
定义同步执行:先执行 proc1,再执行 proc2
使用异步
pool.apply_async ([函数名])
(将上述代码 apply 修改为 apply_async 即可) # 异步执行2个子进程
pool.apply_async (proc1)
pool.apply_async (proc2)
其结果为:proc1 和 proc2 同时执行

4.2. 异步调用多个子进程
进程池异步并发的基本使用方法
'''定义子进程'''
def start_func():
    pass
def proc1():
    pass
def proc2():
    pass

if __name__ == '__main__':
    # 定义进程池,设置属性
    pool = Pool(processes=1, maxtasksperchild=2, initializer=start_func)
    # 异步启动子进程(子进程为指定的某个函数)
    pool.apply_async(proc1)
    pool.apply_async(proc2)
    # 关闭和等待子进程结束
    pool.close()
    pool.join()
- processes:并发数(默认为系统最大CPU数)。如果将并发数设置为1,即使进程池中有2个进程,也会按同步的方式执行。一般设置不超过CPU数,最好等于子进程数。
- maxtasksperchild:可以限制在处理完一定数量的任务后重建进程池中的工作进程,以避免内存泄漏和资源泄漏等问题。使用
maxtasksperchild参数时需要权衡性能和资源利用率之间的平衡。如果你将maxtasksperchild设置得太小,进程重建的成本可能会显著影响性能。如果你将maxtasksperchild设置得太大,那么可能会导致内存泄漏或资源泄漏。需要根据具体情况进行调整。 - initializer:指定每个工作进程启动时要调用的函数(func)。如果子进程只有2个,而processes 设置为3,那么将会调用3次 func。
进程池中有4个子进程,仅使用2个并发(A、B、C、D,先执行AB,再执行CD)
from multiprocessing import Pool
from time import sleep

def start_func():
    print('启动前此函数')

def proc1():
    '''子进程'''
    for i in range(2):
        print(f'[进程1] 执行{i}...')
        sleep(1)

def proc2():
    '''子进程'''
    for i in range(2):
        print(f'[进程2] 执行{i}...')
        sleep(1)

def proc3():
    '''子进程'''
    for i in range(2):
        print(f'[进程3] 执行{i}...')
        sleep(1)

def proc4():
    '''子进程'''
    for i in range(2):
        print(f'[进程4] 执行{i}...')
        sleep(1)

if __name__ == '__main__':
    # 定义进程池,设置属性
    pool = Pool(processes=2, initializer=start_func)
    func_list = [proc1, proc2, proc3, proc4]
    for i in func_list:
        pool.apply_async(i)
    # 关闭和等待子进程结束
    pool.close()
    pool.join()
结果如下:

如果将processes 设置为 4,那么4个进程将会同时进行

4.3. 进程池的高并发
- 使用 map 或 imap 迭代来高效完成工作
使用 map(同步) 执行高并发。会自动等待子进程完成后,才会进行执行主进程。
from multiprocessing import Pool

def proc(num):
    print(f'我是子进程')

if __name__ == '__main__':
    # 定义线程池,设置并发数为5
    pool = Pool(5)
    # 使用map向函数传入多个参数(每传入一个参数则会调用一次函数,同时调用的数量由进程数决定)
    pool.map(proc, range(5))
    # 关闭进程池
    pool.close()
    print('========== 结束 ==========')

使用 imap(异步) 执行高并发。调度子进程运行后不会等待,继续执行主进程任务。若主进程运行结束,则子进程不论是否运行完成都将强制结束。
from multiprocessing import Pool

def proc(num):
    print(f'我是子进程')

if __name__ == '__main__':
    # 定义线程池,设置并发数为5
    pool = Pool(5)
    # 使用map向函数传入多个参数(每传入一个参数则会调用一次函数,同时调用的数量由进程数决定)
    pool.imap(proc, range(5))
    # 关闭进程池
    pool.close()
    print('========== 结束 ==========')

这样的好处是不会影响主进程其他任务的执行,如果需要等待则使用 join
from multiprocessing import Pool

def proc(num):
    print(f'我是子进程')

if __name__ == '__main__':
    # 定义线程池,设置并发数为5
    pool = Pool(5)
    # 使用map向函数传入多个参数(每传入一个参数则会调用一次函数,同时调用的数量由进程数决定)
    pool.imap(proc, range(5))
    # 关闭进程池
    pool.close()
    # 等待子进程结束
    pool.join()
    print('========== 结束 ==========')

使用高并发需要注意以下几点:
- 注意控制进程池数量,避免过多的进程导致性能下降。可以通过调用
multiprocessing.cpu_count()获取当前系统的 CPU 数量,并使用该值来指定进程池数量。 - 使用
maxtasksperchild参数来限制每个工作进程可以处理的任务数量。这有助于避免长时间运行的进程引起的资源泄漏或内存泄漏。 - 在提交任务之前,尽可能地减小要处理数据的大小。例如,可以使用迭代器来代替列表,或者使用生成器来延迟计算。
- 对于长时间运行的任务,可以使用消息队列来缓解性能问题。例如,可以使用 RabbitMQ 或 ZeroMQ 等消息队列来异步处理任务。
5. 进程同步
进程同步是指多个进程在共享资源时的协调与同步。单个进程运行时 ,程序的执行是顺序的;多个进程并发执行时可能会造成资源竞争、死锁等问题。因此,进程同步是保证每个进程在使用共享资源时的顺序和正确性。
5.1. 进程加锁的方式
两个进程间实现同步有2种方式,1、手动加锁(释放锁);2、with自动加锁(释放锁)
手动加锁方式
from multiprocessing import Lock

def func():
    # 手动加锁
    Lock().acquire()

    '''执行程序'''
    pass

    # 手动释放锁
    Lock().release()
with 自动加锁(释放锁)
from multiprocessing import Lock

def func():
    # with自动加锁(释放锁)
    with Lock():
        '''执行程序'''
        pass
5.2. 实现进程同步
- 多进程之间同步全局变量的修改,则需要使用共享内存。需要用到 multiprocessing 模块中的 Value 共享变量类型来实现。
实现逻辑

代码如下
from multiprocessing import Process, Lock, Value
from time import sleep

def func1(lock, shared_var):
    for i in range(3):
        with lock:
            shared_var.value -= 1
            print(f'[func1] 共享变量var当前值为:{shared_var.value}')
            sleep(1)

def func2(lock, shared_var):
    for i in range(3):
        with lock:
            shared_var.value += 2
            print(f'[func2] 共享变量var当前值为:{shared_var.value}')
            sleep(1)

if __name__ == '__main__':
    lock = Lock()
    shared_var = Value('i', 10)

    # 定义子进程
    p1 = Process(target=func1, args=(lock, shared_var))
    p2 = Process(target=func2, args=(lock, shared_var))

    # 启动子进程
    p1.start()
    p2.start()

    # 等待子进程结束
    p1.join()
    p2.join()

    print(f'最终共享变量var为:{shared_var.value}')

错误示例(使用了多个 Lock() )
from multiprocessing import Process, Lock, Value
from time import sleep

def func1(shared_var):
    '''定义子进程,让共享变量-1,执行3次'''
    for i in range(3):
        with Lock():    #错误语句
            shared_var.value -= 1
            print(f'[func1] 共享变量var当前值为:{shared_var.value}')
            sleep(1)

def func2(shared_var):
    '''定义子进程,让共享变量+2,执行3次'''
    for i in range(3):
        with Lock():    #错误语句
            shared_var.value += 2
            print(f'[func2] 共享变量var当前值为:{shared_var.value}')
            sleep(1)

if __name__ == '__main__':
    shared_var = Value('i', 10)

    # 定义子进程
    p1 = Process(target=func1, args=(shared_var,))
    p2 = Process(target=func2, args=(shared_var,))

    # 启动子进程
    p1.start()
    p2.start()

    # 等待子进程结束
    p1.join()
    p2.join()

    print(f'最终共享变量var为:{shared_var.value}')
按同步逻辑执行的过程应该是:共享变量 = 10(初始) - 1 + 2 - 1 + 2 - 1 + 2 = 13,但实际的值却是11。下图所示,其中一个步骤出错,并没有加锁。

仔细翻看代码,发现在每个函数中都使用了 Lock() 方法,也就是说2个函数使用的是2个锁,自然不会加锁,出现了脏读现象。
- Lock():用于实现在进程间同步访问共享资源,保证同一时间只有一个进程能够访问。
- RLock():与Lock类似,但支持递归锁,同一个进程中多次获取仍然有效。
- Semaphore():用于控制进程间的并发数量。
- Event():用于实现进程间的事件通知。
- Condition():用于实现复杂的进程间同步,比如等待某个条件变为真时再继续执行。
- Barrier():用于实现多个进程间的协调操作,比如等待所有进程都到达某个状态再继续执行。
总结
以上就是 multiprocessing 模块从基础参数到进程管理、通信、进程池以及同步锁的完整使用方式。实际开发中,根据具体场景选择合适的工具即可——比如简单的并发任务用 Pool,需要细粒度控制就用 Process + Queue,涉及共享变量则别忘了加锁。搞清楚这些,Python多进程编程基本就没什么大问题了。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
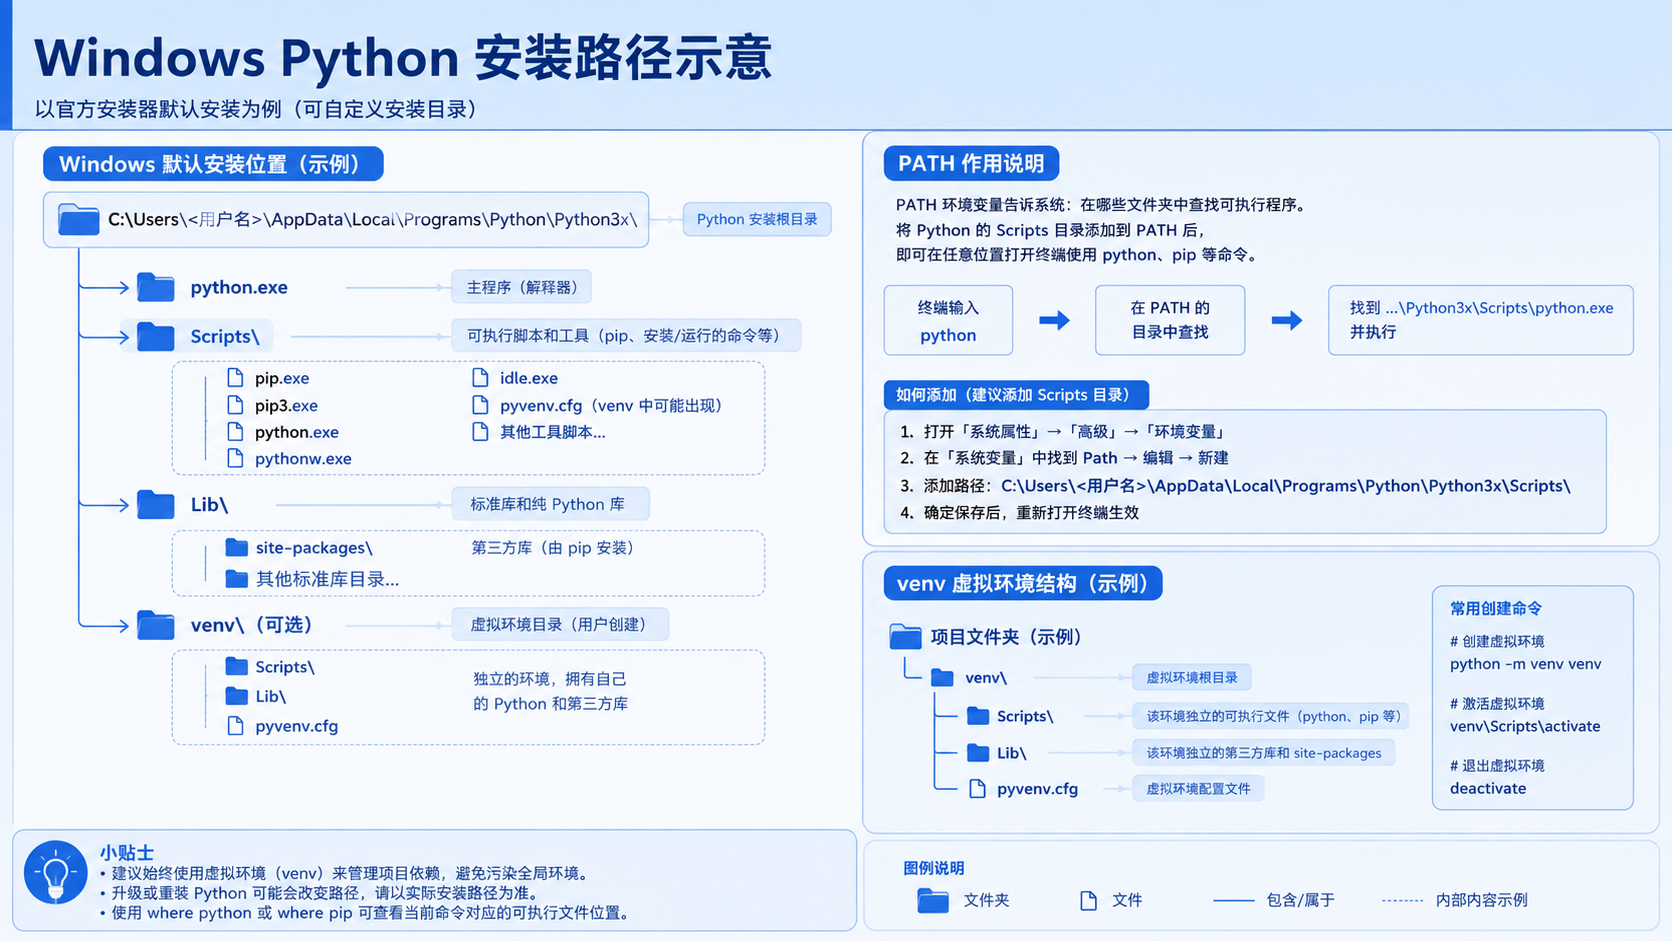
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
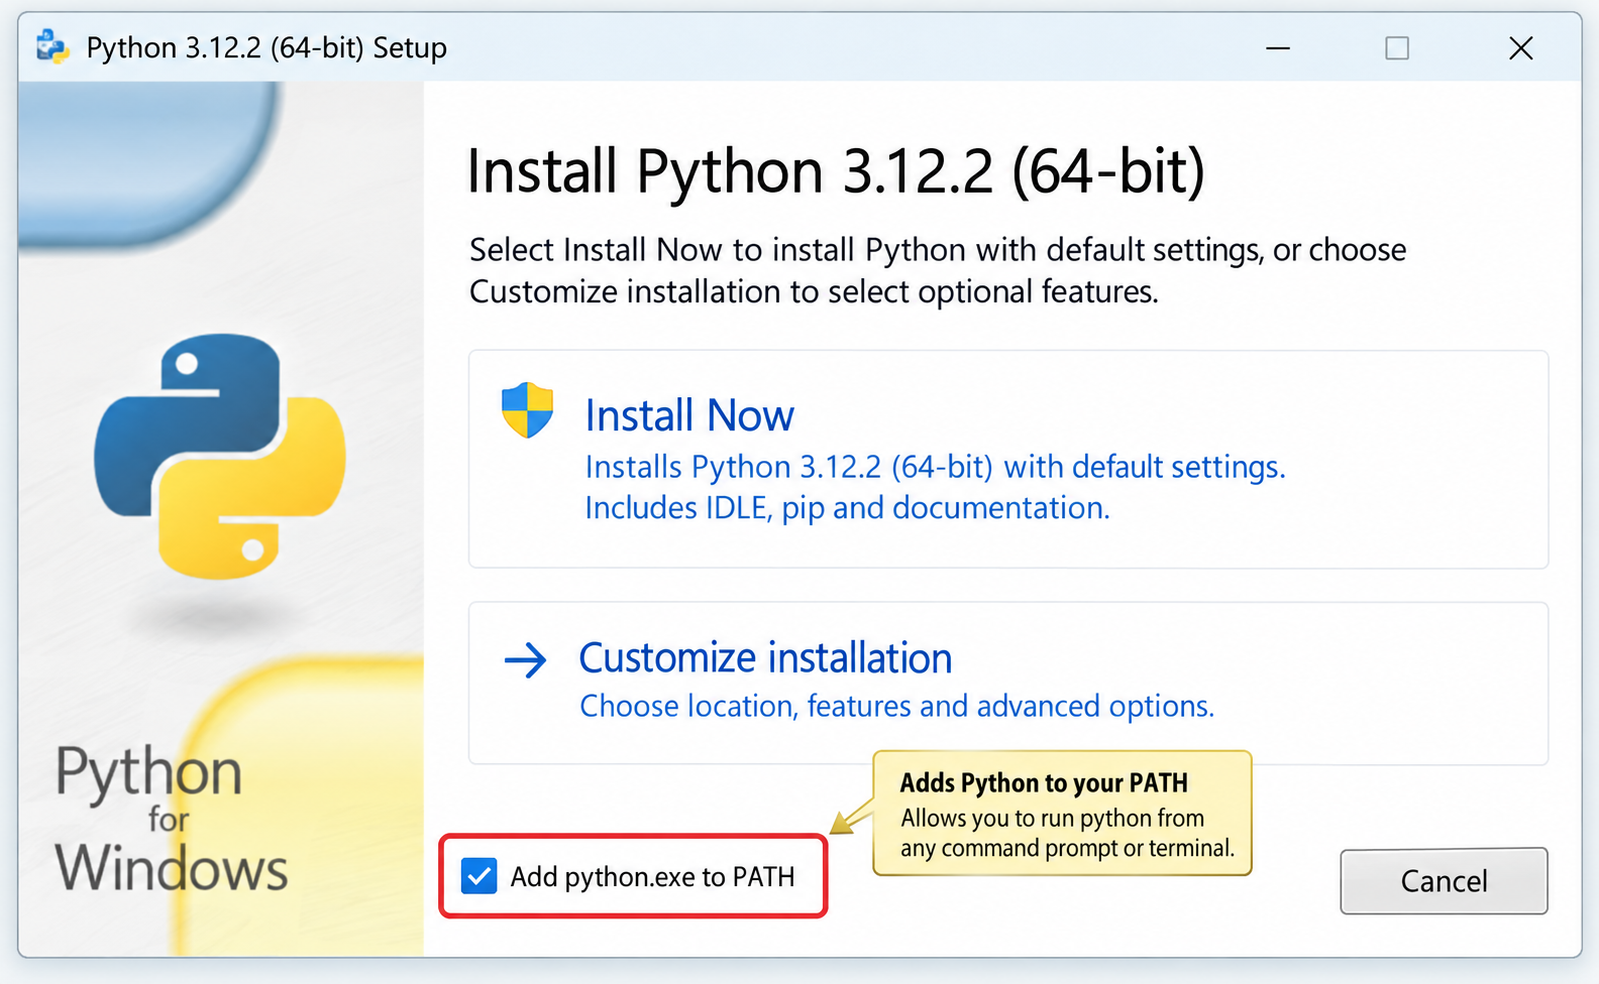
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
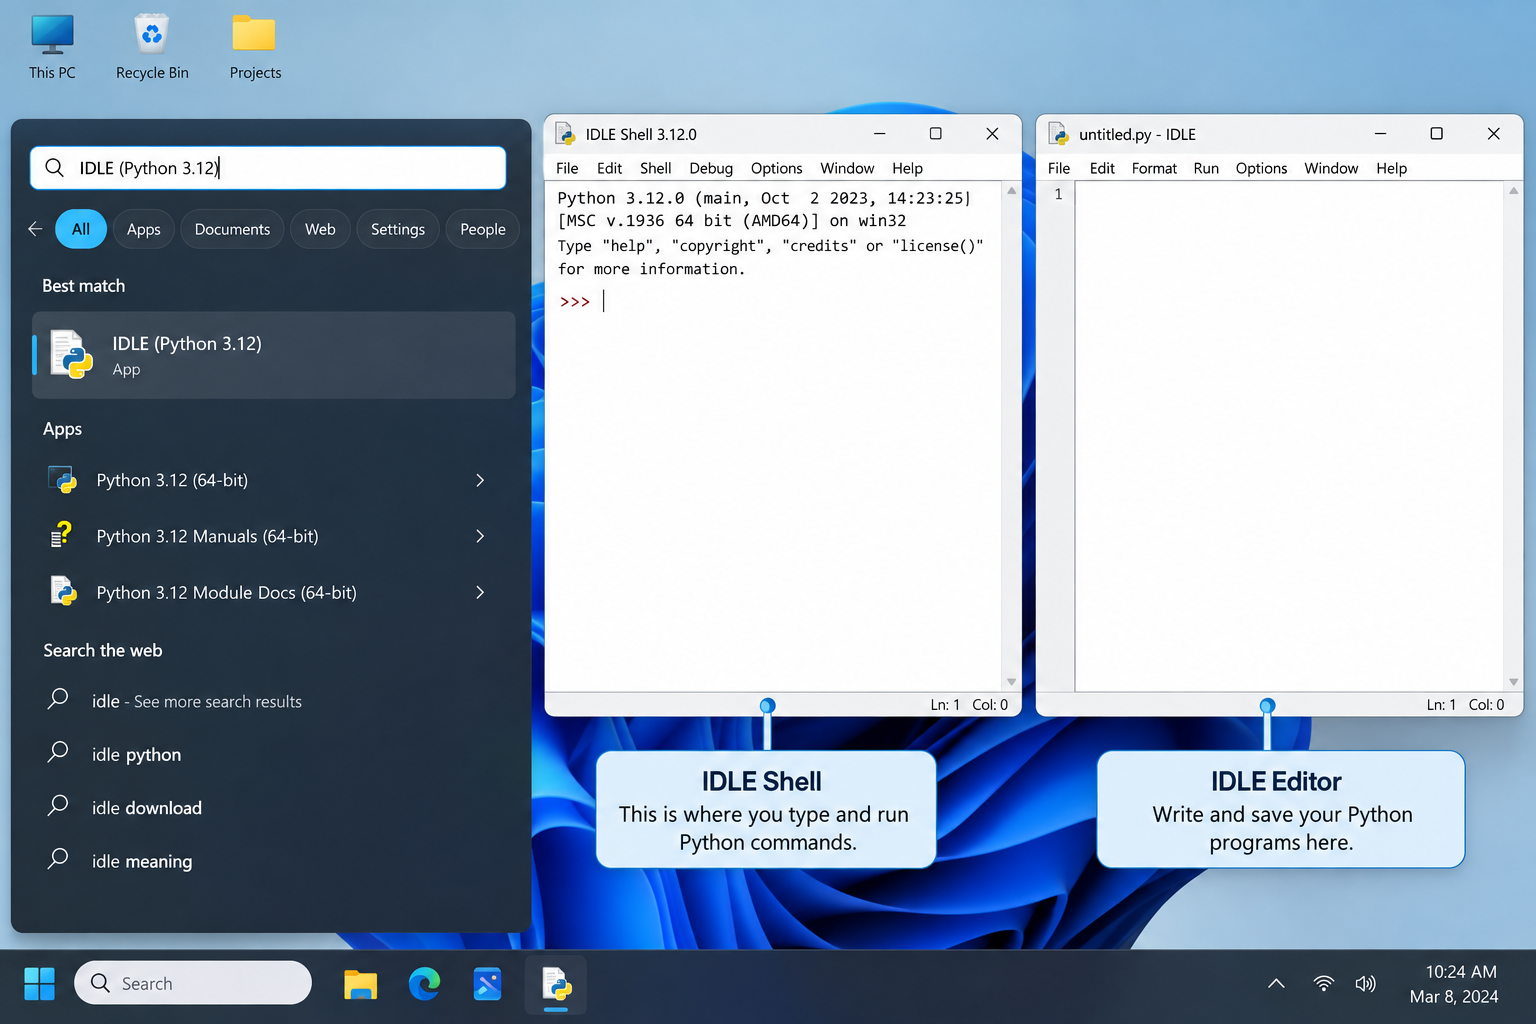
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
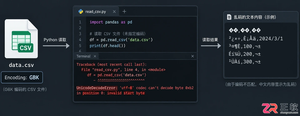
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
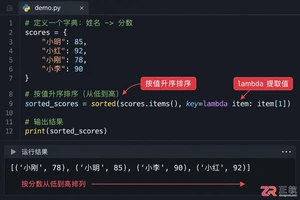
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
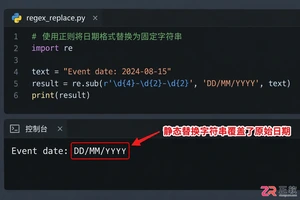
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
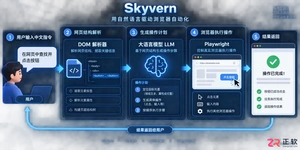
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,