

Python基础指南之break与continue循环控制详解
介绍了Python中break与continue的用法、区别及注意事项。break立即终止整个循环,continue跳过当前迭代。强调break只跳出最近一层循环,while中使用continue需先更新循环变量,避免无限循环。还涉及for-else、嵌套循环跳出策略及模拟do-while等高级用法。
一、开篇:循环不只是“从头到尾”
咱们说说循环控制。很多初学者以为循环就是“把数据从头到尾扫一遍”,其实在实际开发中,经常需要中途跳出(break)或者跳过当前迭代(continue)。这两个关键字看着简单,用好了能让循环逻辑既清晰又高效。
先看一个直观的对比:
# 场景:处理一个数字列表,找到第一个负数就停止
numbers = [3, 7, 2, 9, -1, 5, 8, -3, 6]

# 没有break时 —— 需要额外变量和多一次判断
found = False
for n in numbers:
    if not found:
        if n < 0:
            print(f"第一个负数: {n}")
            found = True
        else:
            print(f"正数: {n}")

# 有了break —— 干净利落
for n in numbers:
    if n < 0:
        print(f"第一个负数: {n}")
        break
    print(f"正数: {n}")
接下来,我们从基础语法到高级技巧,再到常见陷阱和最佳实践,一次把 break 和 continue 聊透。
二、break:立即终止循环
2.1 基本用法
# break 的作用:立即终止当前循环,跳到循环后面的代码

for i in range(10):
    if i == 5:
        print(f"i=={i},终止循环!")
        break
    print(i, end=' ')
# 输出: 0 1 2 3 4 i==5,终止循环!

print(f"n循环结束")

# while中的break
count = 0
while True:
    print(f"第{count+1}次")
    count += 1
    if count >= 5:
        print("够了,停止!")
        break
2.2 break只跳出最近的一层循环
# break 只影响它所在的最内层循环
# 外层循环不受影响

for i in range(3):
    print(f"外层 i={i}")
    for j in range(5):
        if j == 2:
            print(f"  内层 j={j},break!")
            break      # 只跳出内层for
        print(f"  内层 j={j}")
    print(f"外层 i={i} 的内层循环结束")
# 外层继续正常执行!

# 如果想跳出外层循环,需要使用标志变量或异常
print("n=== 跳出双层循环 ===")
found = False
for i in range(3):
    for j in range(5):
        if i == 1 and j == 3:
            print(f"找到目标 ({i}, {j}),跳出所有循环")
            found = True
            break
    if found:
        break  # 跳出外层循环
2.3 break与for-else/while-else
# break 会导致 else 块被跳过
# 这是区分"找到"和"没找到"的经典模式

# 例:搜索元素
def search_item(items, target):
    for i, item in enumerate(items):
        if item == target:
            print(f"✅ 找到 {target} 在位置 {i}")
            break
    else:
        # 循环正常结束(没找到)
        print(f"❌ 没找到 {target}")
        return -1
    return i

items = [1, 3, 5, 7, 9]
search_item(items, 5)   # 找到
search_item(items, 6)   # 没找到
三、continue:跳过当前迭代
3.1 基本用法
# continue 的作用:跳过当前迭代的剩余代码,直接进入下一次迭代

for i in range(10):
    if i % 2 == 0:
        continue    # 跳过偶数
    print(i, end=' ')
# 输出: 1 3 5 7 9

# continue 在 while 循环中的使用
count = 0
while count < 10:
    count += 1
    if count % 3 == 0:
        continue    # 跳过3的倍数
    print(count, end=' ')
# 输出: 1 2 4 5 7 8 10

# ⚠️ 在while中使用continue时,注意循环变量的更新
# 如果把 count += 1 放在 continue 后面,就会造成无限循环!
3.2 continue 作为“过滤器”
# 模式:continue 用于在循环开头过滤不需要处理的情况
# 让"主线逻辑"保持在最低缩进层级

# ❌ 深层嵌套
def process_scores_bad(scores):
    results = []
    for score in scores:
        if score is not None:
            if score >= 0:
                if score <= 100:
                    # 终于到了实际处理
                    if score >= 90:
                        results.append("A")
                    elif score >= 80:
                        results.append("B")
                    # ...
    return results

# ✅ 用 continue 扁平化
def process_scores_good(scores):
    results = []
    for score in scores:
        if score is None:
            results.append("N/A")
            continue
        if score < 0 or score > 100:
            results.append("INVALID")
            continue
        # 到这里score一定是有效的(0-100之间)
        if score >= 90:
            results.append("A")
        elif score >= 80:
            results.append("B")
        elif score >= 70:
            results.append("C")
        elif score >= 60:
            results.append("D")
        else:
            results.append("F")
    return results

scores = [95, None, 85, -5, 72, 105, 60]
print(process_scores_good(scores))
# ['A', 'N/A', 'B', 'INVALID', 'C', 'INVALID', 'D']
3.3 continue的典型应用场景
# 场景1:跳过空值/无效值
data = ["hello", "", "world", None, "python", "", "code"]
valid_data = []
for item in data:
    if not item:      # 跳过空字符串和None
        continue
    valid_data.append(item.upper())
print(valid_data)  # ['HELLO', 'WORLD', 'PYTHON', 'CODE']

# 场景2:跳过已处理的数据
processed_ids = {1, 3, 5}  # 已处理的ID
all_items = [
    {"id": 1, "name": "张三"},
    {"id": 2, "name": "李四"},
    {"id": 3, "name": "王五"},
    {"id": 4, "name": "赵六"},
]
for item in all_items:
    if item["id"] in processed_ids:
        print(f"跳过已处理的 {item['name']}")
        continue
    print(f"处理 {item['name']}...")

# 场景3:跳过不满足条件的记录
orders = [
    {"id": 1, "status": "paid", "amount": 150},
    {"id": 2, "status": "pending", "amount": 200},
    {"id": 3, "status": "cancelled", "amount": 100},
    {"id": 4, "status": "paid", "amount": 50},
]
# 只处理已支付且金额>=100的订单
for order in orders:
    if order["status"] != "paid":
        continue
    if order["amount"] < 100:
        continue
    print(f"处理订单 {order['id']}: ¥{order['amount']}")
四、break与continue的对比
4.1 行为对比
# break: 终止整个循环
# continue: 跳过当前迭代,继续下一次

print("=== break 的效果 ===")
for i in range(10):
    if i == 5:
        break     # 到5就停止
    print(i, end=' ')
print()
# 输出: 0 1 2 3 4

print("n=== continue 的效果 ===")
for i in range(10):
    if i == 5:
        continue  # 跳过5,后面的继续
    print(i, end=' ')
print()
# 输出: 0 1 2 3 4 6 7 8 9

# 可视化对比
"""
break:
    0 → 1 → 2 → 3 → 4 → 5[X] 后面都不执行

continue:
    0 → 1 → 2 → 3 → 4 → 5(跳过) → 6 → 7 → 8 → 9
"""
4.2 while循环中的注意事项
# ⚠️ while中的continue陷阱 —— 变量更新的位置

# ❌ 错误:count += 1在continue之后,造成无限循环
# count = 0
# while count < 10:
#     if count % 3 == 0:
#         continue       # count永远为0,永远执行continue!
#     count += 1

# ✅ 正确:在continue之前更新变量
count = 0
while count < 10:
    count += 1            # 先更新
    if count % 3 == 0:
        continue          # 再判断跳过
    print(count, end=' ')
# 输出: 1 2 4 5 7 8 10

# 或者使用for循环避免这个陷阱
for count in range(1, 11):
    if count % 3 == 0:
        continue
    print(count, end=' ')
五、高级用法与模式
5.1 break 模拟 do-while
# Python没有do-while循环
# 但可以用 while True + break 模拟

# do-while 的语义:先执行一次,再检查条件

# 传统方式(需要写两遍input)
user_input = input("请输入(y/n): ")
while user_input not in ('y', 'n'):
    print("无效输入")
    user_input = input("请输入(y/n): ")

# while True + break 方式(更优雅)
while True:
    user_input = input("请输入(y/n): ")
    if user_input in ('y', 'n'):
        break
    print("无效输入,请重试")
5.2 嵌套循环中的break策略
# 策略1:标志变量
def find_in_matrix_flag(matrix, target):
    found = False
    result = None
    for i, row in enumerate(matrix):
        for j, val in enumerate(row):
            if val == target:
                result = (i, j)
                found = True
                break
        if found:
            break
    return result

# 策略2:封装为函数 + return(推荐!)
def find_in_matrix_return(matrix, target):
    for i, row in enumerate(matrix):
        for j, val in enumerate(row):
            if val == target:
                return (i, j)
    return None

# 策略3:for-else + continue + break 模式
def find_in_matrix_else(matrix, target):
    for i, row in enumerate(matrix):
        for j, val in enumerate(row):
            if val == target:
                break
        else:
            continue  # 内层没找到,继续外层
        break  # 内层找到了,跳出外层
    else:
        return None
    return (i, j)

# 策略2(封装函数+return)最清晰,推荐使用
5.3 continue结合else
# continue不影响for-else的执行
# continue只跳过当前迭代,循环仍然会"正常结束"

for i in range(10):
    if i % 2 == 0:
        continue
    print(i, end=' ')
else:
    print("n循环正常结束!")  # 会执行
# 输出: 1 3 5 7 9 n 循环正常结束!

# 对比:break 会导致 else 不执行
for i in range(10):
    if i == 5:
        break
    print(i, end=' ')
else:
    print("n这行不会执行")  # 不会执行
六、实战案例
6.1 命令行解析器
class CommandParser:
    """简易命令行解析器 —— break和continue的综合应用"""

    def __init__(self):
        self.commands = {}
        self.running = False

    def register(self, name, handler, help_text=""):
        self.commands[name] = {
            "handler": handler,
            "help": help_text,
        }

    def run(self):
        self.running = True
        print("命令解析器启动(输入 help 查看命令,quit 退出)")

        while self.running:
            try:
                raw = input("n> ").strip()
            except (EOFError, KeyboardInterrupt):
                print("n再见!")
                break

            # 跳过空输入
            if not raw:
                continue

            # 解析命令和参数
            parts = raw.split()
            cmd = parts[0].lower()
            args = parts[1:] if len(parts) > 1 else []

            # 内置命令
            if cmd == "quit" or cmd == "exit":
                print("再见!")
                break

            if cmd == "help":
                self._show_help()
                continue

            # 查找并执行命令
            if cmd not in self.commands:
                print(f"未知命令: {cmd}(输入 help 查看可用命令)")
                continue

            try:
                result = self.commands[cmd]["handler"](*args)
                if result:
                    print(result)
            except Exception as e:
                print(f"命令执行出错: {e}")

    def _show_help(self):
        print("可用命令:")
        for name, info in self.commands.items():
            print(f"  {name:<12} - {info['help']}")
        print("  help         - 显示此帮助")
        print("  quit/exit    - 退出")

# 使用
parser = CommandParser()
parser.register("echo", lambda *args: " ".join(args), "回显输入的内容")
parser.register("add", lambda *args: sum(float(a) for a in args), "计算所有参数的和")
parser.register("upper", lambda *args: " ".join(a.upper() for a in args), "转换为大写")
# parser.run()
6.2 数据流处理器
class DataStreamProcessor:
    """数据流处理器 —— break和continue控制处理流程"""

    def __init__(self, max_errors=5, max_items=None):
        self.max_errors = max_errors
        self.max_items = max_items
        self.processed = 0
        self.errors = 0
        self.skipped = 0

    def process(self, items):
        """处理数据流"""
        for item in items:
            # 检查是否达到最大处理数量
            if self.max_items and self.processed >= self.max_items:
                print(f"已达到最大处理数量 {self.max_items},停止")
                break

            # 跳过空数据
            if item is None:
                self.skipped += 1
                continue

            # 跳过无效数据
            if not self._is_valid(item):
                self.skipped += 1
                continue

            # 处理数据
            try:
                result = self._process_item(item)
                self.processed += 1
                yield result
            except Exception as e:
                self.errors += 1
                print(f"处理失败: {e}")

                # 错误过多则停止
                if self.errors >= self.max_errors:
                    print(f"错误次数达到上限 {self.max_errors},停止")
                    break

    def _is_valid(self, item):
        """验证数据有效性"""
        if isinstance(item, dict):
            return bool(item.get("id")) and item.get("value") is not None
        return False

    def _process_item(self, item):
        """处理单个数据项"""
        # 模拟可能失败的处理
        if item.get("value", 0) < 0:
            raise ValueError(f"负值: {item['value']}")
        return {
            "id": item["id"],
            "result": item["value"] * 2,
        }

    def stats(self):
        """返回处理统计"""
        return {
            "processed": self.processed,
            "errors": self.errors,
            "skipped": self.skipped,
        }

# 测试
test_data = [
    {"id": 1, "value": 10},
    None,                      # 空数据 → skip
    {"id": 2, "value": -5},    # 负数 → error
    {"id": None, "value": 3},  # 无id → skip
    {"id": 3, "value": 20},
    {"id": 4, "value": -1},    # 负数 → error
    {"id": 5, "value": 30},
]

processor = DataStreamProcessor(max_errors=2)
results = list(processor.process(test_data))

print(f"n结果: {results}")
print(f"统计: {processor.stats()}")
七、本章小结
到这里,我们就把 break 和 continue 这两个循环控制的关键字彻底讲透了。简单总结一下核心要点:
break:立即终止当前循环。只影响最近的一层循环,会导致 for-else/while-else 中的 else 被跳过。
continue:跳过当前迭代,继续下一次迭代。不影响 for-else/while-else 中的 else 执行。
选型指南:
- 需要停止整个循环 → break
- 需要跳过某些情况但继续 → continue
- 需要跳出多层循环 → 封装函数+return(最推荐)
continue作为过滤器:在循环开头用 continue 过滤掉无效情况,让主线逻辑保持在最低缩进层级,代码可读性大大提升。
while中的continue陷阱:确保在 continue 之前更新循环变量,否则可能无限循环。这个坑新手特别容易踩。
经典模式:while True + break(模拟 do-while)、标志变量(跳出多层循环)、continue 过滤模式。
说白了,break 和 continue 就是循环控制的“方向盘”。掌握好它们,你的循环就不再是只能“从头跑到尾”的死板代码,而是能够灵活应对各种情况的智能控制结构。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
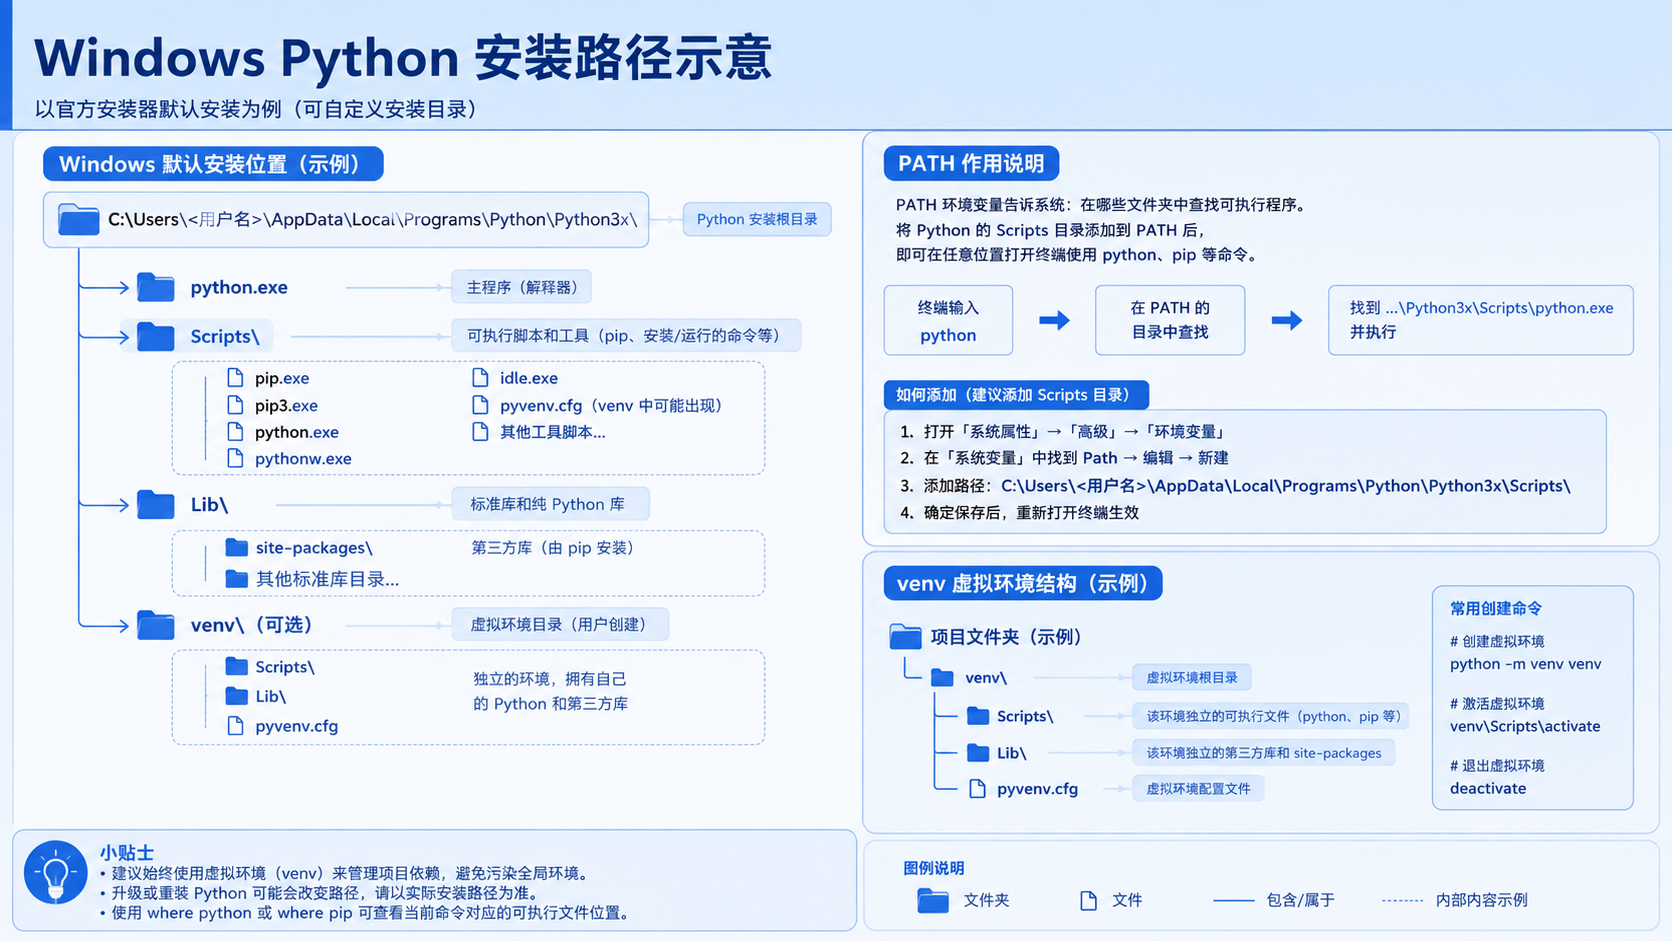
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
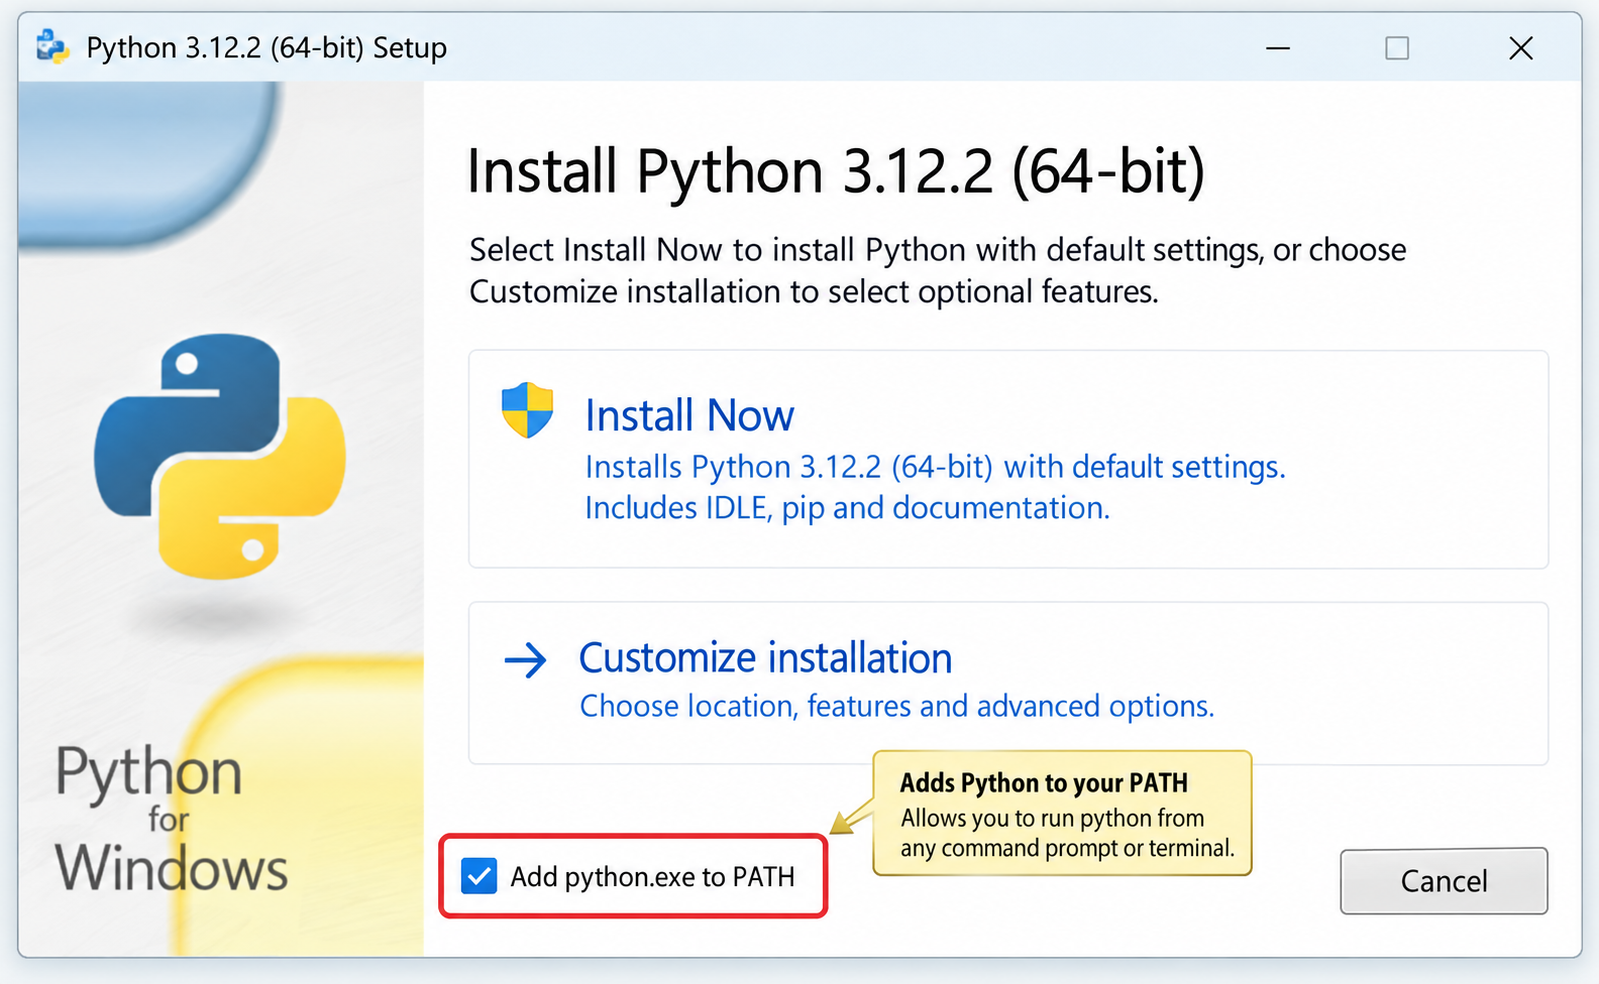
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
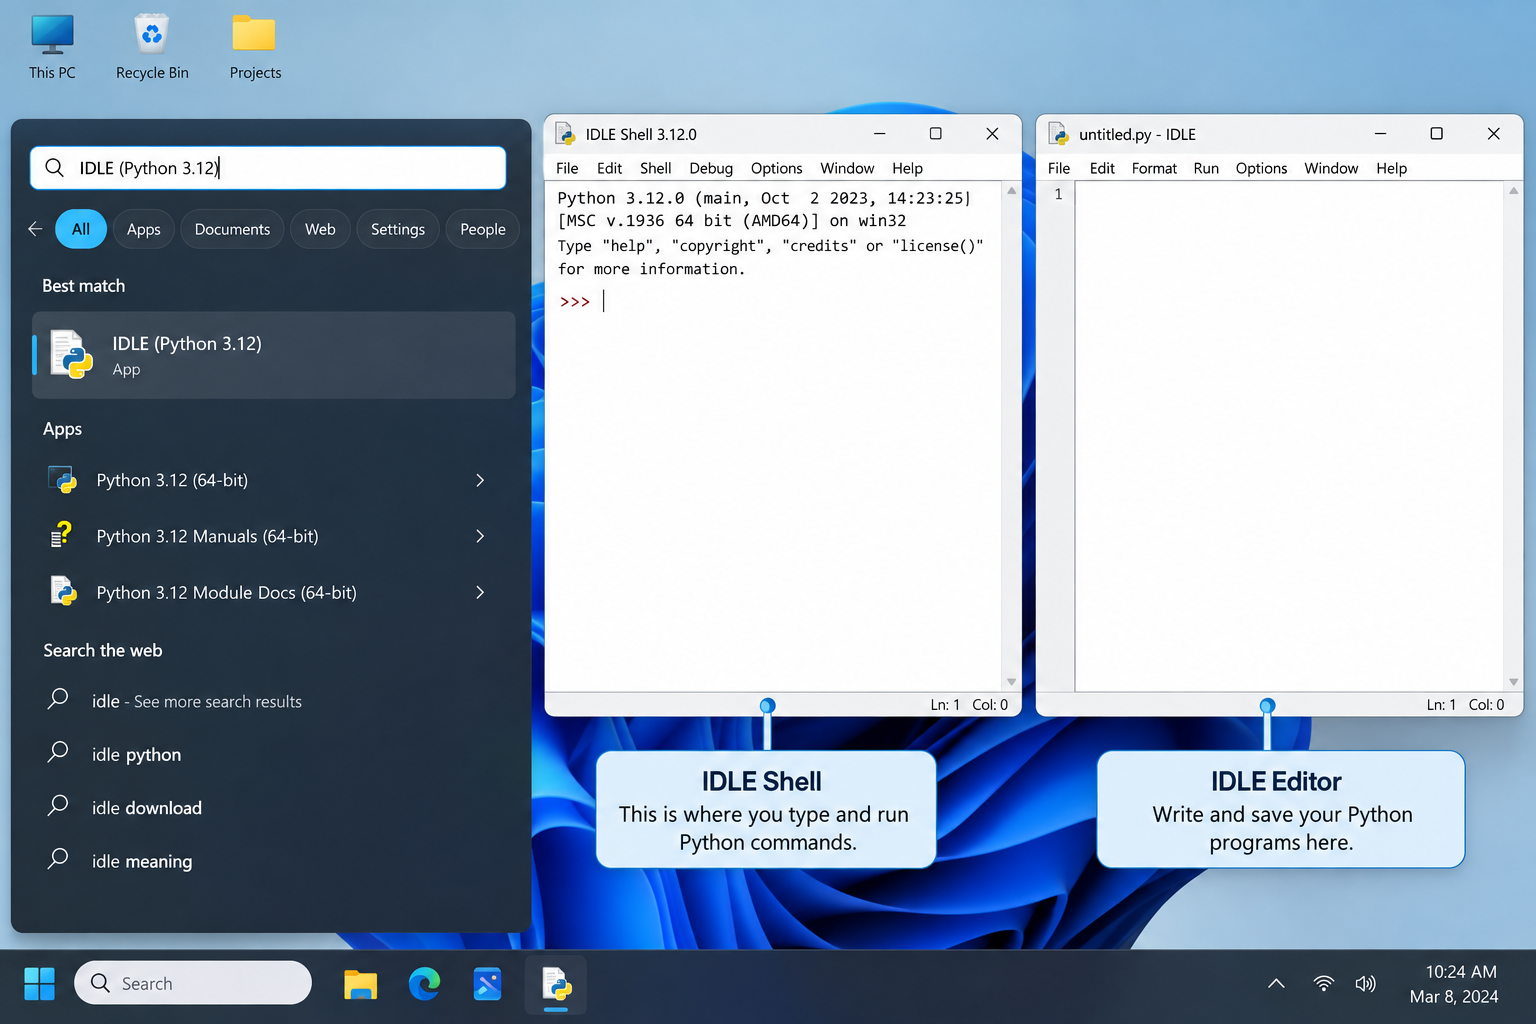
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
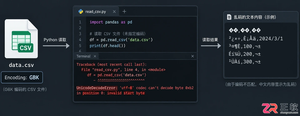
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
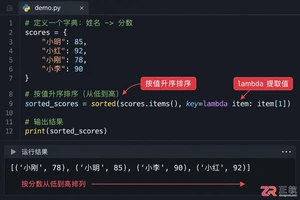
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
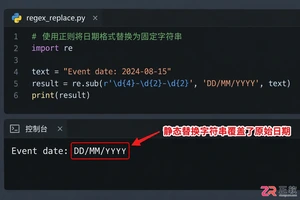
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
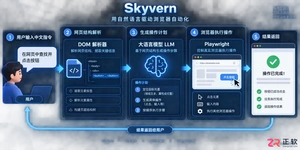
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。