

大模型中常用的注意力机制GQA详解以及Pytorch代码实现
组查询注意力(GroupedQueryAttention)是大型语言模型中的一种多查询注意力力方法,它的目标是在保持MQA速度的同时实现MHA的质量。GroupedQueryAttention将查询分组,每个组内的查询共享相同的注意力权重,这有助于降低计算复杂度和提高推理速度。这篇文章中,我们将解释GQA的思想以及如何将其转化为代码。GQA是在论文GQA:TrainingGeneralizedMulti-QueryTransformerModelsfromMulti-HeadCheckpointspape
组查询注意力(Grouped Query Attention)是大型语言模型中的一种多查询注意力力方法,它的目标是在保持 MQA 速度的同时实现 MHA 的质量。Grouped Query Attention 将查询分组,每个组内的查询共享相同的注意力权重,这有助于降低计算复杂度和提高推理速度。
这篇文章中,我们将解释GQA的思想以及如何将其转化为代码。
GQA是在论文 GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints paper.中提出,这是一个相当简单和干净的想法,并且建立在多头注意力之上。
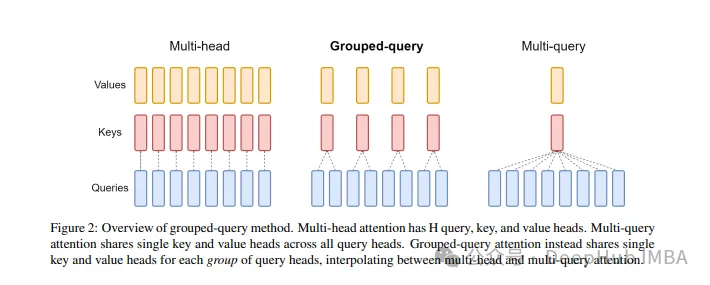
GQA
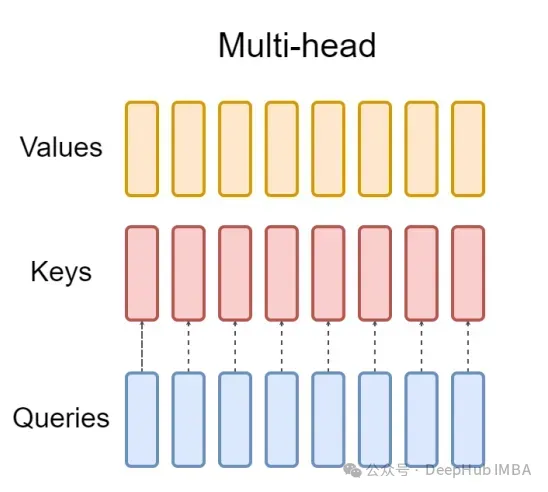
标准多头注意层(MHA)由H个查询头、键头和值头组成。每个头都有D个维度。Pytorch的代码如下:
from torch.nn.functional import scaled_dot_product_attention # shapes: (batch_size, seq_len, num_heads, head_dim) query = torch.randn(1, 256, 8, 64) key = torch.randn(1, 256, 8, 64) value = torch.randn(1, 256, 8, 64) output = scaled_dot_product_attention(query, key, value) print(output.shape) # torch.Size([1, 256, 8, 64])
对于每个查询头,都有一个对应的键。这个过程如下图所示:
而GQA将查询头分成G组,每组共享一个键和值。可以表示为:
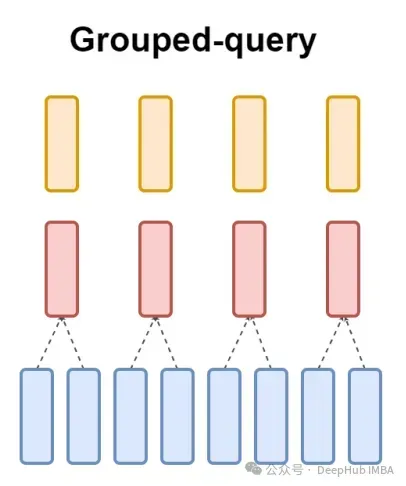
使用可视化的表达就能非常清楚地了解GQA的工作原理,就像我们上面说的那样。GQA是一个相当简单和干净的想法。
Pytorch代码实现
让我们编写代码将这种将查询头划分为G组,每个组共享一个键和值。我们可以使用einops库有效地执行对张量的复杂操作。
首先,定义查询、键和值。然后设置注意力头的数量,数量是随意的,但是要保证num_heads_for_query % num_heads_for_key = 0,也就是说要能够整除。我们的定义如下:
import torch # shapes: (batch_size, seq_len, num_heads, head_dim) query = torch.randn(1, 256, 8, 64) key = torch.randn(1, 256, 2, 64) value = torch.randn(1, 256, 2, 64) num_head_groups = query.shape[2] // key.shape[2] print(num_head_groups) # each group is of size 4 since there are 2 kv_heads
为了提高效率,交换seq_len和num_heads维度,einops可以像下面这样简单地完成:
from einops import rearrange query = rearrange(query, "b n h d -> b h n d") key = rearrange(key, "b s h d -> b h s d") value = rearrange(value, "b s h d -> b h s d")
然后就是需要在查询矩阵中引入”分组“的概念。
from einops import rearrange query = rearrange(query, "b (h g) n d -> b g h n d", g=num_head_groups) print(query.shape) # torch.Size([1, 4, 2, 256, 64])
上面的代码我们将二维重塑为二维:对于我们定义的张量,原始维度8(查询的头数)现在被分成两组(以匹配键和值中的头数),每组大小为4。
最后最难的部分是计算注意力的分数。但其实它可以在一行中通过insum操作完成的
from einops import einsum, rearrange # g stands for the number of groups # h stands for the hidden dim # n and s are equal and stands for sequence length scores = einsum(query, key, "b g h n d, b h s d -> b h n s") print(scores.shape) # torch.Size([1, 2, 256, 256])
scores张量和上面的value张量的形状是一样的。我们看看到底是怎么操作的
einsum帮我们做了两件事:
1、一个查询和键的矩阵乘法。在我们的例子中,这些张量的形状是(1,4,2,256,64)和(1,2,256,64),所以沿着最后两个维度的矩阵乘法得到(1,4,2,256,256)。
2、对第二个维度(维度g)上的元素求和——如果在指定的输出形状中省略了维度,einsum将自动完成这项工作,这样的求和是用来匹配键和值中的头的数量。
最后是注意分数与值的标准乘法:
import torch.nn.functional as F scale = query.size(-1) ** 0.5 attention = F.softmax(similarity / scale, dim=-1) # here we do just a standard matrix multiplication out = einsum(attention, value, "b h n s, b h s d -> b h n d") # finally, just reshape back to the (batch_size, seq_len, num_kv_heads, hidden_dim) out = rearrange(out, "b h n d -> b n h d") print(out.shape) # torch.Size([1, 256, 2, 64])
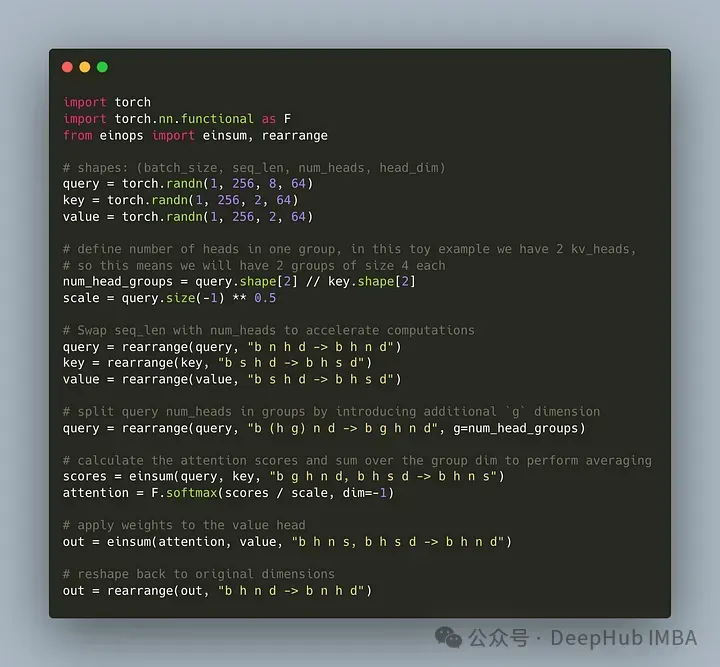
这样最简单的GQA实现就完成了,只需要不到16行python代码:
最后再简单提一句MQA:多查询注意(MQA)是另一种简化MHA的流行方法。所有查询将共享相同的键和值。原理图如下:
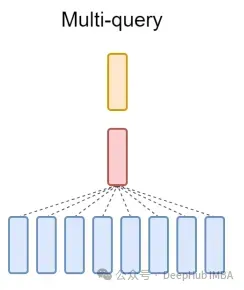
可以看到,MQA和MHA都可以从GQA推导出来。具有单个键和值的GQA相当于MQA,而具有与头数量相等的组的GQA相当于MHA。
GQA的好处是什么?
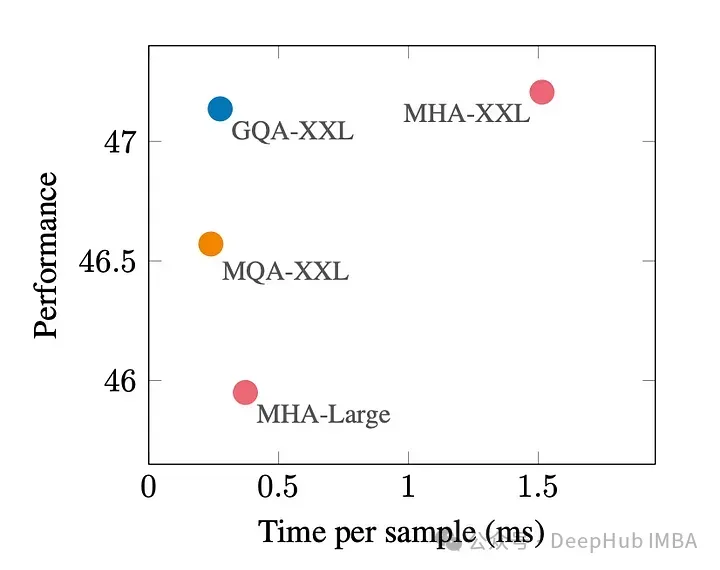
GQA是最佳性能(MQA)和最佳模型质量(MHA)之间的一个很好的权衡。
下图显示,使用GQA,可以获得与MHA几乎相同的模型质量,同时将处理时间提高3倍,达到MQA的性能。这对于高负载系统来说可能是必不可少的。
在pytorch中没有GQA的官方实现。所以我找到了一个比较好的非官方实现,有兴趣的可以试试:
https://github.com/fkodom/grouped-query-attention-pytorch
GQA论文:
使用torch.load加载.pth文件时常见问题包括路径错误、文件损坏、键名不匹配及设备映射不当。需通过os.path.exists检查路径,用map_location指定设备,并清洗键名前缀差异。确保文件完整性和模型结构一致,避免加载失败。
前言昨日,PyTorch官方在GitHub上发布了0.4.0版本,备受期待的Windows支持终于实现!现在,你可以轻松加入深度学习的队伍了!PyTorch官方在GitHub上发布了0.4.0版本,这一版本的最大亮点是正式支持Windows系统。新版本对API进行了彻底的重构,是今年最重要的更新之一。GitHub发布地址:https://github.com/pytorch/pytorch/releasesPyTorch官网:http://pytorch.org/此
大型语言模型(LLM)是在巨大的文本数据库上训练的,在那里它们获得了大量的实际知识。这些知识嵌入到它们的参数中,然后可以在需要时使用。这些模型的知识在训练结束时被“具体化”。在预训练结束时,模型实际上停止学习。对模型进行对齐或进行指令调优,让模型学习如何充分利用这些知识,以及如何更自然地响应用户的问题。但是有时模型知识是不够的,尽管模型可以通过RAG访问外部内容,但通过微调使用模型适应新的领域被认为是有益的。这种微调是使用人工标注者或其他llm创建的输入进行的,模型会遇到额外的实际知识并将其整合到参数中。
大型语言模型(LLM)已成为各种规模企业的游戏规则改变者,但它们对初创企业的影响尤为显著。为了理解其中的原因,让我们来看看初创企业相对于老牌企业有哪些优势,以及为什么AI是它们的重要推动力。首先,与传统企业相比,初创企业有更大的灵活性。它们通常没有过多的层级和繁琐的决策程序,可以更迅速地适应市场变化和顾客需求。这种敏捷性使得初创企业能够更快地推出新产品和服务,并灵活调整战略。其次,初创企业通常更加创初创企业往往面临预算有限、时间紧迫的局面,即便是规模更大的行业参与者也可能争夺的是规模更大的行业参与者可能争

深度学习是人工智能领域的一个重要分支,近年来受到了越来越多人的关注和重视。为了能够进行深度学习的研究和应用,往往需要使用到一些深度学习框架来帮助实现。在本文中,我们将介绍如何使用PHP和PyTorch进行深度学习。一、什么是PyTorchPyTorch是一个由Facebook开发的开源机器学习框架,它可以帮助我们快速地创建深度学习模型并进行训练。PyTorc
从非结构化文本中提取有价值的信息是金融行业的关键应用。然而,这项任务往往超出了简单的数据提取,需要高级推理能力。一个典型的例子是确保信贷协议中的到期日,这通常涉及及时遵守和破译一个复杂的指令,如“到期日应在生效日期三周年之前的最后一个工作日”。这种级别的复杂推理对大型语言模型(LLM)提出了挑战。它需要结合外部知识,如假日日历,以准确地解释和使用给定的指示。集成知识图是一种很有前途的解决方案,具有几个关键优势。Transformer的出现彻底改变了文本矢量化,实现了前所未有的精度。这些嵌入封装了深刻的语义
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/简介生成类似人类的文本和语音曾经只有在科幻小说中才成为可能。但是,GPT-3和PaLM等大型语言模型(LLM)的快速发展使得这一愿景更接近现实,并且相应地出现一系列基于它们的聊天机器人到内容创建等领域颇有前景的商业应用程序。然而,通用的基础模型往往无法满足特定行业场景的具体需求。企业对其生成的人工智能应用程序有不同的要求,涉及到从性能、成本、延迟性乃至可解释性等诸多方面。此外,可用于模型训练的数据
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/提示的力量十分神奇,我们只需抛出几个近似人类语言的单词,就能得到一个格式和结构都良好的答案。没有什么话题是晦涩难懂的,没有什么事实是触不可及的。至少只要它是训练语料库的一部分,并得到模型的影子控制器(ShadowyController)的批准,我们都能通过简单的提示获取到答案。然而,一些人已经开始注意到提示的魔力并非绝对的。我们的提示并非总能产生我们想要的结果。甚至有些提示语言要比其他的更有效。究
阿里的通义千问(Qwen),终于拼齐了1.5系列的最后一块拼图——正式开源Qwen1.5-32B。话不多说,直接来看“成绩单”。这次官方pick同台竞技的“选手”是Mixtral8x7B模型和同为Qwen1.5系列的72B模型。从结果上来看,Qwen1.5-32B已经在多项评测标准中超越或追平Mixtral8x7B:并且即便是在与自家更大参数模型PK过程中,Qwen1.5-32B也用“以小博大”的姿势展现出了较好的性能。用通义千问团队成员的话来说就是:这个模型显示出了与72B模型相当的性能,特别是在语言理
Hello大家好,我是徐小夕。最近在Github上发现了一个非常有意思的框架——js-pytorch。它可以让前端轻松使用javascript来运行深度学习框架。作为一名资深前端技术玩家,今天就和大家分享一下这款框架。在目前人工智能领域中,深度学习技术已经成为了一项备受关注的技术。PyTorch是其中一个备受关注的深度学习框架。这个框架在深度学习领域中具有重要的发展速度。js-pytorch利用JavaScript技术引入了PyTorch的强大功能,使其能够在JavaScript世界中进行使用和开发。Ja





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



