

李彦宏内部讲话谈大模型:闭源才有真正的商业模式
4月11日,关于大模型的李彦宏内部讲话流出。在讲话中,李彦宏对大模型的开源闭源路线之争提出了自己的解答。他说,市场上已经有足够多的开源大模型,“不缺我们这一家开源的模型。我们要开源还得自己去维护一套开源的版本,这是不划算的。”他强调关闭源模型在能力上将持续领先,关闭源才能有真正的商业模式,才能聚集人才和算力,同时在成本上也有优势。此外他还针对AI大模型创业发表了看法。他说,既做模型又做应用的“双轮驱动”不是好的模式,AI创业者的核心竞争力不是模型本身,创业者真正的优势应该是在某一个领域的知识、数据。以下为
4月11日,关于大模型的李彦宏内部讲话流出。在讲话中,李彦宏对大模型的开源闭源路线之争提出了自己的解答。
他说,市场上已经有足够多的开源大模型,“不缺我们这一家开源的模型。我们要开源还得自己去维护一套开源的版本,这是不划算的。”
他强调关闭源模型在能力上将持续领先,关闭源才能有真正的商业模式,才能聚集人才和算力,同时在成本上也有优势。
此外他还针对AI大模型创业发表了看法。他说,既做模型又做应用的“双轮驱动”不是好的模式,AI创业者的核心竞争力不是模型本身,创业者真正的优势应该是在某一个领域的知识、数据。
以下为李彦宏内部讲话实录的部分原文:
一、为什么不开源
已经有足够多的开源大模型
一年前文心刚刚发布的时候,我们内部是有过非常激烈的讨论的,最后当然大家也知道这个结果,我们的决定是不开源。为什么不开源?当时的判断是,市场上一定会有开源的模型,而且是不止一家会开源。在这种情况下,多百度一家开源不多,少百度一家开源也不少。
今天我们看到主流的开源模型:Llama,Mistral其实都是有相当影响力的,国内的智源、百川、阿里的通用也都是开源的,这个市场上不缺我们这一家开源的模型。我们要开源还得自己去维护一套开源的版本,这是不划算的。
闭源模型能力会持续领先
更重要的是,在我们的认知里,闭源模型在能力上会持续地领先,而不是一时地领先。为什么会有这个判断?因为我们觉得模型开源的意义其实不是很大,这些开源模型都是在外头零零散散小规模地去做各种各样的验证应用,它没有经过大算力的验证。
不同模型开源并不是所有人都能理解的情况。这与传统的软件开源一比如Linux、安卓等很不一样,由于是模型带来的开源,我们也不知道参数为什么变成了那样子,这种情况下很难实现所有人拾柴火烧高。虽然Llama也鼓励大家贡献各种各样的数据、代码,但是实际上大家明白最主要的开发者就是Meta这些人,它并不是一个真正由大家一起来协同开发的产品。
闭源才有真正的商业模式,才能聚集人才和算力
反观闭源,是有真正的商业模式的,是能够赚到钱的,能够赚到钱才能聚集算力、聚集人才。其实也很简单,大家比较一下,比如硅谷有一个优秀的人才,他有OpenAI的offer,有Meta的o ffer,有Llama的offer,他会去哪儿?这是非常显而易见的选择。
闭源在成本上也有优势
大家以为开源是免费的,在成本上有优势,实际上我们认为也不是,闭源在成本上反而是有优势的。只要是同等能力,闭源模型的推理成本一定是更低的,响应速度一定是更快的。反过来,同等参数的情况下,闭源模型的能力也是更强的。今天不管是在中国也好、在美国也好,最强的基础模型都是闭源的,而各种各样的小模型、最好的小模型,都是通过大模型蒸馏来的。通过大模型降维做出来的模型就是更好的,这样也会导致闭源在成本上、在效率上也会有优势。
二、创业者为啥可以依赖文心
双轮驱动不是好模式
首先,外界一些做模型的创业公司讲的所谓的“双轮驱动”不是一个好的模式。既做模型又做应用,势必会分散精力。创业公司的精力和资源都是有限的,同时做两件事情和只做一件事情哪个成功率更高是不言自明的。在任何情况下我们都非常讲专注力,“力出一孔”,当资源有限的时候更应该专注,而不是去搞所谓的“双轮驱动”。
AI创业者的核心竞争力不是模型本身
第二,对于AI创业者来说,核心竞争力本就不应该是模型本身,这太耗资源了,而且需要非常长时间的坚持才能跑出来。
创业者真正的优势应该是在某一个领域的知识、数据。假如说你今天想找一个“黄色的无兜的男士泳裤”,你在任何一个今天的电商平台上都找不到,这种需求目前的技术是解决不了的,大模型如果有领域知识就可以解决,这就是靠领域知识能够提供独特价值的例子。
市面上有这么多模型,大的、小的、开源的、闭源的,在特定应用当中怎么样使用这些模型的组合,是有技巧的,这是创业者可以干的事儿,是可以提供价值增益的。
基础模型不会通吃AI应用
外界担心如果用了文心或者闭源模型,做得好了它就抄你,就把你的饭吃掉了,实际上这种担心也是没有任何道理的。
拼多多、滴滴不怕微信抢饭碗
大家去看一看,在移动时代,微信没有去吃掉拼多多,滴滴也没有变成腾讯的一部分,它们都各自提供了自己独特的价值,有自己非常不一样的竞争力,它们的兴起都是依赖移动生态里的一个封闭平台——微信,但是它们并不怕微信去抢它的饭碗,所以没有必要担心基础模型通吃AI的应用。
文心功能最强,性价比最优
当然更根本的就是文心的功能是最强的,性价比是最好的,我们会持续不断地投入,有了这一点,所有其他的东西才能够成立。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
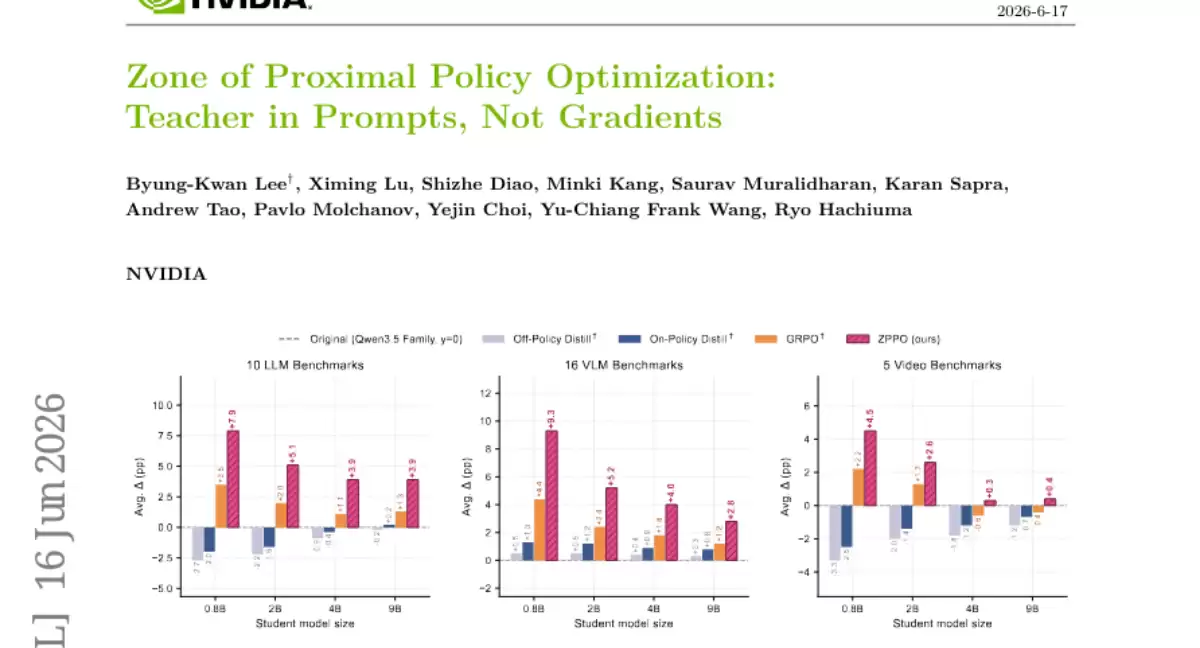
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
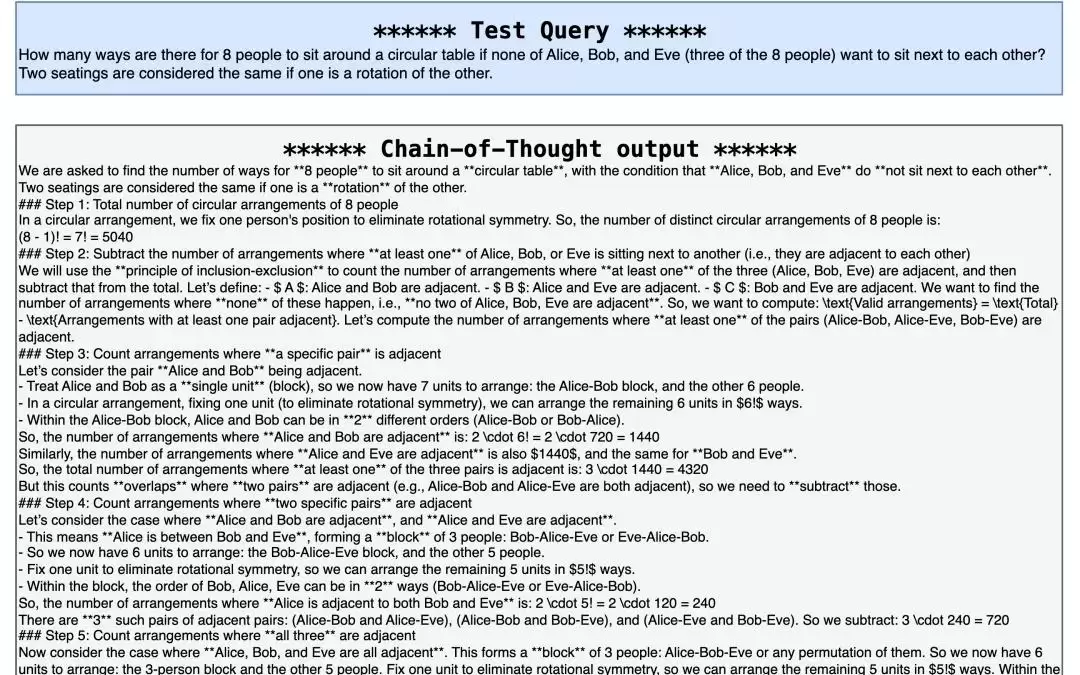
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
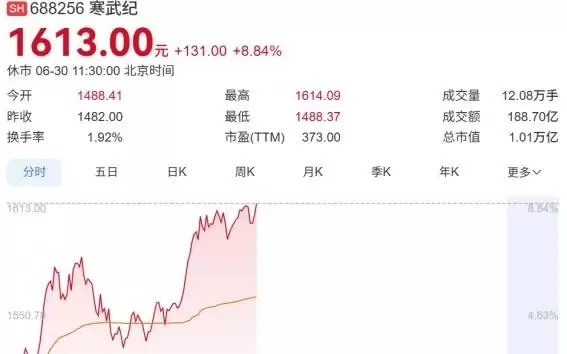
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



