

基于Spring Cache如何实现Caffeine+Redis二级缓存
Redis Assistant 是一款为Redis设计的高效可视化管理与监控工具,提供多种操作模式,高效处理服务器数据。日常使用里的持续防护和信息管理会更突出,适合把安全控制放进长期使用流程中的场景。
具体如下:一、聊聊什么是硬编码使用缓存?在学习SpringCache之前,笔者经常会硬编码的方式使用缓存。我们来举个实际中的例子,为了提升用户信息的查询效率,我们对用户信息使用了缓存,示例代码如下:@AutowireprivateUserMapperuserMapper;@AutowireprivateRedisCacheredisCache;//查询用户publicUsergetUserById(LonguserId){//定义缓存keyStringcacheKey="userId_"+userId;/
具体如下:
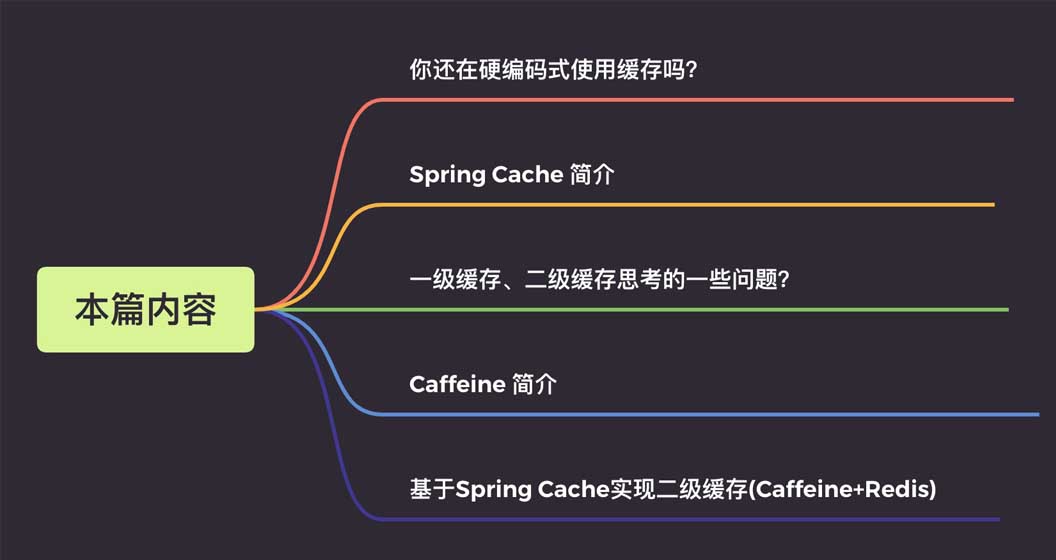
一、聊聊什么是硬编码使用缓存?
在学习Spring Cache之前,笔者经常会硬编码的方式使用缓存。
我们来举个实际中的例子,为了提升用户信息的查询效率,我们对用户信息使用了缓存,示例代码如下:
    @Autowire
    private UserMapper userMapper;

    @Autowire
    private RedisCache redisCache;

    //查询用户
    public User getUserById(Long userId) {
        //定义缓存key
        String cacheKey = "userId_" + userId;
        //先查询redis缓存
        User user = redisCache.get(cacheKey);
        //如果缓存中有就直接返回,不再查询数据库
        if (user != null) {
            return user;
        }
        //没有再查询数据库
        user = userMapper.getUserById(userId);

        //数据存入缓存,这样下次查询就能到缓存中获取
        if (user != null) {
            stringCommand.set(cacheKey, user);
        }

        return user;
    }
相信很多同学都写过类似风格的代码,这种风格符合面向过程的编程思维,非常容易理解。但它也有一些缺点:
代码不够优雅。业务逻辑有四个典型动作:存储,读取,修改,删除。每次操作都需要定义缓存Key ,调用缓存命令的API,产生较多的重复代码;
缓存操作和业务逻辑之间的代码耦合度高,对业务逻辑有较强的侵入性。侵入性主要体现如下两点:
开发联调阶段,需要去掉缓存,只能注释或者临时删除缓存操作代码,也容易出错;
某些场景下,需要更换缓存组件,每个缓存组件有自己的API,更换成本颇高。
如果说是下面这样的,是不是就优雅多了。
@Mapper
public interface UserMapper  {

    /**
     * 根据用户id获取用户信息
     *
     * 如果缓存中有直接返回缓存数据,如果没有那么就去数据库查询,查询完再插入缓存中,这里缓存的key前缀为cache_user_id_,+传入的用户ID
     */
    @Cacheable(key = "'cache_user_id_' + #userId")
    User getUserById(Long userId);
}
再看实现类
    @Autowire
    private UserMapper userMapper;

    //查询用户
    public User getUserById(Long userId) {
        return userMapper.getUserById(userId);
    }
这么一看是不是完全和缓存分离开来,如果开发联调阶段,需要去掉缓存那么直接注释掉注解就好了,是不是非常完美。
而且这一整套实现都不要自己手动写,Spring Cache就已经帮我定义好相关注解和接口,我们可以轻易实现上面的功能。
二、Spring Cache简介
Spring Cache是Spring-context包中提供的基于注解方式使用的缓存组件,定义了一些标准接口,通过实现这些接口,就可以通过在
方法上增加注解来实现缓存。这样就能够避免缓存代码与业务处理耦合在一起的问题。
Spring Cache核心的接口就两个:Cache和CacheManager
1、Cache接口
该接口定义提供缓存的具体操作,比如缓存的放入、读取、清理:
package org.Springframework.cache;
import java.util.concurrent.Callable;

public interface Cache {

	// cacheName,缓存的名字,默认实现中一般是CacheManager创建Cache的bean时传入cacheName
	String getName();

	//得到底层使用的缓存,如Ehcache
	Object getNativeCache();

	// 通过key获取缓存值,注意返回的是ValueWrapper,为了兼容存储空值的情况,将返回值包装了一层,通过get方法获取实际值
	ValueWrapper get(Object key);

	// 通过key获取缓存值,返回的是实际值,即方法的返回值类型
	 T get(Object key, Class type);

	// 通过key获取缓存值,可以使用valueLoader.call()来调使用@Cacheable注解的方法。当@Cacheable注解的sync属性配置为true时使用此方法。
	// 因此方法内需要保证回源到数据库的同步性。避免在缓存失效时大量请求回源到数据库
	 T get(Object key, Callable valueLoader);

	// 将@Cacheable注解方法返回的数据放入缓存中
	void put(Object key, Object value);

	// 当缓存中不存在key时才放入缓存。返回值是当key存在时原有的数据
	ValueWrapper putIfAbsent(Object key, Object value);

	// 删除缓存
	void evict(Object key);

	// 清空缓存
	void clear();

	// 缓存返回值的包装
	interface ValueWrapper {

	// 返回实际缓存的对象
		Object get();
	}
}
2、CacheManager接口
主要提供Cache实现bean的创建,每个应用里可以通过cacheName来对Cache进行隔离,每个cacheName对应一个Cache实现。
package org.Springframework.cache;
import java.util.Collection;

public interface CacheManager {

	// 通过cacheName创建Cache的实现bean,具体实现中需要存储已创建的Cache实现bean,避免重复创建,也避免内存缓存
        //对象(如Caffeine)重新创建后原来缓存内容丢失的情况
	Cache getCache(String name);

	// 返回所有的cacheName
	Collection getCacheNames();
}
3、常用注解说明
@Cacheable:主要应用到查询数据的方法上。
public @interface Cacheable {

    // cacheNames,CacheManager就是通过这个名称创建对应的Cache实现bean
	@AliasFor("cacheNames")
	String[] value() default {};

	@AliasFor("value")
	String[] cacheNames() default {};

    // 缓存的key,支持SpEL表达式。默认是使用所有参数及其计算的hashCode包装后的对象(SimpleKey)
	String key() default "";

	// 缓存key生成器,默认实现是SimpleKeyGenerator
	String keyGenerator() default "";

	// 指定使用哪个CacheManager,如果只有一个可以不用指定
	String cacheManager() default "";

	// 缓存解析器
	String cacheResolver() default "";

	// 缓存的条件,支持SpEL表达式,当达到满足的条件时才缓存数据。在调用方法前后都会判断
	String condition() default "";

    // 满足条件时不更新缓存,支持SpEL表达式,只在调用方法后判断
	String unless() default "";

	// 回源到实际方法获取数据时,是否要保持同步,如果为false,调用的是Cache.get(key)方法;如果为true,调用的是Cache.get(key, Callable)方法
	boolean sync() default false;

}@CacheEvict:清除缓存,主要应用到删除数据的方法上。相比Cacheable多了两个属性
public @interface CacheEvict {

  // ...相同属性说明请参考@Cacheable中的说明
	// 是否要清除所有缓存的数据,为false时调用的是Cache.evict(key)方法;为true时调用的是Cache.clear()方法
	boolean allEntries() default false;

	// 调用方法之前或之后清除缓存
	boolean beforeInvocation() default false;
}@CachePut:放入缓存,主要用到对数据有更新的方法上。属性说明参考@Cacheable
@Caching:用于在一个方法上配置多种注解
@EnableCaching:启用Spring cache缓存,作为总的开关,在SpringBoot的启动类或配置类上需要加上此注解才会生效
三、使用二级缓存需要思考的一些问题?
我们知道关系数据库(Mysql)数据最终存储在磁盘上,如果每次都从数据库里去读取,会因为磁盘本身的IO影响读取速度,所以就有了
像redis这种的内存缓存。
通过内存缓存确实能够很大程度的提高查询速度,但如果同一查询并发量非常的大,频繁的查询redis,也会有明显的网络IO上的消耗,
那我们针对这种查询非常频繁的数据(热点key),我们是不是可以考虑存到应用内缓存,如:caffeine。
当应用内缓存有符合条件的数据时,就可以直接使用,而不用通过网络到redis中去获取,这样就形成了两级缓存。
应用内缓存叫做一级缓存,远程缓存(如redis)叫做二级缓存。
整个流程如下
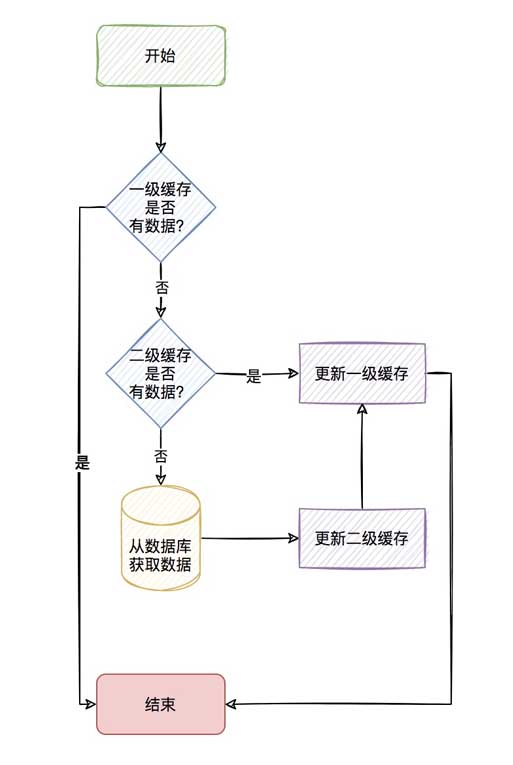
流程看着是很清新,但其实二级缓存需要考虑的点还很多。
1.如何保证分布式节点一级缓存的一致性?
我们说一级缓存是应用内缓存,那么当你的项目部署在多个节点的时候,如何保证当你对某个key进行修改删除操作时,使其它节点
的一级缓存一致呢?
2.是否允许存储空值?
这个确实是需要考虑的点。因为如果某个查询缓存和数据库中都没有,那么就会导致频繁查询数据库,导致数据库Down,这也是我们
常说的缓存穿透。
但如果存储空值呢,因为可能会存储大量的空值,导致缓存变大,所以这个最好是可配置,按照业务来决定是否开启。
3.是否需要缓存预热?
也就是说,我们会觉得某些key一开始就会非常的热,也就是热点数据,那么我们是否可以一开始就先存储到缓存中,避免缓存击穿。
4.一级缓存存储数量上限的考虑?
既然一级缓存是应用内缓存,那你是否考虑一级缓存存储的数据给个限定最大值,避免存储太多的一级缓存导致OOM。
5.一级缓存过期策略的考虑?
我们说redis作为二级缓存,redis是淘汰策略来管理的。具体可参考redis的8种淘汰策略。那你的一级缓存策略呢?就好比你设置一级缓存
数量最大为5000个,那当第5001个进来的时候,你是怎么处理呢?是直接不保存,还是说自定义LRU或者LFU算法去淘汰之前的数据?
6.一级缓存过期了如何清除?
我们说redis作为二级缓存,我们有它的缓存过期策略(定时、定期、惰性),那你的一级缓存呢,过期如何清除呢?
这里4、5、6小点如果说用我们传统的Map显然实现是很费劲的,但现在有更好用的一级缓存库那就是Caffeine。
四、Caffeine 简介
Caffeine,一个用于Java的高性能缓存库。
缓存和Map之间的一个根本区别是缓存会清理存储的项目。
1、写入缓存策略
Caffeine有三种缓存写入策略:手动、同步加载和异步加载。
2、缓存值的清理策略
Caffeine有三种缓存值的清理策略:基于大小、基于时间和基于引用。
基于容量:当缓存大小超过配置的大小限制时会发生回收。
基于时间:
写入后到期策略。
访问后过期策略。
到期时间由 Expiry 实现独自计算。
基于引用:启用基于缓存键值的垃圾回收。
Java种有四种引用:强引用,软引用,弱引用和虚引用,caffeine可以将值封装成弱引用或软引用。
软引用:如果一个对象只具有软引用,则内存空间足够,垃圾回收器就不会回收它;如果内存空间不足了,就会回收这些对象的内存。
弱引用:在垃圾回收器线程扫描它所管辖的内存区域的过程中,一旦发现了只具有弱引用的对象,不管当前内存空间足够与否,都会
回收它的内存。
3、统计
Caffeine提供了一种记录缓存使用统计信息的方法,可以实时监控缓存当前的状态,以评估缓存的健康程度以及缓存命中率等,方便后
续调整参数。
4、高效的缓存淘汰算法
缓存淘汰算法的作用是在有限的资源内,尽可能识别出哪些数据在短时间会被重复利用,从而提高缓存的命中率。常用的缓存淘汰算法有
LRU、LFU、FIFO等。
FIFO:先进先出。选择最先进入的数据优先淘汰。
LRU:最近最少使用。选择最近最少使用的数据优先淘汰。
LFU:最不经常使用。选择在一段时间内被使用次数最少的数据优先淘汰。
LRU(Least Recently Used)算法认为最近访问过的数据将来被访问的几率也更高。
LRU通常使用链表来实现,如果数据添加或者被访问到则把数据移动到链表的头部,链表的头部为热数据,链表的尾部如冷数据,当
数据满时,淘汰尾部的数据。
LFU(Least Frequently Used)算法根据数据的历史访问频率来淘汰数据,其核心思想是“如果数据过去被访问多次,那么将来被访问
的频率也更高”。根据LFU的思想,如果想要实现这个算法,需要额外的一套存储用来存每个元素的访问次数,会造成内存资源的浪费。
Caffeine采用了一种结合LRU、LFU优点的算法:W-TinyLFU,其特点:高命中率、低内存占用。
5、其他说明
Caffeine的底层数据存储采用ConcurrentHashMap。因为Caffeine面向JDK8,在jdk8中ConcurrentHashMap增加了红黑树,在hash冲突
严重时也能有良好的读性能。
五、基于Spring Cache实现二级缓存(Caffeine+Redis)
前面说了,使用了redis缓存,也会存在一定程度的网络传输上的消耗,所以会考虑应用内缓存,但有点很重要的要记住:
应用内缓存可以理解成比redis缓存更珍惜的资源,所以,caffeine 不适用于数据量大,并且缓存命中率极低的业务场景,如用户维度的缓存。
当前项目针对应用都部署了多个节点,一级缓存是在应用内的缓存,所以当对数据更新和清除时,需要通知所有节点进行清理缓存的操作。
可以有多种方式来实现这种效果,比如:zookeeper、MQ等,但是既然用了redis缓存,redis本身是有支持订阅/发布功能的,所以就
不依赖其他组件了,直接使用redis的通道来通知其他节点进行清理缓存的操作。
当某个key进行更新删除操作时,通过发布订阅的方式通知其它节点进行删除该key本地的一级缓存就可以了。
具体具体项目代码这里就不再粘贴出来了,这样只粘贴如何引用这个starter包。
1、maven引入使用
            com.jincou
            redis-caffeine-cache-starter
            1.0.0
2、application.yml
添加二级缓存相关配置
# 二级缓存配置
# 注:caffeine 不适用于数据量大,并且缓存命中率极低的业务场景,如用户维度的缓存。请慎重选择。
l2cache:
  config:
    # 是否存储空值,默认true,防止缓存穿透
    allowNullValues: true
    # 组合缓存配置
    composite:
      # 是否全部启用一级缓存,默认false
      l1AllOpen: false
      # 是否手动启用一级缓存,默认false
      l1Manual: true
      # 手动配置走一级缓存的缓存key集合,针对单个key维度
      l1ManualKeySet:
      - userCache:user01
      - userCache:user02
      - userCache:user03
      # 手动配置走一级缓存的缓存名字集合,针对cacheName维度
      l1ManualCacheNameSet:
      - userCache
      - goodsCache
    # 一级缓存
    caffeine:
      # 是否自动刷新过期缓存 true 是 false 否
      autoRefreshExpireCache: false
      # 缓存刷新调度线程池的大小
      refreshPoolSize: 2
      # 缓存刷新的频率(秒)
      refreshPeriod: 10
      # 写入后过期时间(秒)
      expireAfterWrite: 180
      # 访问后过期时间(秒)
      expireAfterAccess: 180
      # 初始化大小
      initialCapacity: 1000
      # 最大缓存对象个数,超过此数量时之前放入的缓存将失效
      maximumSize: 3000

    # 二级缓存
    redis:
      # 全局过期时间,单位毫秒,默认不过期
      defaultExpiration: 300000
      # 每个cacheName的过期时间,单位毫秒,优先级比defaultExpiration高
      expires: {userCache: 300000,goodsCache: 50000}
      # 缓存更新时通知其他节点的topic名称 默认 cache:redis:caffeine:topic
      topic: cache:redis:caffeine:topic
3、启动类上增加@EnableCaching
/**
 *  启动类
 */
@EnableCaching
@SpringBootApplication
public class CacheApplication {

	public static void main(String[] args) {
		SpringApplication.run(CacheApplication.class, args);
	}

}
4、在需要缓存的方法上增加@Cacheable注解
/**
 *  测试
 */
@Service
public class CaffeineCacheService {

    private final Logger logger = LoggerFactory.getLogger(CaffeineCacheService.class);

    /**
     * 用于模拟db
     */
    private static Map userMap = new HashMap<>();

    {
        userMap.put("user01", new UserDTO("1", "张三"));
        userMap.put("user02", new UserDTO("2", "李四"));
        userMap.put("user03", new UserDTO("3", "王五"));
        userMap.put("user04", new UserDTO("4", "赵六"));
    }

    /**
     * 获取或加载缓存项
     */
    @Cacheable(key = "'cache_user_id_' + #userId", value = "userCache")
    public UserDTO queryUser(String userId) {
        UserDTO userDTO = userMap.get(userId);
        try {
            Thread.sleep(1000);// 模拟加载数据的耗时
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        logger.info("加载数据:{}", userDTO);
        return userDTO;
    }


    /**
     * 获取或加载缓存项
     *
     * 注:因底层是基于caffeine来实现一级缓存,所以利用的caffeine本身的同步机制来实现
     * sync=true 则表示并发场景下同步加载缓存项,
     * sync=true,是通过get(Object key, Callable valueLoader)来获取或加载缓存项,此时valueLoader(加载缓存项的具体逻辑)会被缓存起来,所以CaffeineCache在定时刷新过期缓存时,缓存项过期则会重新加载。
     * sync=false,是通过get(Object key)来获取缓存项,由于没有valueLoader(加载缓存项的具体逻辑),所以CaffeineCache在定时刷新过期缓存时,缓存项过期则会被淘汰。
     *
     */
    @Cacheable(value = "userCache", key = "#userId", sync = true)
    public List queryUserSyncList(String userId) {
        UserDTO userDTO = userMap.get(userId);
        List list = new ArrayList();
        list.add(userDTO);
        logger.info("加载数据:{}", list);
        return list;
    }

    /**
     * 更新缓存
     */
    @CachePut(value = "userCache", key = "#userId")
    public UserDTO putUser(String userId, UserDTO userDTO) {
        return userDTO;
    }

    /**
     * 淘汰缓存
     */
    @CacheEvict(value = "userCache", key = "#userId")
    public String evictUserSync(String userId) {
        return userId;
    }
}
Spring与Hibernate是Java企业开发的核心框架。Spring通过依赖注入管理对象生命周期,简化开发;Hibernate作为ORM工具,实现对象与数据库映射,避免繁琐SQL。两者结合能构建结构清晰、易于维护的应用。教程涵盖环境搭建、实体映射、数据操作及事务管理等实践内容,帮助新手快速掌握整合开发。
在 Spring Boot 里注册 Servlet,其实有不止一种做法,而且每种方式适合的场景也不太一样:有的更偏配置化,有的更适合注解扫描,还有的更强调运行时动态注册。下面把常见的五种方式完整梳理一遍,方便直接对照使用。 一、Spring Boot 提供了 ServletRegistrationB
一、问题背景 在 Spring Boot 项目里,配置文件用占位符引用环境变量可以说是家常便饭了,比如下面这种写法: url: jdbc:mysql://${datasource_addr:10.xxx.xxx.xxx:5236}/mydb 但有一个现象挺让人头疼的:同样的配置,在 IDEA 里跑得
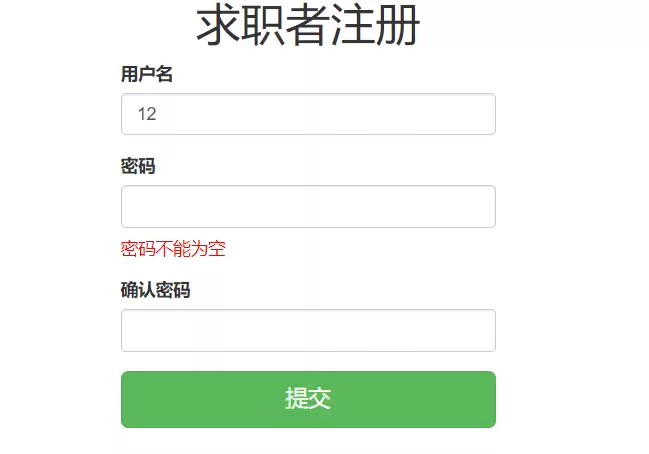
采用AJAX与SpringMVC的异步验证,通过XMLHttpRequest对象实现局部数据交换,利用@ResponseBody返回JSON或字符串,结合@RequestBody解析请求体,完成表单无刷新校验,包括用户名重复检测与密码一致性验证。该方法提升交互效率,减少带宽占用,有效确保数据准确性,提升用户体验。
在Docker环境下为PHP安装Redis扩展:手动编译需下载源码、安装phpize、配置编译并安装,生成redis.so并在php.d目录新建redis.ini加载,重启PHP-FPM;也可直接yum安装php72w-pecl-redis,免手动编译。
配置PHP的Redis扩展:先安装Redis服务,从GitHub下载phpredis源码,用phpize编译安装,修改php.ini添加extension=redis.so,重启php-fpm或Apache,通过phpinfo验证并连接Redis。
C++结构体无法直接序列化为RESP协议,需手动将字段映射为*N数组嵌套$lenbulkstring形式。整数需转换为字符串并加:前缀,空字符串用$0\r\n,null用$-1\r\n。长度计算需精确到字节数,特别注意二进制安全,同时确保字段顺序与结构体定义一致。
SpringSecurity2026是一款强大的安全框架,提供多因素认证、OAuth2.0与OpenIDConnect协议支持以及强密码管理功能;支持基于角色、权限和表达式的细粒度授权控制;同时涵盖跨站请求伪造与跨站脚本攻击等安全防护最佳实践,助力企业级应用安全构建。
Redis作为跨服务临时状态枢纽,需按消息队列、缓存和原子状态三重角色设计。选型用List实现任务分发及延迟重试,Stream用于事件广播与位点回溯。go-redis/v8需配置MinIdleConns、MaxRetries及超时。数据写入应JSON序列化并带type标签、设合理TTL、将关键字段提至顶层。消费通过原子GET+DEL或processedkey
在高并发秒杀场景下,利用Redis的减库存原子操作预扣减库存拦截超卖请求,再通过数据库乐观锁(版本号与库存校验)确保最终一致性,异常时回滚Redis库存并借助Lua脚本保证原子性,从而有效防止库存超卖。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



