

基于分层自监督学习将视觉Transformer扩展到千兆像素图像
Vision+Transformers(ViT)是一种多尺度和分层变换已成功地捕获图像表示,但它们的使用通常被研究用于低分辨率图像(例如256×256、384×384)。1概括在计算病理学中的千元素全玻片成像(WSI)中,WSI存在20倍放大率下可以大致呈现视觉标记的层次结构:从获取单个细胞的16×16图像到4096×4096图像表征组织微环境内的相互作用。研究者引入了一种新的ViT架构,称为分层图像金字塔变换器(HIPT),它利用WSI中固有的自然分层结构,使用两个级别的自监督学习来学习高分辨率图像表示
Vision+Transformers(ViT)是一种多尺度和分层变换已成功地捕获图像表示,但它们的使用通常被研究用于低分辨率图像(例如256×256、384×384)。
1 概括
在计算病理学中的千元素全玻片成像(WSI)中,WSI存在20倍放大率下可以大致呈现视觉标记的层次结构:从获取单个细胞的16×16图像到4096×4096图像表征组织微环境内的相互作用。
研究者引入了一种新的ViT架构,称为分层图像金字塔变换器 (HIPT),它利用WSI中固有的自然分层结构,使用两个级别的自监督学习来学习高分辨率图像表示。HIPT使用10,678千兆像素WSI、408,218 4096×4096图像和104M 256×256图像对33种癌症类型进行了预训练。在9个幻灯片级任务上对HIPT表示进行基准测试,并证明:
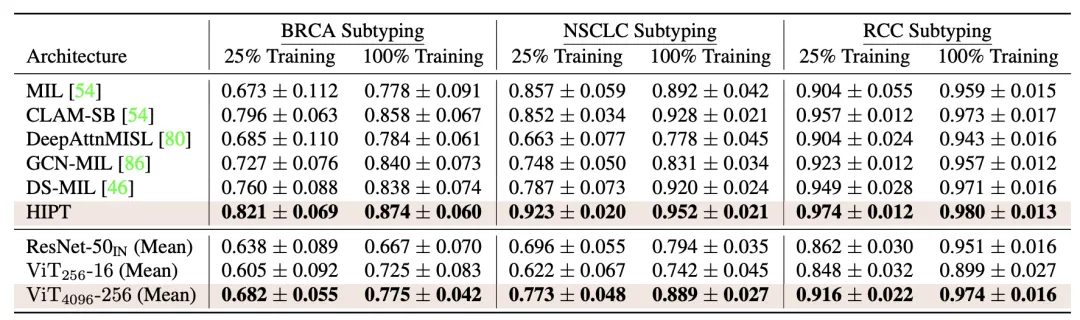
- 具有分层预训练的HIPT优于当前非常先进的癌症分型和生存预测方法;
2) 自监督ViT能够对重要的归纳建模关于肿瘤微环境中表型的层次结构的偏见。
2 主要框架
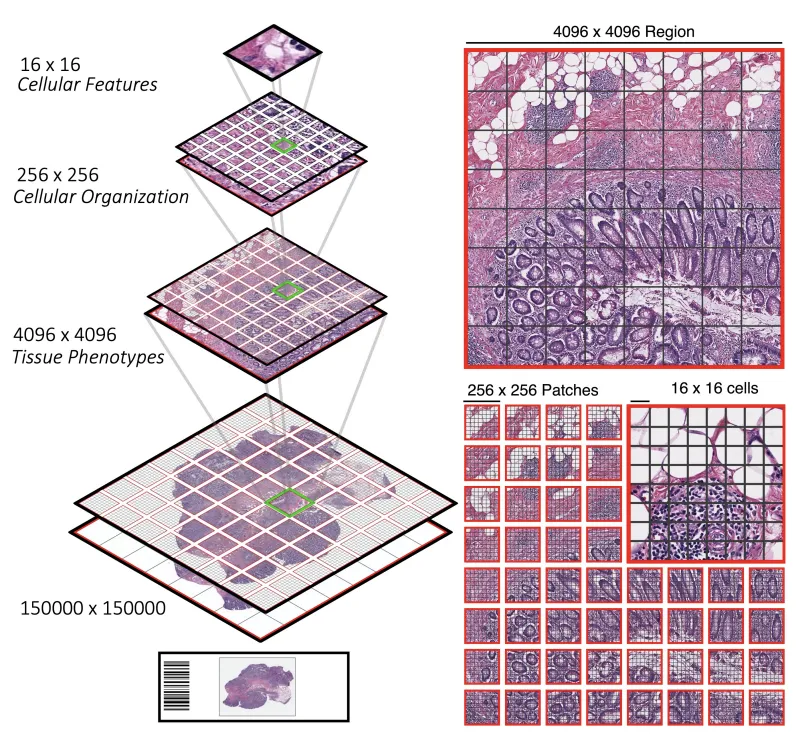
整张幻灯片图像(WSI)的层次结构。左边:与自然图像不同,由于WSI具有固定的比例,因此存在不同图像分辨率的视觉标记的层次结构。右边:除了将单个256×256图像表示为256 [16×16]标记的序列外,还可以将这些256×256图像视为4096中更大的、不相交的[256×256]标记序列的一部分。
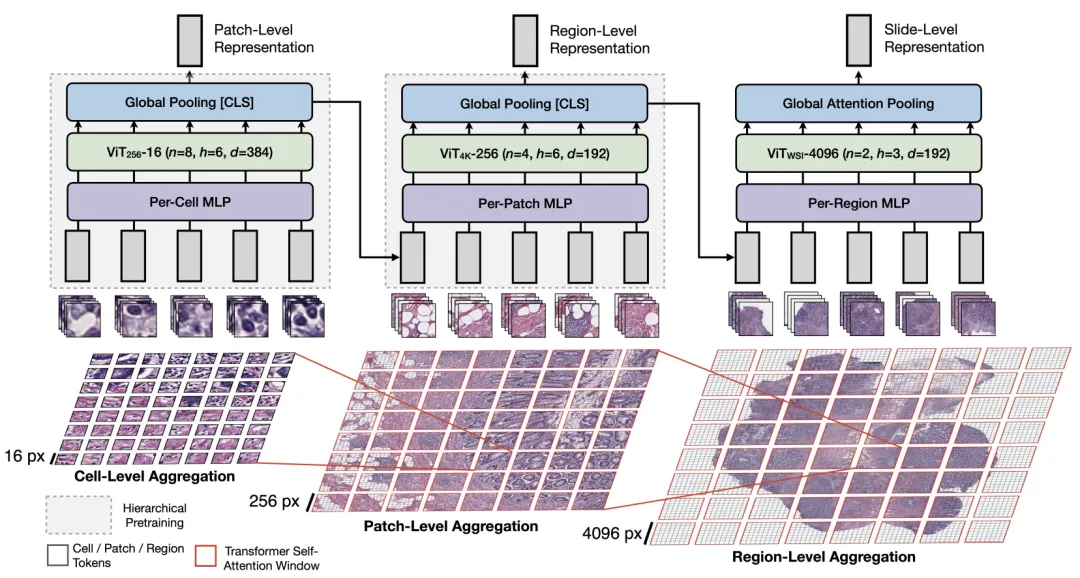
HIPT 架构
受在自然语言处理中使用分层表示的启发,其中嵌入可以在字符、单词、句子和段落级别聚合以形成文档表示,在x16单元格、x256补丁、x4096区域级以形成幻灯片表示。为了在每个阶段对视觉概念之间的重要依赖关系进行建模,将Transformer自注意力调整为置换等变聚合层。请注意,由于使用x256标记修补x4096区域的复杂性与使用x16标记修补x256图像的复杂性相同,可以使用类似的自监督ViT技术为低分辨率图像预训练高分辨率图像的聚合层。
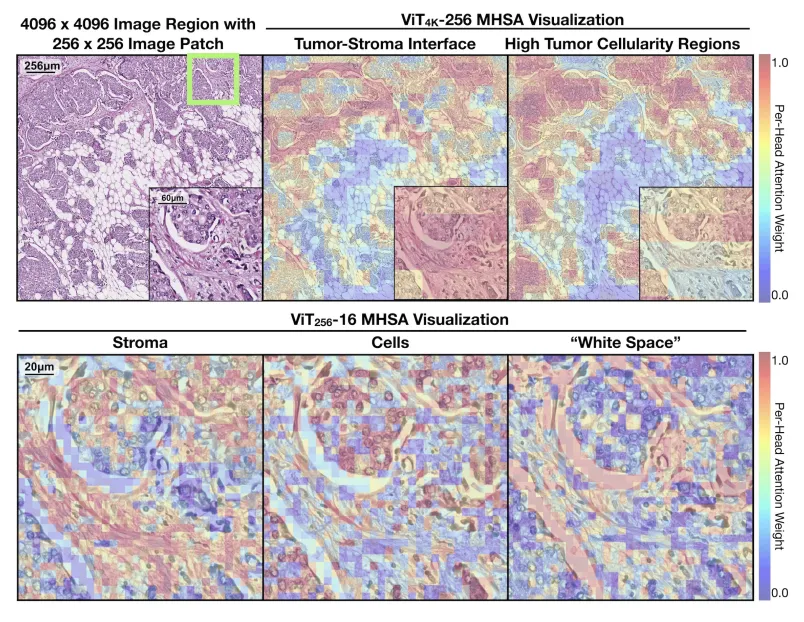
Multi-Head Self-Attention Visualization of SelfSupervised ViTs
对于浸润性导管癌(IDC),展示了ViT256-16和ViT4096-256的自监督可视化,分别在x256和x4096区域上进行了预训练。对于x256补丁,ViT256-16能够描绘x16 tokens中的基质、细胞和“空白”存在。对于x4096区域,ViT4096-256描绘了粗粒度的形态特征,例如肿瘤巢及其周围的促纤维增生(松散)基质。
3 实验
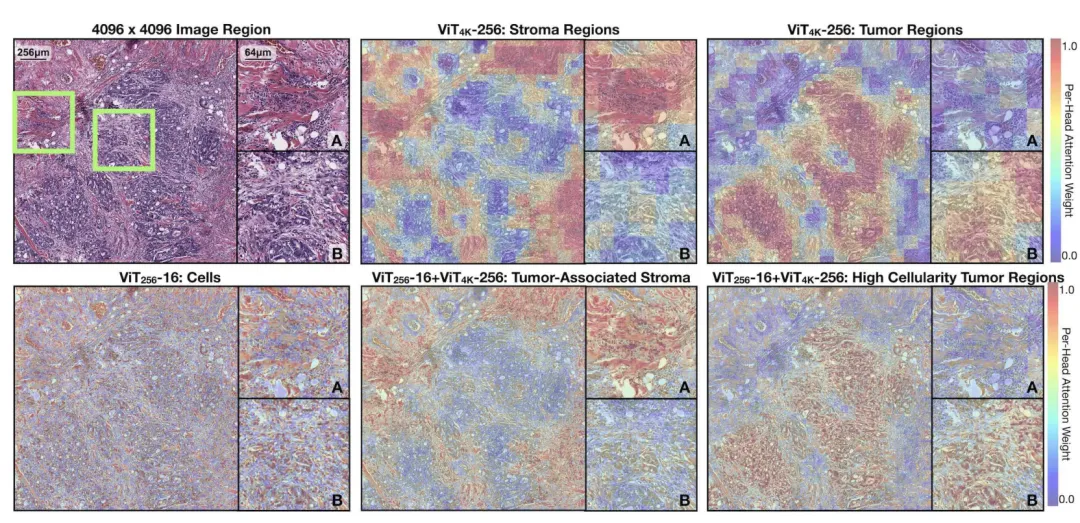
HIPT中的Hierarchical Attention Maps
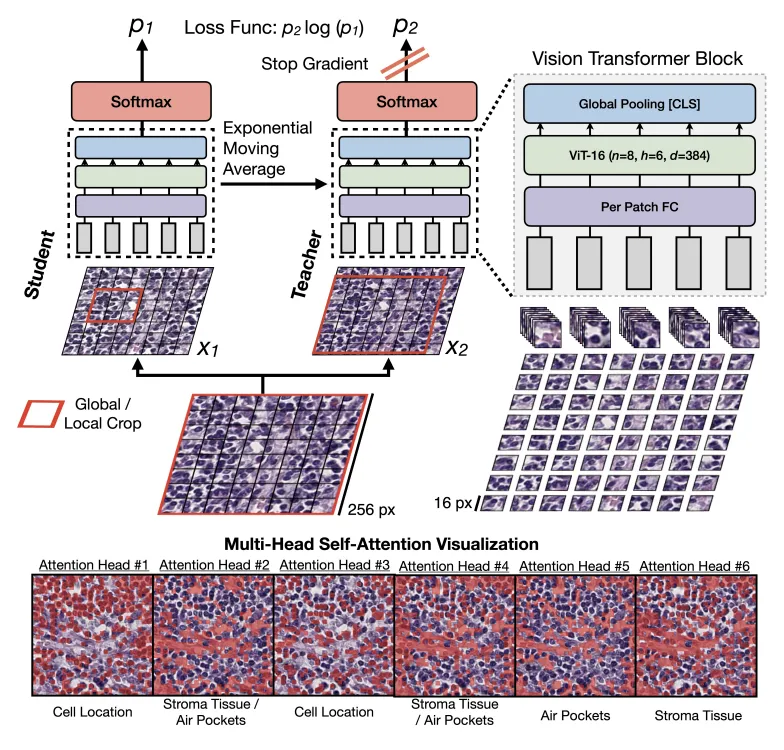
ViT256-16 DINO Pretraining
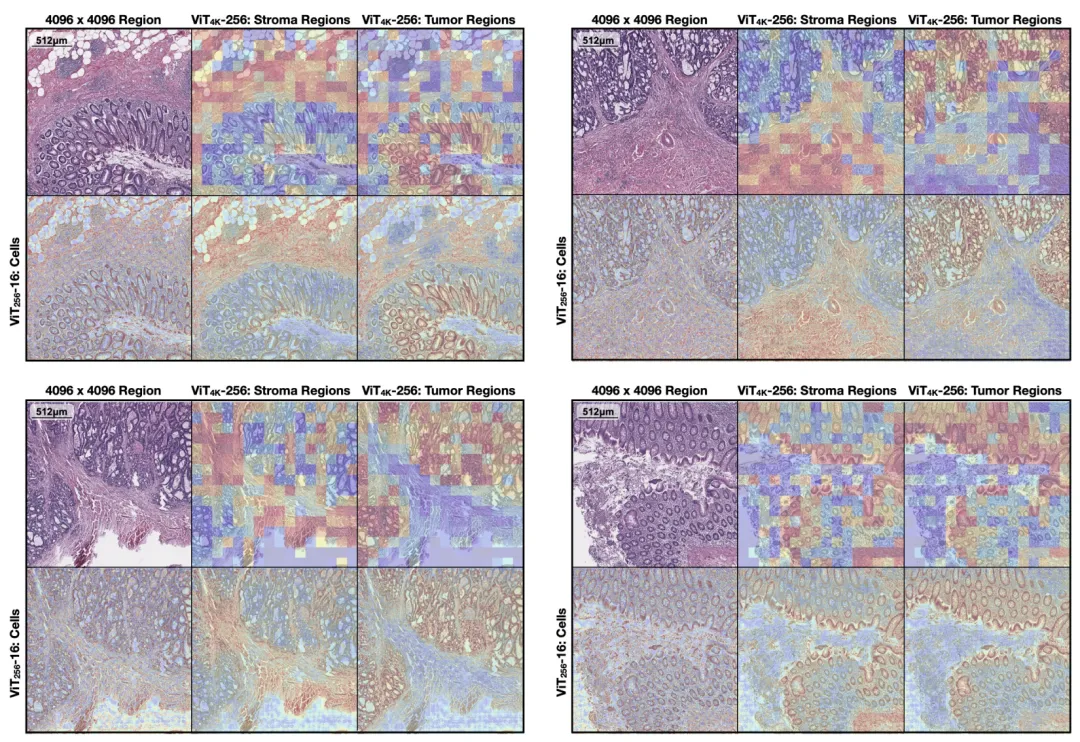
Hierarchical Attention Maps for Colorectal Cancer (CRC)
在数字化浪潮席卷日常生活的今天,屏幕已成为我们获取信息、完成工作、消费娱乐的主要窗口。而视觉输入的质量,正从单纯的审美偏好,悄然升级为影响认知效率与工作效能的关键因素。下面就从几个核心场景出发,看看五款各有侧重的视觉工具,它们分别覆盖了内容消费、身份管理、专业观影、协同办公与创意表达——每款都经过了
在数字影像领域,画质与内容质量始终是用户最关心的问题。面对网络上层出不穷的低分辨率、高噪点、色彩失真的视频内容,如何快速找到真正值得看的优质影像?这里整理了五款各具特色的视觉工具,从内容消费到创作辅助,覆盖了不同场景下的核心需求。 1、《视觉》 这个应用的核心思路很直接:把经过严格筛选的高品质影视资
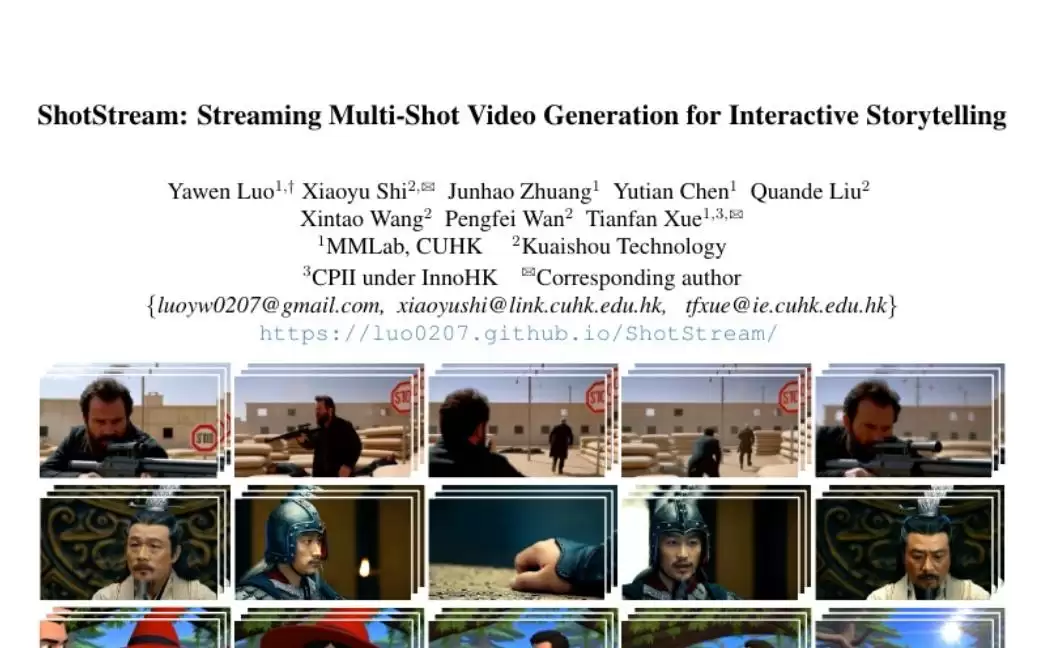
从单镜头到电影叙事:交互式AI视频生成的技术突破 这项由香港中文大学多媒体实验室、快手科技以及香港创新科技研究院联合开展的研究,已于2026年3月发表在计算机视觉顶级会议上,论文编号为arXiv:2603.25746v1。对技术细节感兴趣的读者,可以通过该编号查阅完整的学术论文。 当前的AI视频生成
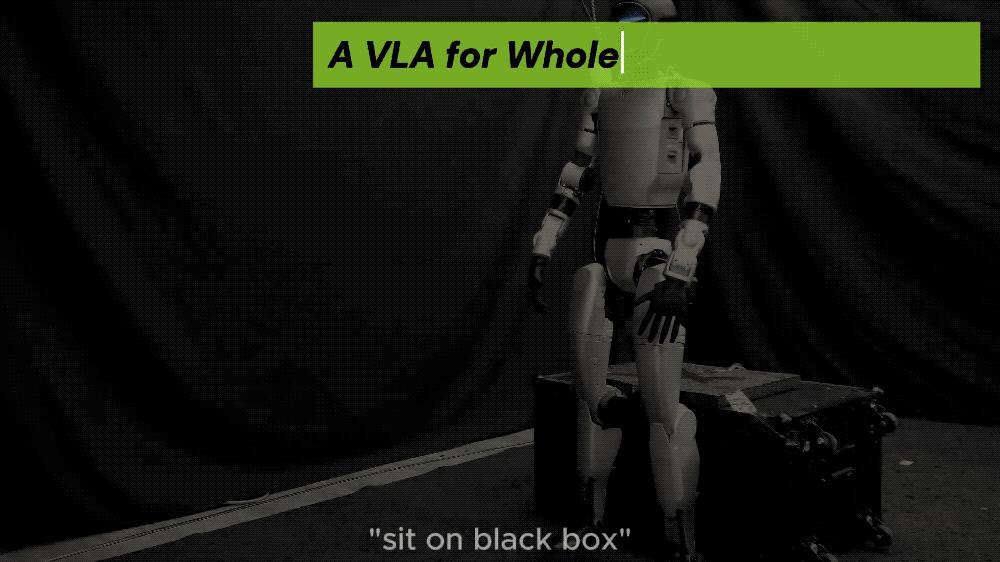
不用提前熟悉环境,一声令下,就能让宇树机器人坐在椅子上、桌子上、箱子上!还能直接解锁"跨过箱子"、"敲门"等任务~这是来自UC伯克利、卡内基梅隆大学等团队的最新研究成果LeVERB框架——基于模拟数据训练实现零样本部署,让人形机器人通过感知新环境,理解语言指令就能直接完成全身动作。传统人形机器人要么"能看懂指令却动不了"(缺乏全身控制能力),要么"只能机械执行动作却读不懂环境"(依赖人工预设动作库)。LeVERB首次打通了视觉语义理解与物理运动两者之间的断层,让机器人能像
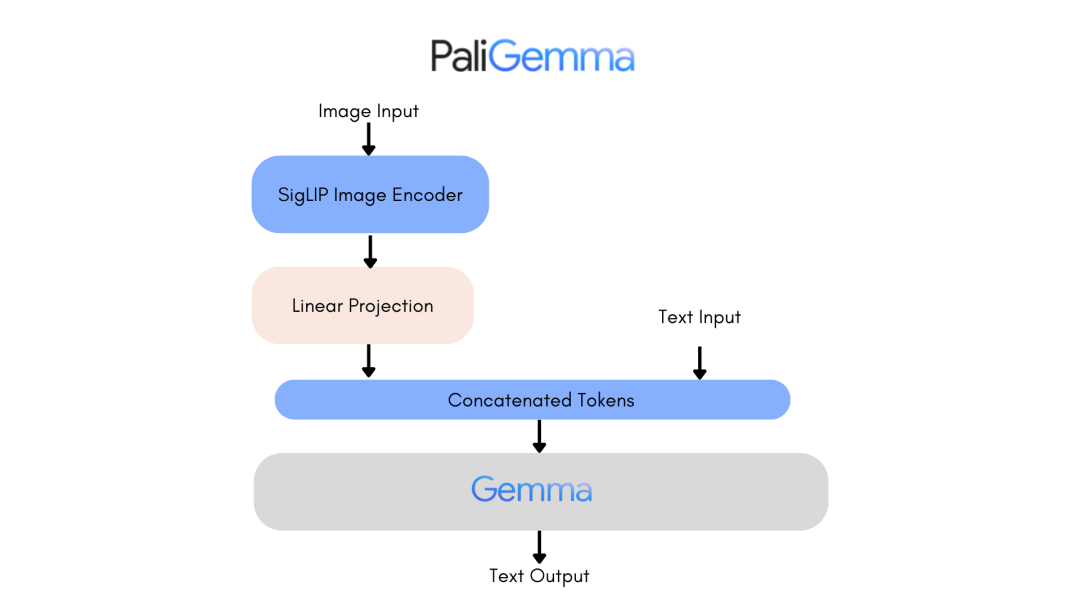
前言该模型结合了SigLIP视觉模型和Gemma语言模型,这两种模型都是开放组件,使得PaliGemma在处理视觉与语言结合的任务上表现出色。PaliGemma的使用场景包括图像字幕、图像标签和视觉问答等。这些应用场景利用了PaliGemma的能力来理解图像内容并提取关键特征,然后将这些信息转化为语言输出,从而实现与用户的交互或自动化内容生成。这种灵活性使得PaliGemma不仅适用于研究和开发环境,也适合商业应用,如客户服务、内容推荐系统等。图片PaliGemma能干什么图片可以在出现提示时为图像添加字
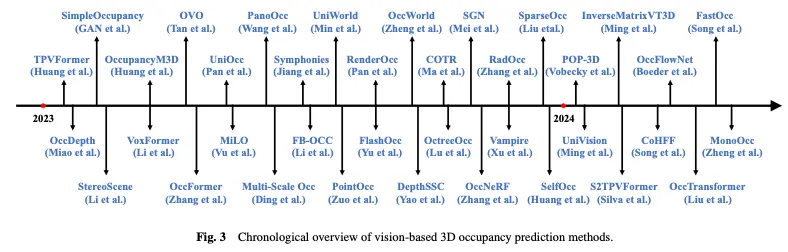
写在前面&笔者的个人理解近年来,自动驾驶因其在减轻驾驶员负担和提高驾驶安全方面的潜力而越来越受到关注。基于视觉的三维占用预测是一种新兴的感知任务,适用于具有成本效益且对自动驾驶安全全面调查的任务。尽管许多研究已经证明,与基于物体为中心的感知任务相比,3D占用预测工具具有更大的优势,但仍存在专门针对这一快速发展领域的综述。本文首先介绍了基于视觉的3D占用预测的背景,并讨论了这一任务中遇到的挑战。接下来,我们从特征增强、部署友好性和标签效率三个方面全面探讨了当前3D占用预测方法的现状和发展趋势。最后,
一、技术革新,DeDoDev2应运而生在图像处理和计算机视觉领域,关键点检测是许多应用的基础,如目标识别、图像匹配、三维重建等。然而,传统的关键点检测技术往往存在着在检测不准确、易受噪声干扰等问题。为了解决这些问题,Linköping大学等科研团队推出了DeDoDev2,这款全新的关键点检测器,通过深入分析DeDoDe的不足之处,并针对性地进行改进和优化。二、突破瓶颈,DeDoDev2的三大创新点解决关键点聚类问题在DeDoDe中,研究人员发现关键点往往容易在特定区域聚集,导致在其他区域检测不足,从而影响
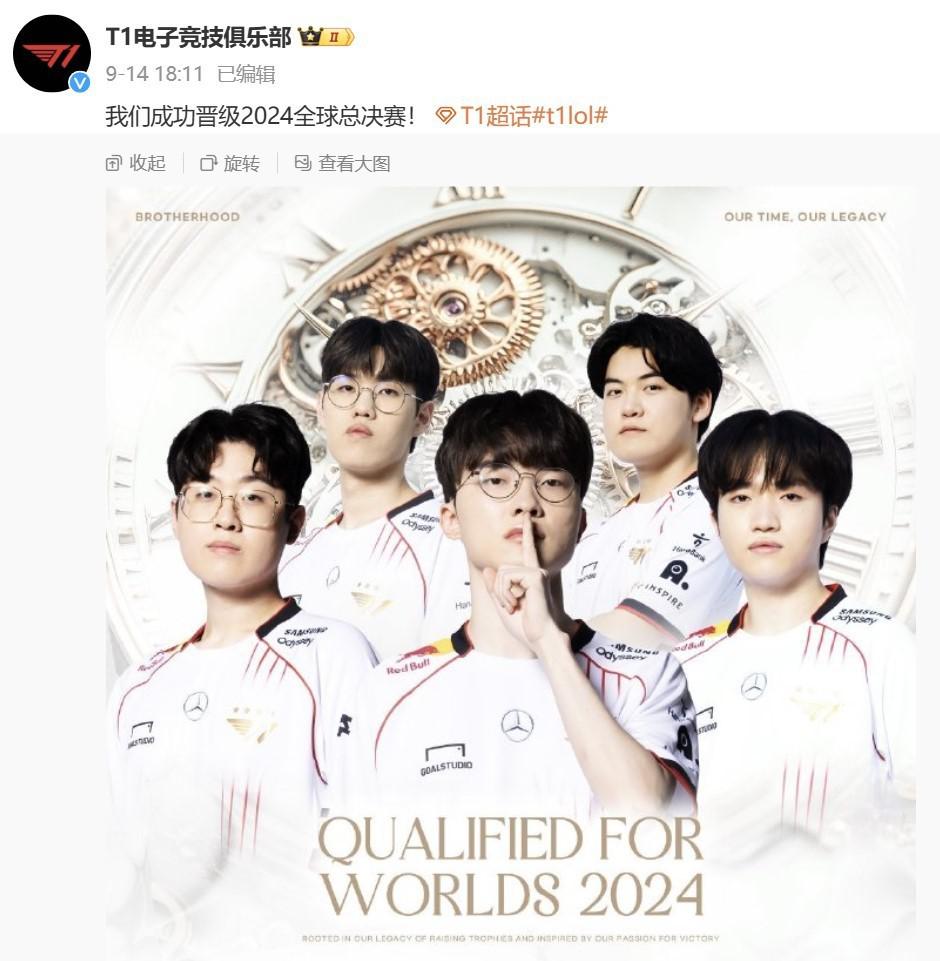
在英雄联盟赛场上书写传奇的选手Faker带领T1战队晋级2024全球总决赛,这也是他第9次晋级全球总决赛,刷新了英雄联盟职业联赛的纪录。在Faker卓越的技术、冷静的头脑和不懈的努力背后,还有三星玄龙骑士电竞显示器成为他征战沙场的得力助手。1.打造电竞巅峰:电竞显示器专门为游戏玩家打造的电竞显示器无疑是显示技术的巅峰之作。在激烈竞争的竞技场中,唯有电竞显示器的强悍性能才能充分发挥硬件的潜能,为玩家带来流畅且真实的极致游戏体验。三星玄龙骑士:视觉盛宴三星玄龙骑士凭借其卓越的性能和前沿科技,为游戏玩家开启了前
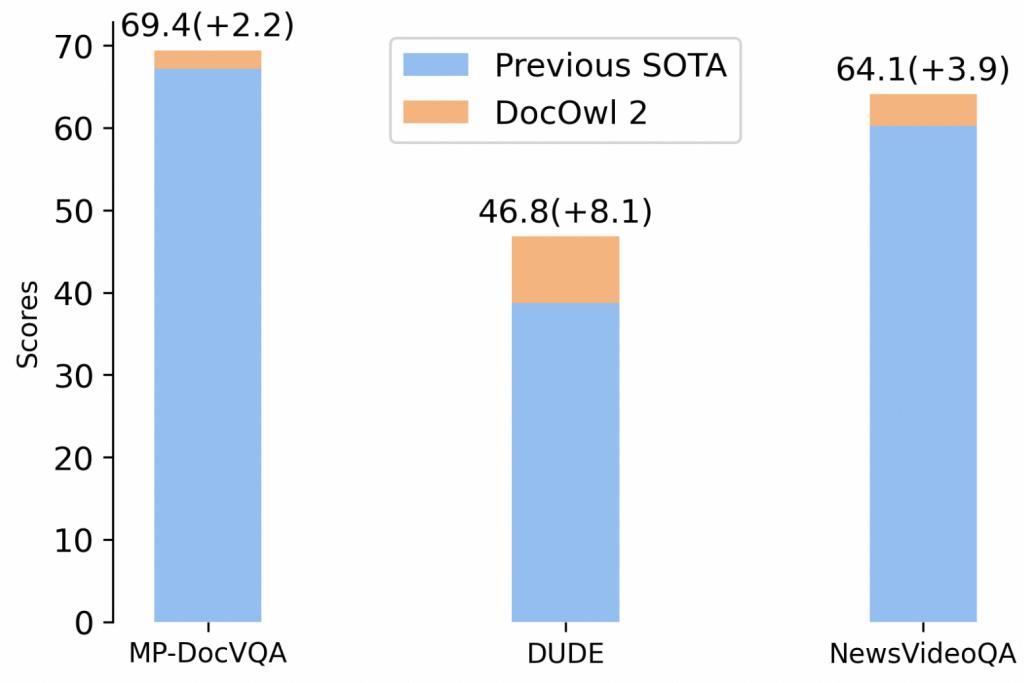
高效多页文档理解,阿里通义实验室mPLUG团队拿下新SOTA。最新多模态大模型mPLUG-DocOwl2,仅以324个视觉token表示单个文档图片,在多个多页文档问答Benchmark上超越此前SOTA结果。并且在A100-80G单卡条件下,做到分辨率为1653x2339的文档图片一次性最多支持输入60页!△单个A100-80G最多能支持文档图片(分辨率=1653x2339)的数量以及首包时间mPLUG-DocOwl是利用多模态大模型进行OCR-free文档理解的一系列前沿探索工作。DocOwl1.0首





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



