

用GPT-3.5生成数据集!北大天工等团队图像编辑新SOTA,可精准模拟物理世界场景
高质量图像编辑的方法有很多,但都很难准确表达出真实的物理世界。那么,EdittheWorld试试。图片北京大学、TiamatAI、天工AI、Mila实验室提出了EditWorld,他们引入了一种新的编辑任务,即世界指令(world-instructed)图像编辑。它定义和分类基于各种世界场景的指令。图片在一组预训练模型,比如GPT-3.5、Video-LLava和SDXL的支持下,建立了一个带有世界指令的多模态数据集。在该数据集训练了一个基于扩散的图像编辑模型EditWorld,结果在其新任务的表现明显优
高质量图像编辑的方法有很多,但都很难准确表达出真实的物理世界。
那么,Edit the World试试。
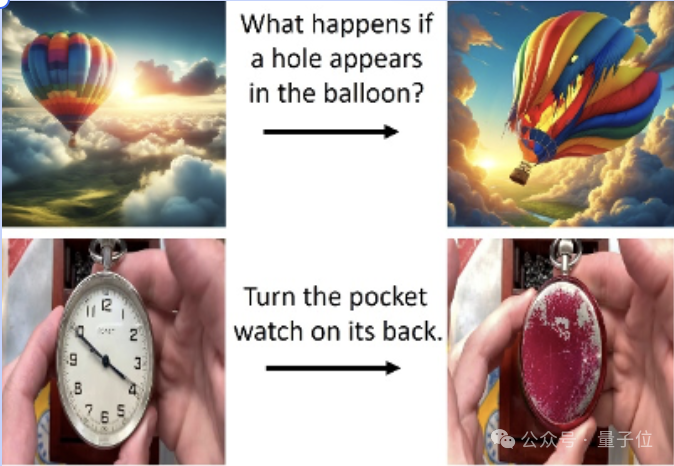 图片
北京大学、Tiamat AI、天工AI、Mila实验室提出了EditWorld,他们引入了一种新的编辑任务,即世界指令(world-instructed)图像编辑。它定义和分类基于各种世界场景的指令。
 图片
在一组预训练模型,比如GPT-3.5、Video-LLava 和 SDXL的支持下,建立了一个带有世界指令的多模态数据集。
在该数据集训练了一个基于扩散的图像编辑模型EditWorld,结果在其新任务的表现明显优于现有的编辑方法,实现了SOTA。
图像编辑新SOTA
现有的方法通过多种途径实现高质量的图像编辑,包括但不限于文本控制、拖动操作以及inpainting。其中,利用instruction进行编辑的方法由于使用方便受到广泛的关注。
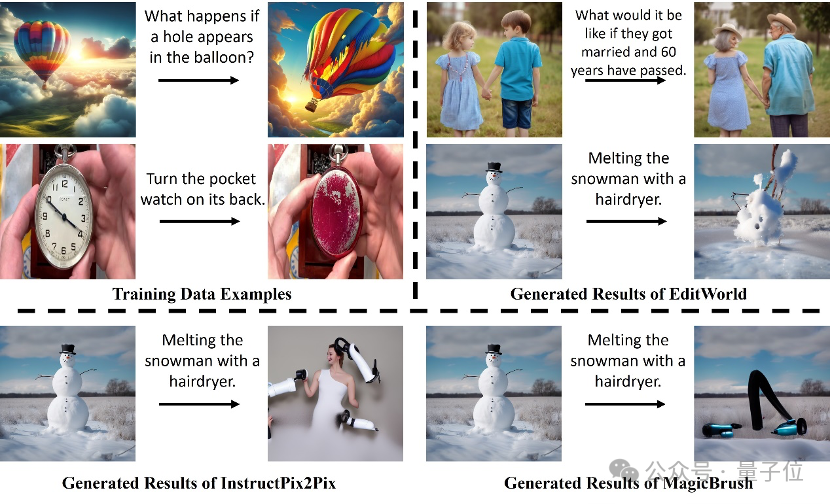
尽管图片编辑方法能够产生高质量的结果,但它们在处理传达物理世界中真实视觉动态的世界动态方面仍然存在困难。
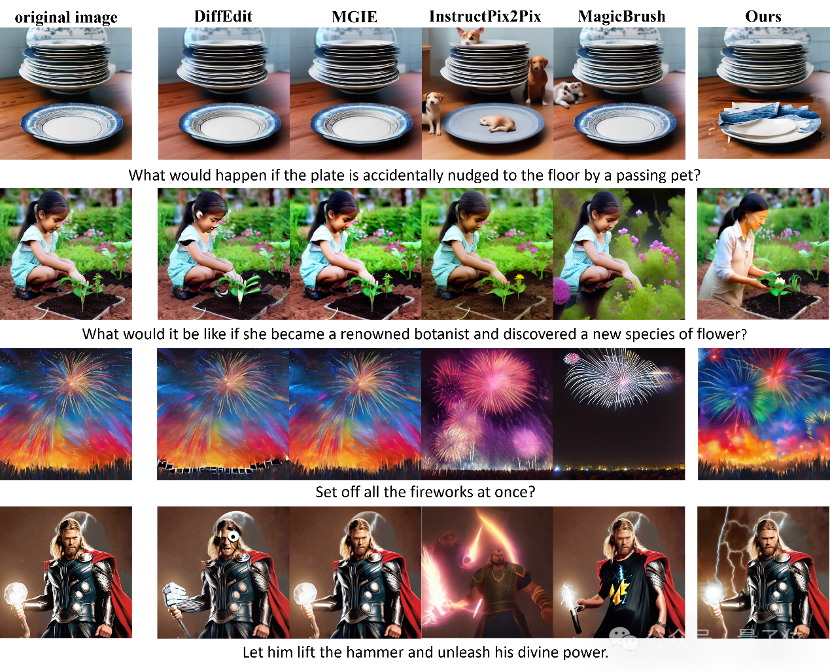
如图1所示,无论是InstructPix2pix还是MagicBrush都无法生成合理的编辑结果。
 图片
为了解决这一问题,团队引入了一项新的任务,称为world-instructed image editing,使图像编辑能够反映真实物理世界和虚拟媒体中的“世界动态”。
具体来说,他们定义并分类了各种世界动态指令,并基于这些指令创建了一个新的多模态训练数据集,该数据集包含大量的输入-指令-输出三元组。
最后,团队使用精心制作的数据集训练了一个文本引导的扩散模型,并提出了一种零样本图像操作策略,以实现world-instructed image editing。
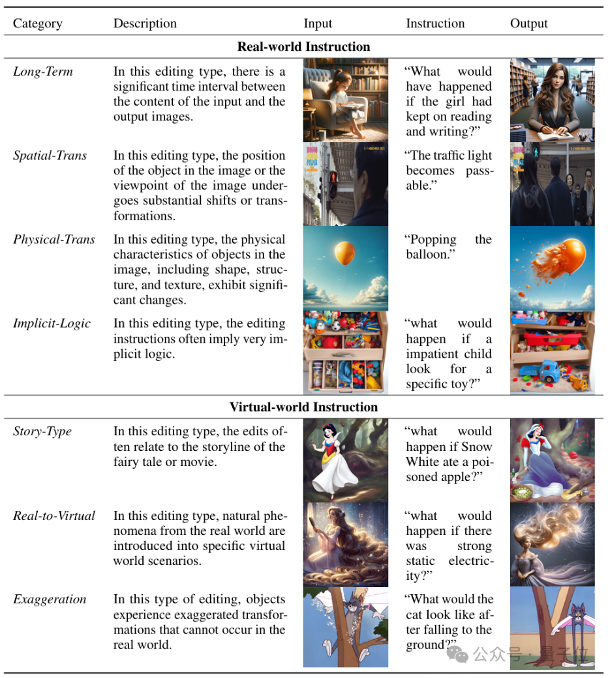
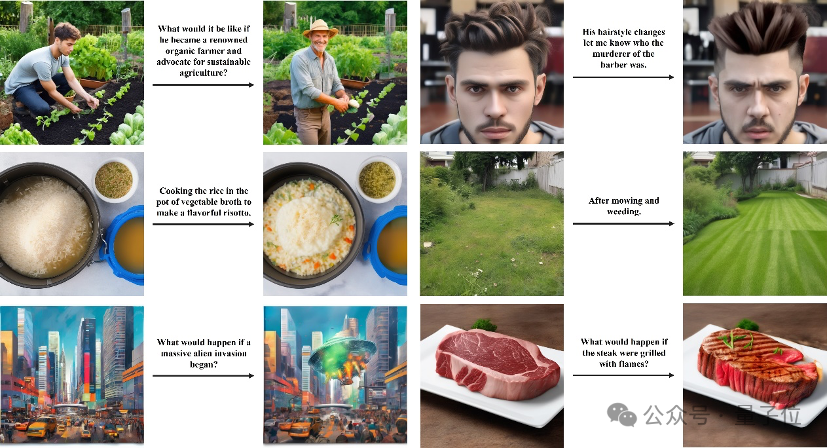
根据现实世界以及虚拟媒体中的任务场景,将world-instructed image editing分为7种认为类别,并对每一种类别进行了定义与介绍,同时提供了一个数据样例。
 图片
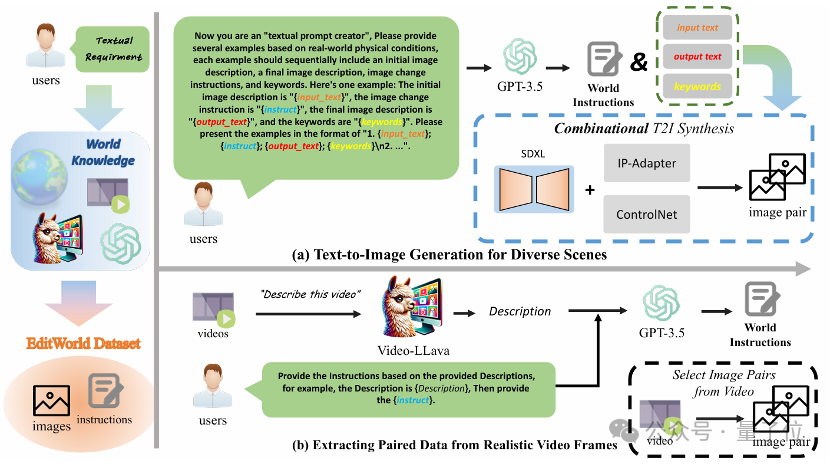
随后团队设计了文本到图片生成以及视频分镜提取两个分支来获取数据集。
文本生成图片分支是为了丰富数据场景的丰富性,在该分支下,团队首先利用GPT生成文本四元组(包括input图片描述、instruction、output图片描述以及关键词),接着利用input以及output描述生成对应文本的图片,利用关键词对应的attention map对编辑位置进行定位获取编辑mask,与此同时为了保证前后两张图关键特征的一致性,团队引入了image prompt adaption的方法IP-Adapter,最后团队使用IP-Adapter以及ControlNet,结合output image的canny map以及input image的image prompt feature,利用Image Inpainting对output image进行调整,从而获得比较有效的编辑数据。
 图片
利用文本生成图片分支得到场景丰富的数据后,为了能向数据集中添加真实数据,团队从视频中提取高质量的关键帧作为编辑数据。具体来说,团队从视频分镜中提取相关性强且结构差异大两帧作为起始与末尾帧,并切分出一段新的分镜,利用多模态大模型对这段分镜的变化进行描述,最后团队以起始与末尾帧作为input image以及output image,以得到的描述作为instruction,这样就获得了需要的编辑数据。
再进一步,团队利用人工对生成数据进行recheck,从而进一步提升数据质量。
团队利用数据集对InstructPix2Pix模型进行finetune,同时为了保护非编辑区域实现更为精确的编辑,团队提出了post-edit策略。
 图片
 图片
最终可以看到,团队的方法可以很好地实现world-instructed image editing。
论文链接:
https://arxiv.org/abs/2405.14785
代码链接:
https://github.com/YangLing0818/EditWorld
摩尔线程发布并开源MusaCoder,这是首个基于国产GPU全栈自主训练与验证的代码大模型。在KernelBench评测中,其27B强化学习版本性能全面超越ClaudeOpus等主流模型,标志着国产GPU生态实现从“能用”到“领先”的加速跨越,技术实力显著提升。
全球评测机构ArtificialAnalysis发布全新基准CodingAgentIndex,聚焦智能体开发框架与模型组合解决实际编程任务的能力。测试覆盖多个主流编程基准,结果显示闭源模型Opus4.7领先,而开源模型中GLM-5.1表现最佳,代表国产大模型在实战环境中已达到世界顶尖水平。
今天,小米汽车发布了一项名为Xiaomi Auto World Model的全新框架,为业界辅助驾驶世界模型的发展提供了一条新路径。这标志着行业正从基础的“场景感知”,朝着“认知推演、场景进化”的高阶形态迈进。 简单来说,这个框架的核心突破在于,它首次将三维重建与视频生成深度耦合,形成了一个一体化架
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
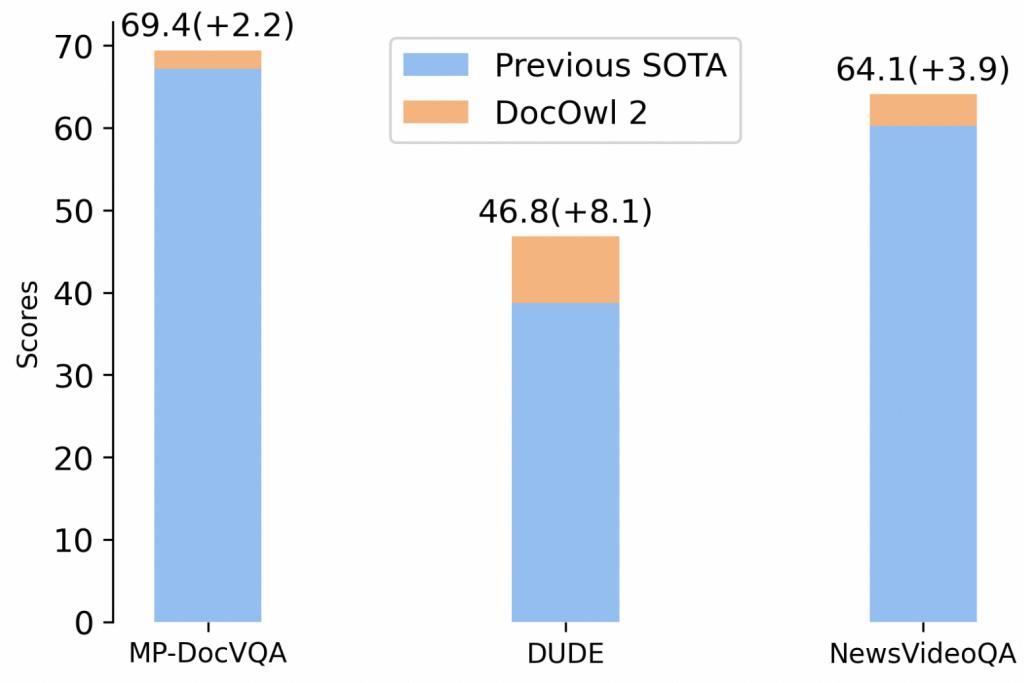
高效多页文档理解,阿里通义实验室mPLUG团队拿下新SOTA。最新多模态大模型mPLUG-DocOwl2,仅以324个视觉token表示单个文档图片,在多个多页文档问答Benchmark上超越此前SOTA结果。并且在A100-80G单卡条件下,做到分辨率为1653x2339的文档图片一次性最多支持输入60页!△单个A100-80G最多能支持文档图片(分辨率=1653x2339)的数量以及首包时间mPLUG-DocOwl是利用多模态大模型进行OCR-free文档理解的一系列前沿探索工作。DocOwl1.0首
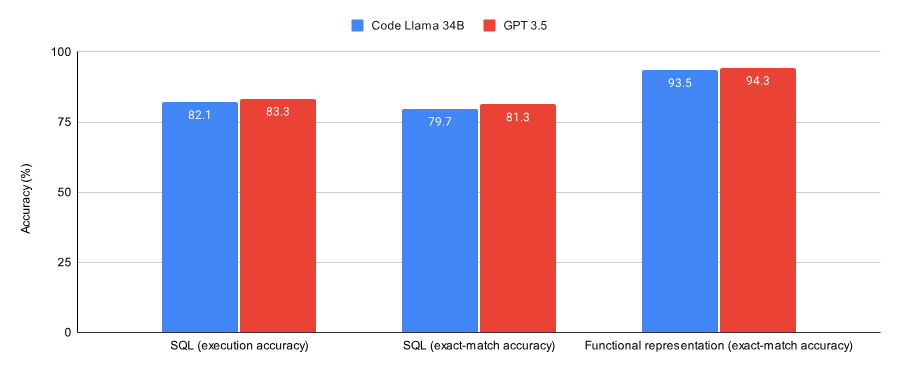
通过对GPT-3.5和Llama2在不同任务上的参数对比,我们可以得知在什么情况下选择GPT-3.5,什么情况下选择Llama2或其他模型。显然,对GPT-3.5进行的扭矩是非常昂贵的。本文通过实验来验证手动扭矩模型是否可以接近GPT-3.5的性能,而只是成本GPT-3.5的一部分。有趣的是,论文确实做到了。在SQL任务和函数表示任务上的结果对比,论文发现:GPT-3.5在两个数据集(Spider数据集的子集以及Viggo函数表示数据集)上都比经过Lora的CodeLlama34B表现轻微好一点。GPT-
近年来,随着深度学习的发展和大规模数据集的出现,深度学习在很多领域也取得了进展,但其中「人脸复原」(FaceRestoration)任务仍然缺乏系统性的综述。最近,来自南京大学、澳大利亚国立大学、中山大学、帝国理工学院和腾讯的研究者们全面回顾并总结了基于深度学习的人脸复原技术的研究进展,对人脸复原方法进行了分类,讨论了网络架构、损失函数和基准数据集,并对现有SOTA方法进行了系统性性能评测。论文链接:https://arxiv.org/abs/2211.02831仓库链接:https://github
4月9日消息,据Theregister报道,加拿大隐私专员办公室正调查OpenAI的生成式聊天应用ChatGPT,因为该监督机构收到了一份投诉,指控ChatGPT在未经同意的情况下收集、使用和披露个人信息。加拿大隐私专员PhilippeDufresne表示:“人工智能技术及其对隐私的影响是我办公室的重点关注领域。我们需要跟上并领先于快速发展的技术进步,这也是我作为专员的主要关注点之一。”ChatGPT是由GPT-3.5大型语言模型驱动的,它是通过从互联网上抓取大量文本进行训
Mate70 Pro与iPhone16 Pro拍照样张对比:观察食物暖色、展厅背景色差和红叶层次,说明构图与拍摄条件的限制,区分风格偏好与综合影像能力。
解析本周AI产品动态:说明Claude Ultra仅对已验证账户取消五小时窗口限制而非无限使用;明确Apple智能接入千问处于开发者测试阶段,非全量Siri能力开放;指出GO-3与灵渠OS仅为场景演示,不提供通用部署教程。引导用户依据官方公告核对自身设备与账户条件。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



