

如何借助假设文档嵌入改进语义搜索?

Air Explorer Pro是一款跨平台多网盘管理工具,可实现一站式完成不同网盘间文件的互传、搜索和同步等操作。任务管理和过程控制会更完整,持续下载、批量同步或需要稳定传输流程的场景会更适合它。
想了解更多AIGC的内容,请访问:51CTOAI.x社区https://www.51cto.com/aigc/本文介绍了如何使用简单的大语言模型(LLM)调用来显著改善语义搜索结果的质量。找到适合的AI模型来构建工作流程很困难。由于不同平台上有众多的模型可用,因此不可知道从哪里入手,或者如何找到最适合您特定需求的模型。这就是我打算用AIModels.fyi解决的问题,这是唯一用来发现和比较网上的AI模型的搜索引擎。该网站提供一个简单的前提:用自然语言描述问题,然后详细列出可能会解决问题的AI模型。比如说,

想了解更多AIGC的内容,请访问:
51CTO AI.x社区
https://www.51cto.com/aigc/
本文介绍了如何使用简单的大语言模型(LLM)调用来显著改善语义搜索结果的质量。
找到适合的AI模型来构建工作流程很困难。由于不同平台上有众多的模型可用,因此不可知道从哪里入手,或者如何找到最适合您特定需求的模型。这就是我打算用AIModels.fyi解决的问题,这是唯一用来发现和比较网上的AI模型的搜索引擎。
该网站提供一个简单的前提:用自然语言描述问题,然后详细列出可能会解决问题的AI模型。比如说,您可搜索“我需要一个模型,可在不失去清晰度的情况下帮助提升图片质量”或“让我的猫看起来像是在唱歌”。目的是让任何人(不仅仅是机器学习工程师)都能为其项目轻松找到有用的AI工具。
在底层,搜索的工作原理是获取用户的查询后,将其与来自Hugging Face、Replicate、Cerebrium和DeepInfra等主要平台的7500多个创建者的逾24万个AI模型组成的数据库进行比较。用户输入搜索后,使用OpenAI的text-embedding-ada-002模型将查询嵌入到向量中。然后将该查询向量与数据库中模型名称、描述和用例的预计算向量表示进行比较。余弦距离最相似的模型作为搜索结果返回。
以下是我使用了六个月的核心搜索逻辑的简化版本:
const fetchData = async (query) => {// Embed the search queryconst embeddingResponse = await openAi.createEmbedding({model: "text-embedding-ada-002",input: query,});const embedding = embeddingResponse.data.data[0].embedding;// Find the most similar models in the vector database const { data: modelsData, error } = await supabase.rpc("search_models", {query_embedding: embedding,similarity_threshold: 0.75,match_count: 10,});return modelsData;};当查询术语和模型描述之间存在直接重叠时,这种向量搜索方法可以很好地显示相关模型。但是面对更抽象、更复杂或更小众的查询时,由于用户的语言与数据库中的技术术语并不完全匹配,它的实现效果就勉为其难。
比如说,我最近想找到一种模型,可以使用音频片段来创建具有动画效果的肖像图像。我知道有几个很好的模型,但我搜索“由图像和音频创建会说话的肖像”并没有返回预期的结果。问题在于,我的查询术语与模型描述中使用的特定词没有足够的文字匹配,即使语义意图是相似的。
这让我开始思考如何改善搜索体验,以更好地处理这种抽象或复杂的查询。我怎样才能让系统更智能地理解用户的真实意图,并将其映射到数据库中的相关模型?我无意中看到了这篇研究论文(https://arxiv.org/abs/2212.10496),因此有机会了解了假设文档嵌入(HyDE)想法。
HyDE——查询扩展器!
HyDE背后的关键理论是,在嵌入搜索之前,使用大语言模型(LLM)将用户的简短查询扩展为更详细的假设“理想”文档。因此,它不是直接将查询嵌入与数据库嵌入相匹配,而是先将查询转换为与实际文档在相同语义空间中更丰富的表示。
整个过程是这样的:
- 用户输入表达需求的自然语言查询,比如“我想把一个图像转换成3D模型。”
- 然后使用像OpenAI的text-embedding-ada-002这样的模型,将生成的这个伪文档嵌入到密集向量中。
- 因此获得的嵌入用于查询向量数据库,并找到最相似的实际模型文档。
该查询被馈入到指令调优的LLM(比如GPT-3)中,以生成假设文档。提示要求模型想象一个回答查询的理想文档。举例说:
查询:我要将图像转换为3D模型。
假设文档:市面上有几种AI模型可以将2D图像转换为3D模型。这个过程名为单视图重建或3D估计。它通常需要使用深度学习由2D输入图像预测深度图和3D形状。处理这项任务的一些流行模型包括Pix2Vox、Pixel2Mesh、AtlasNet和OccNet。这些模型是使用庞大的3D对象数据集加以训练的,可以处理复杂形状。要使用它们,您就要提供输入图像,模型会输出一个3D网格或三维像素表示,您可以在3D建模工具中渲染或进一步编辑。
LLM步骤有助于弥合用户的简单查询和模型描述中使用的技术性更强的语言之间的差距。它在初始查询的基础上进行扩展,以推断有助于检索更好匹配的其他相关术语、概念和上下文。与此同时,使用真实的文档嵌入作为最终的搜索索引可以使搜索结果更可靠,防止幻觉问题。
我在现有的AIModels搜索上实施了HyDE的基础版本,初步结果令人满意。在我测试的一些示例查询中,HyDE显示的相关模型比原始关键字匹配方法多两三倍。对于会说话的头像查询,它能够生成一个假设文档,含有“对口型”、“脸部动画”和“音频驱动动画”等关键术语,这有助于检索普通搜索忽略的一些强匹配模型。
如何在您自己的搜索系统中实现HyDE?
不妨展示如何将HyDE添加到现有的语义搜索系统上,从而显著提高质量。
不妨从基于我当前搜索流的简化代码草图入手。以下是完整的文件,在我们查看各部分之前,您可以浏览一下整体:
const fetchData = async (query) => {// Generate a hypothetical document embedding for the query const hypotheticalDocument = await generateHypotheticalDocument(query);const embeddingResponse = await openAi.createEmbedding({model: "text-embedding-ada-002",input: hypotheticalDocument,});const embedding = embeddingResponse.data.data[0].embedding;// Search the real model embeddings using the hypothetical document embeddingconst { data: modelsData, error } = await supabase.rpc("search_models", {query_embedding: embedding,similarity_threshold: 0.75,match_count: 10,});return modelsData;};const generateHypotheticalDocument = async (query) => {// Use GPT-3 to expand the query into a hypothetical ideal documentconst prompt = `The user entered the following search query: "${query}"Please generate a detailed hypothetical document that would be highly relevant to answering this query. The document should use more technical language and expand on the key aspects of the query.Hypothetical Document:`;const response = await openAi.createCompletion({model: "text-davinci-002",prompt: prompt,max_tokens: 200,n: 1,stop: null,temperature: 0.5,});const hypotheticalDocument = response.data.choices[0].text.trim();return hypotheticalDocument;}看看它是如何工作的。我们将从fetchData函数开始,这是搜索过程的主要入口点。首先:
const hypotheticalDocument = await generateHypotheticalDocument(query);
这一行调用generateHypotheticalDocument函数(稍后会有详细解释),基于用户的搜索查询生成一个假设的理想文档。
假设文档是HyDE方法的关键部分,因为它旨在以比原始查询更详细和更技术的方式捕获用户的搜索意图。
const embeddingResponse = await openAi.createEmbedding({model: "text-embedding-ada-002",input: hypotheticalDocument,});const embedding = embeddingResponse.data.data[0].embedding;这几行使用OpenAI的text-embedding-ada-002模型为假设文档生成嵌入向量。我认为这是目前为止最好的嵌入选项。
嵌入是一种将文本表示为密集数字向量的方法,其中相似的文本有相似的向量。这便于我们执行语义相似度搜索。
通过嵌入假设文档而不是原始查询,我们旨在获得更好地捕获扩展搜索意图的向量表示。接下来:
const { data: modelsData, error } = await supabase.rpc("search_models", {query_embedding: embedding,similarity_threshold: 0.75,match_count: 10,});这部分在模型数据库中执行实际的相似度搜索。它对Supabase数据库调用远程过程(search_models),将假设文档的嵌入作为query_embedding传入。
similarity_threshold和match_count这两个参数控制结果需要匹配的程度和返回的数量。
搜索基于余弦相似度寻找与查询嵌入最相似的模型嵌入。
现在不妨看看generateHypotheticalDocument函数:
const prompt = `The user entered the following search query: "${query}"Please generate a detailed hypothetical document that would be highly relevant to answering this query. The document should use more technical language and expand on the key aspects of the query.Hypothetical Document:`;这部分构建将发送给语言模型以生成假设文档的提示。
提示包括用户的原始查询和指令,以便模型生成详细的技术文档,从而扩展查询的关键方面。构建有效的提示对于指导语言模型生成实用的假设文档至关重要。
现在是下一个部分:
const response = await openAi.createCompletion({model: "text-davinci-002",prompt: prompt,max_tokens: 200,n: 1,stop: null,temperature: 0.5,});这几行使用OpenAI的text-davinci-002模型基于提示生成假设的文档。
max_tokens参数限制所生成文档的长度,而temperature控制随机性(较高的值使输出更多样化,但可能不那么集中)。调整这些参数有助于调整所生成文档的质量和多样性。
接下来,我们有:
const hypotheticalDocument = response.data.choices[0].text.trim();
这一行从GPT-3 API响应中提取所生成的假设文档文本。然后返回所生成的文本,以便用在嵌入步骤中。
回顾:我们刚刚构建了什么?
我希望代码和我的解释能够演示如何在现有的语义搜索系统上实现HyDE方法。其实没那么难!关键思想是这个:我们旨在通过将假设文档生成和嵌入步骤插入到搜索管道中,借助更好地捕获用户的意图来改进搜索结果。
总结一下,几个关键部分是:
- 使用语言模型将用户的查询扩展为更详细的技术性假设文档。
- 嵌入假设文档,以获得与模型数据库一致的向量表示。
- 在假设文档嵌入和模型嵌入之间执行相似度搜索,以找到最相关的结果。
当然,这只是一种简化的实现,真正的实现中还有许多细节和优化需要考虑。但它阐明了HyDE方法的核心流程和组成部分。
结束语
因为这只是一个初始原型,还有很多试验和改进的余地。我在思考一些关键的开放性问题:
- 生成有用的假设文档的最佳提示结构和输出长度是什么?我想尝试不同的提示模板和输出大小,看看它们如何影响结果质量。
- 如何使假设文档对用户更易于解释、更透明?如果用户不明白为什么添加某些术语,可能会备感困惑。我正考虑将所生成文本的一部分显示为“查询解释”,以便更深入地揭示该过程。
- 结果质量在多大程度上依赖所使用的特定LLM和嵌入模型?我很想对不同的模型组合进行基准测试(比如GPT-4 vs GPT-3和Contriever vs OpenAI嵌入等),以找到最佳配方。
- 如何有效地扩展这种方法,以便处理数百万个数据库条目?在像GPT-3这样的大型LLM上进行推理昂贵又缓慢。我需要研究缓存、优化或提炼模型,以便这种方法在大规模环境中切实可行。
我对语言模型的潜力感到兴奋,可以帮助像AIModels这样的搜索界面对更广泛的受众而言更直观、更强大。弥合用户如何自然表达需求和如何技术上描述AI模型之间的语义差距,是解决这个难题的一个重要环节。HyDE之类的技术为深刻理解用户意图,并满足用户需求的搜索体验指明了一条道路。
我的长期目标是不断完善这个界面,直到任何人都可以轻松地找到符合他们需求的相关AI模型,无论他们的技术专业水平如何。无论您是想“把您的头像变成Studio Ghibli插图”、“由图像生成3D模型”、“为虚拟助手创建文本到语音功能”,还是“找到最好的标志设计AI”,我都希望AIModels是个不错的起点。
随着我继续试验HyDE及其他方法,会分享更多细节。如果您想进一步了解技术方面,建议您查看原始论文。
原文标题:How to improve your semantic search with hypothetical document embeddings,作者:Mike Young
链接:https://notes.aimodels.fyi/improving-ai-model-search-with-hypothetical-document-embeddings/。
想了解更多AIGC的内容,请访问:
51CTO AI.x社区
https://www.51cto.com/aigc/
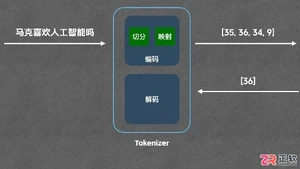
深入解析大模型中的Token与Tokenizer工作机制,通过BPE分词示例说明文字如何转化为数字编号,澄清上下文长度与字数的区别,帮助用户准确评估模型处理长文本的实际能力。

本文解析超聚变在2026数博会发布的“智企”范式,重点阐述如何通过Token生产平台(Token Factory)与企业业务本体建模,实现从简单AI工具调用到企业应用架构系统性重构的演进。文章详细拆解了智能体编排、数字孪生及生态协同等关键技术路径,为AI时代企业数字化转型提供可落地的参考方案。


从Office转向WPS的核心操作肌肉记忆切换通常需3至7天,不影响正常办公。适应期长短取决于界面视觉差异与专属格式配置。通过切换“经典界面”、嵌入字体及开启云同步,可实现平滑过渡。本文详解格式兼容、数据迁移及AI功能适用场景,适用于需多端协同、成本控制及国产化兼容的办公人群。
加拿大一母亲起诉OpenAI,称ChatGPT设计缺陷导致其女儿自杀,指控其优先用户参与度而非安全性,持续提供情感支持致过度依赖。专家指出AI应“陪伴但不过界”,需设定边界并引导求助。国家已出台拟人化互动服务管理办法。
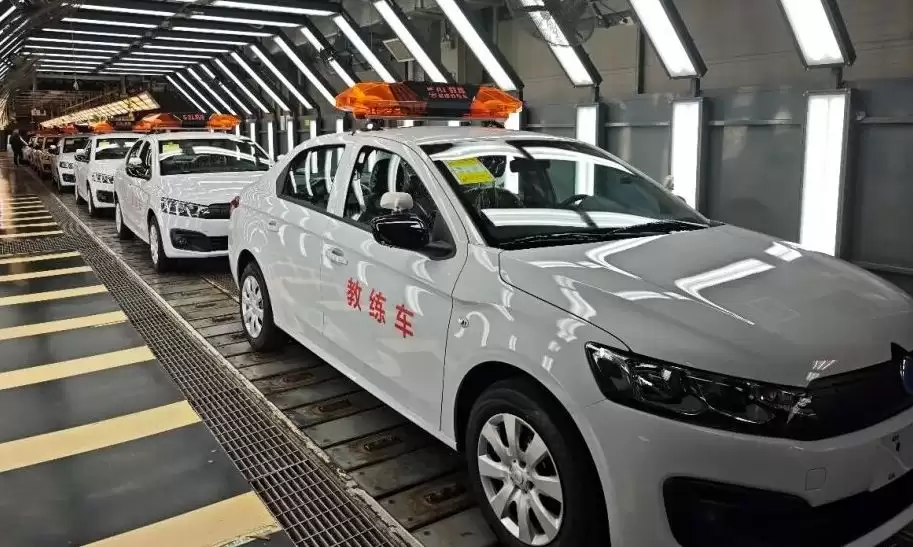
2026届高考生学车时多采用AI教练,逐步适应人机共驾。作为与生成式AI共同成长的一代,他们更易接受智能驾驶,未来可能成为首批“原生AI司机”。至2030年前后,其人生首辆车或具备L3级自动驾驶能力,驾驶角色将从操控者转向监督者。
全球股市因AI热潮呈现K型分化,半导体板块估值逼近百倍市盈率。历史警示:2000年互联网泡沫中的“四骑士”最终市值暴跌或长期盘整。投资者应警惕“错失恐惧症”,重视安全边际、护城河与能力圈,避免被高估值裹挟,关注稳健性与股息率。
Cloudflare报告显示,完成应用现代化的企业从AI投资中获得可衡量回报的概率是未现代化企业的三倍。93%的决策者视系统更新为AI先决条件,91%的领先企业已嵌入AI功能。安全与现代化协同推进可使AI成熟度提升四倍,精简技术架构成为竞争力分水岭。
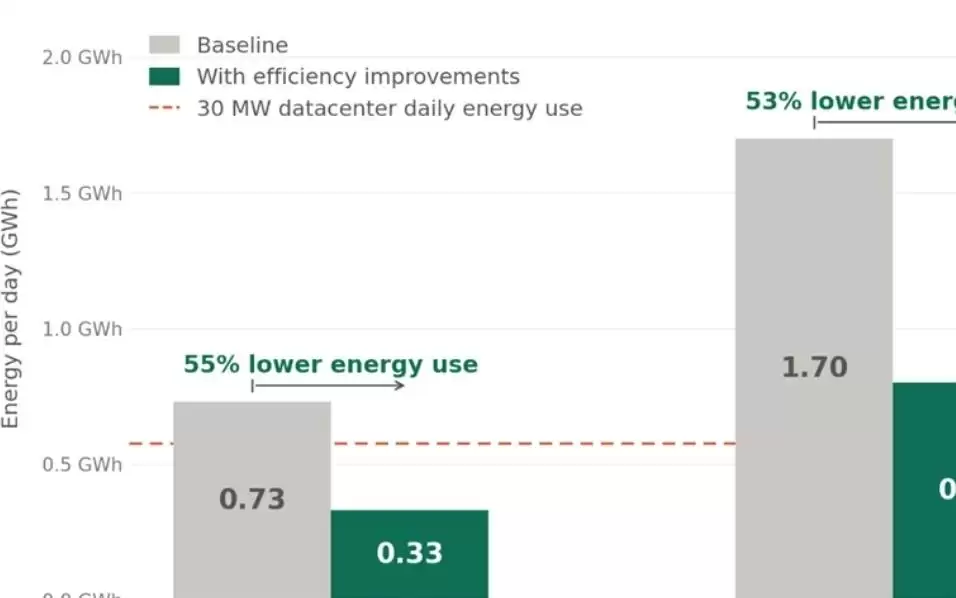
据微软引用《Joule》期刊的一项研究指出,每一次典型人工智能查询耗电量零点一六至零点六零瓦时,其冷却用水量中位数不足一滴水。大规模部署下,单位查询的效率会更高,总能耗可以降低一半以上。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



