

如何实现Python中的递归下降解析器?
1.算术运算表达式求值要解析这类文本,需要另外一种特定的语法规则。我们这里介绍可以表示上下文无关文法(contextfreegrammer)的语法规则巴科斯范式(BNF)和扩展巴科斯范式(EBNF)。实际上,小到一个算术运算表达式,大到几乎所有程序设计语言,都是通过上下文无关文法来定义的。对于简单的算术运算表达式,假定我们已经用分词技术将其转化为输入的tokens流,如NUM+NUM*NUM(分词方法参见上一篇博文)。在此基础上,我们定义BNF规则定义如下:expr::=expr+term|expr-te
1. 算术运算表达式求值
要解析这类文本,需要另外一种特定的语法规则。我们这里介绍可以表示上下文无关文法(context free grammer)的语法规则巴科斯范式(BNF)和扩展巴科斯范式(EBNF)。实际上,小到一个算术运算表达式,大到几乎所有程序设计语言,都是通过上下文无关文法来定义的。
对于简单的算术运算表达式,假定我们已经用分词技术将其转化为输入的tokens流,如NUM+NUM*NUM(分词方法参见上一篇博文)。
在此基础上,我们定义BNF规则定义如下:
expr ::= expr + term
     | expr - term
     | term
term ::= term * factor
     | term / factor
     | factor
factor ::= (expr)
     | NUM
当然,这种计法还不够简洁明了,我们实际采用的为EBNF形式:
expr ::= term { (+|-) term }*
term ::= factor { (*|/) factor }*
factor ::= (expr)
       | NUM
BNF和EBNF每一条规则(形如::=的式子)都可以看做是一种替换,即左侧的符号可以被右侧的符号所替换。而解析的过程中我们尝试将输入文本同语法规则做匹配,通过BNF/EBNF来完成各种替换和扩展。其中,EBNF中包含在{...}*中的规则是可选的,*意味着零个或多个重复项(参考正则表达式)。
下图形象地展示了递归下降解析器(parser)中“递归”和“下降”部分和ENBF的关系:
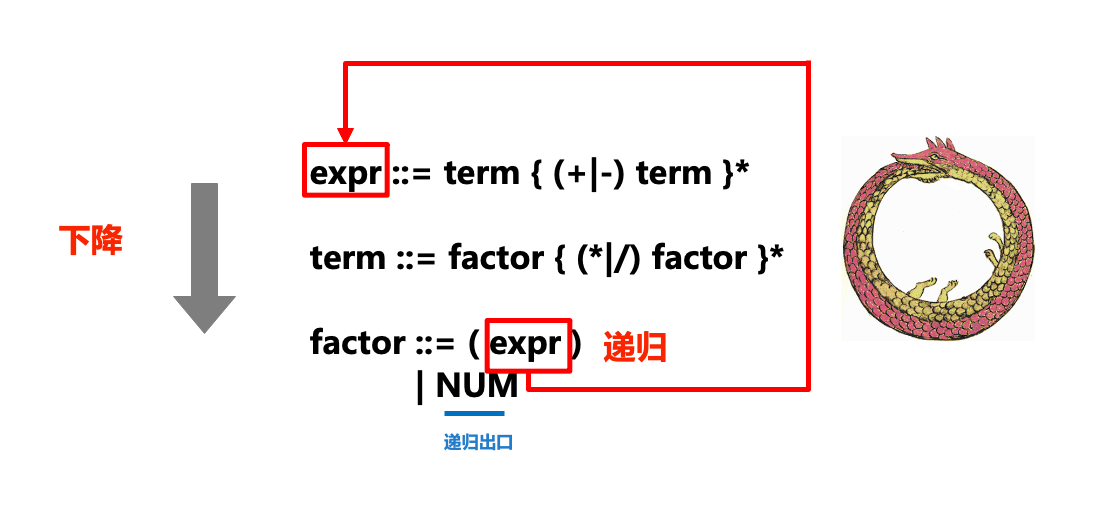
在实际的解析过程中,我们对tokens流从左到右进行扫描,在扫描的过程中处理token,如果卡住就产生一个语法错误。对于规则,我们将每一条语法规则转变为一个函数或方法,比如上面的ENBF规则就转换为下列的方法:
class ExpressionEvaluator():
    ...
    def expr(self):
        ...
    def term(self):
        ...
    def factor(self):
        ...
在调用某个规则对应方法的过程中,如果我们发现接下来的符号需要采用另一个规则来匹配,则我们就会“下降”到另一个规则方法(如在expr中调用term,term中调用factor),则也就是递归下降中“下降”的部分。
有时也会调用已经在执行的方法(比如在expr中调用term,term中调用factor后,又在factor中调用expr,相当于一条衔尾蛇),这也就是递归下降中“递归”的部分。
对于语法中出现的重复部分(例如expr ::= term { (+|-) term }*),我们则通过while循环来实现。
下面我们来看具体的代码实现。首先是分词部分,我们参照上一篇介绍分词博客的代码。
import re import collections # 定义匹配token的模式 NUM = r'(?P\d+)' # \d表示匹配数字,+表示任意长度 PLUS = r'(?P \+)' # 注意转义 MINUS = r'(?P -)' TIMES = r'(?P \*)' # 注意转义 DIVIDE = r'(?P /)' LPAREN = r'(?P \()' # 注意转义 RPAREN = r'(?P \))' # 注意转义 WS = r'(?P \s+)' # 别忘记空格,\s表示空格,+表示任意长度 master_pat = re.compile( '|'.join([NUM, PLUS, MINUS, TIMES, DIVIDE, LPAREN, RPAREN, WS])) # Tokenizer Token = collections.namedtuple('Token', ['type', 'value']) def generate_tokens(text): scanner = master_pat.scanner(text) for m in iter(scanner.match, None): tok = Token(m.lastgroup, m.group()) if tok.type != 'WS': # 过滤掉空格符 yield tok
下面是表达式求值器的具体实现:
class ExpressionEvaluator():
    """ 递归下降的Parser实现,每个语法规则都对应一个方法,
    使用 ._accept()方法来测试并接受当前处理的token,不匹配不报错,
    使用 ._except()方法来测试当前处理的token,并在不匹配的时候抛出语法错误
    """

    def parse(self, text):
        """ 对外调用的接口 """
        self.tokens = generate_tokens(text)
        self.tok, self.next_tok = None, None  # 已匹配的最后一个token,下一个即将匹配的token
        self._next()  # 转到下一个token
        return self.expr()  # 开始递归

    def _next(self):
        """ 转到下一个token """
        self.tok, self.next_tok = self.next_tok, next(self.tokens, None)

    def _accept(self, tok_type):
        """ 如果下一个token与tok_type匹配,则转到下一个token """
        if self.next_tok and self.next_tok.type == tok_type:
            self._next()
            return True
        else:
            return False

    def _except(self, tok_type):
        """ 检查是否匹配,如果不匹配则抛出异常 """
        if not self._accept(tok_type):
            raise SyntaxError("Excepted"+tok_type)

    # 接下来是语法规则,每个语法规则对应一个方法

    def expr(self):
        """ 对应规则: expression ::= term { ('+'|'-') term }* """
        exprval = self.term() # 取第一项
        while self._accept("PLUS") or self._accept("DIVIDE"): # 如果下一项是"+"或"-"
            op = self.tok.type
            # 再取下一项,即运算符右值
            right = self.term()
            if op == "PLUS":
                exprval += right
            elif op == "MINUS":
                exprval -= right
        return exprval

    def term(self):
        """ 对应规则: term ::= factor { ('*'|'/') factor }* """

        termval = self.factor() # 取第一项
        while self._accept("TIMES") or self._accept("DIVIDE"): # 如果下一项是"+"或"-"
            op = self.tok.type
            # 再取下一项,即运算符右值
            right = self.factor()
            if op == "TIMES":
                termval *= right
            elif op == "DIVIDE":
                termval /= right
        return termval


    def factor(self):
        """ 对应规则: factor ::= NUM | ( expr ) """
        if self._accept("NUM"): # 递归出口
            return int(self.tok.value)
        elif self._accept("LPAREN"):
            exprval = self.expr() # 继续递归下去求表达式值
            self._except("RPAREN") # 别忘记检查是否有右括号,没有则抛出异常
            return exprval
        else:
            raise SyntaxError("Expected NUMBER or LPAREN")
我们输入以下表达式进行测试:
e = ExpressionEvaluator()
print(e.parse("2"))
print(e.parse("2+3"))
print(e.parse("2+3*4"))
print(e.parse("2+(3+4)*5"))
求值结果如下:
2
5
14
37
如果我们输入的文本不符合语法规则:
print(e.parse("2 + (3 + * 4)"))则会抛出SyntaxError异常:Expected NUMBER or LPAREN。
综上,可见我们的表达式求值算法运行正确。
2. 生成表达式树
上面我们是得到表达式的结果,但是如果我们想分析表达式的结构,生成一棵简单的表达式解析树呢?那么我们需要对上述类的方法做一定修改:
class ExpressionTreeBuilder(ExpressionEvaluator):
    def expr(self):
            """ 对应规则: expression ::= term { ('+'|'-') term }* """
            exprval = self.term() # 取第一项
            while self._accept("PLUS") or self._accept("DIVIDE"): # 如果下一项是"+"或"-"
                op = self.tok.type
                # 再取下一项,即运算符右值
                right = self.term()
                if op == "PLUS":
                    exprval = ('+', exprval, right)
                elif op == "MINUS":
                    exprval -= ('-', exprval, right)
            return exprval

    def term(self):
        """ 对应规则: term ::= factor { ('*'|'/') factor }* """

        termval = self.factor() # 取第一项
        while self._accept("TIMES") or self._accept("DIVIDE"): # 如果下一项是"+"或"-"
            op = self.tok.type
            # 再取下一项,即运算符右值
            right = self.factor()
            if op == "TIMES":
                termval = ('*', termval, right)
            elif op == "DIVIDE":
                termval = ('/', termval, right)
        return termval

    def factor(self):
        """ 对应规则: factor ::= NUM | ( expr ) """
        if self._accept("NUM"): # 递归出口
            return int(self.tok.value) # 字符串转整形
        elif self._accept("LPAREN"):
            exprval = self.expr() # 继续递归下去求表达式值
            self._except("RPAREN") # 别忘记检查是否有右括号,没有则抛出异常
            return exprval
        else:
            raise SyntaxError("Expected NUMBER or LPAREN")
输入下列表达式测试一下:
print(e.parse("2+3"))
print(e.parse("2+3*4"))
print(e.parse("2+(3+4)*5"))
print(e.parse('2+3+4'))
以下是生成结果:
('+', 2, 3)
('+', 2, ('*', 3, 4))
('+', 2, ('*', ('+', 3, 4), 5))
('+', ('+', 2, 3), 4)
可以看到表达式树生成正确。
我们上面的这个例子非常简单,但递归下降的解析器也可以用来实现相当复杂的解析器,例如Python代码就是通过一个递归下降解析器解析的。您要是对此跟感兴趣可以检查Python源码中的Grammar文件来一探究竟。然而,下面我们接着会看到,自己动手写一个解析器会面对各种陷阱和挑战。
左递归和运算符优先级陷阱
任何涉及左递归形式的语法规则,都没法用递归下降parser来解决。所谓左递归,即规则式子右侧最左边的符号是规则头,比如对于以下规则:
items ::= items ',' item
      | item
完成该解析你可能会定义以下方法:
def items(self):
    itemsval = self.items() # 取第一项,然而此处会无穷递归!
    if itemsval and self._accept(','):
        itemsval.append(self.item())
    else:
itemsval = [self.item()]这样做会在第一行就无穷地调用self.items()从而产生无穷递归错误。
还有一种是语法规则自身的错误,比如运算符优先级。我们如果忽视运算符优先级直接将表达式简化如下:
expr ::= factor { ('+'|'-'|'*'|'/') factor }*
factor ::= '(' expr ')'
       | NUM
PYTHON 复制 全屏
这个语法从技术上可以实现,但是没有遵守计算顺序约定,导致"3+4*5"的运算结果为35,而不是预期的23。故此处需要用独立的expr和term规则来确保计算结果的正确性。

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



