

吞吐提升30倍:CV流水线走向全栈并行化
引言斯坦福教授、Tcl语言发明者JohnOusterhout曾写过一本书《软件设计的哲学》,系统讨论了软件设计的通用原则和方法论,整书的核心观点是:软件设计的核心在于降低复杂性。实际上,这个观点也适用于涉及底层硬件适配的软件设计。以视觉模型开发为例,以往视觉模型开发过程中,人们一般会更加关注模型本身的优化来提升速度与效果。而对于图像前处理(预处理)和后处理阶段,人们则很少关注。当模型计算即模型训练和推理主阶段的效率越来越高时,图像的前后处理阶段愈发成为图像处理任务的性能瓶颈。具体而言,在传统的
引言
斯坦福教授、Tcl 语言发明者 John Ousterhout 曾写过一本书《软件设计的哲学》,系统讨论了软件设计的通用原则和方法论,整书的核心观点是:软件设计的核心在于降低复杂性。
实际上,这个观点也适用于涉及底层硬件适配的软件设计。
以视觉模型开发为例,以往视觉模型开发过程中,人们一般会更加关注模型本身的优化来提升速度与效果。而对于图像前处理(预处理)和后处理阶段,人们则很少关注。
当模型计算即模型训练和推理主阶段的效率越来越高时,图像的前后处理阶段愈发成为图像处理任务的性能瓶颈。
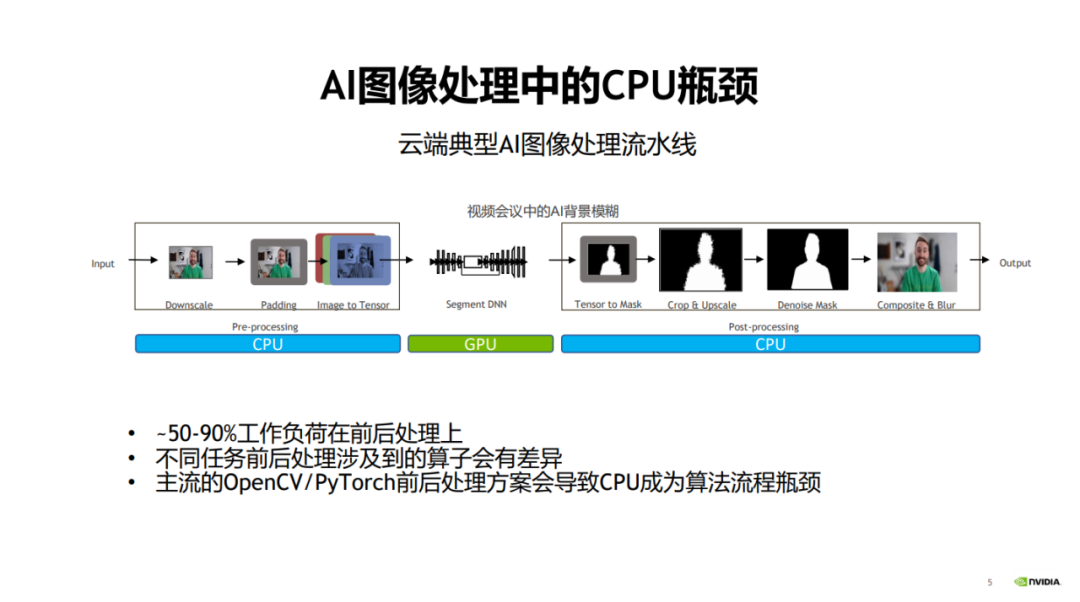
具体而言,在传统的图像处理流程中,前后处理部分通常都是用 CPU 进行操作的,这会导致整个流程中 50% 到 90% 以上的工作负荷都和前后处理相关,从而它们会成为整个算法流程的性能瓶颈。
一、主流CV库的局限性
上述问题是目前市面上的主流 CV 库在应用场景上的主要局限性,也就是说,对底层硬件依赖的不一致性导致了复杂性和性能瓶颈。正如 John Ousterhout 总结复杂性原因时所道:复杂性源于依赖性。
主流的图像处理库 OpenCV,其应用场景非常广泛,但在实际使用的时候也会面临一些问题。
比如用 OpenCV 的 CPU 版本先做训练再做推理的时候,在推理阶段可能需要一个性能比较高的版本。
因为在训练场景里,前后处理与模型推理可以在时间上进行覆盖,从而覆盖前处理的时间。但推理流水线中,模型只包含前向推理,且经过 Tensor RT 加速后耗时急剧减小,这时前处理的耗时占比会非常高,难以被模型推理所覆盖。
要想减少推理场景的耗时,提高推理场景的性能,一般会用 OpenCV 的 GPU 版本进行加速。
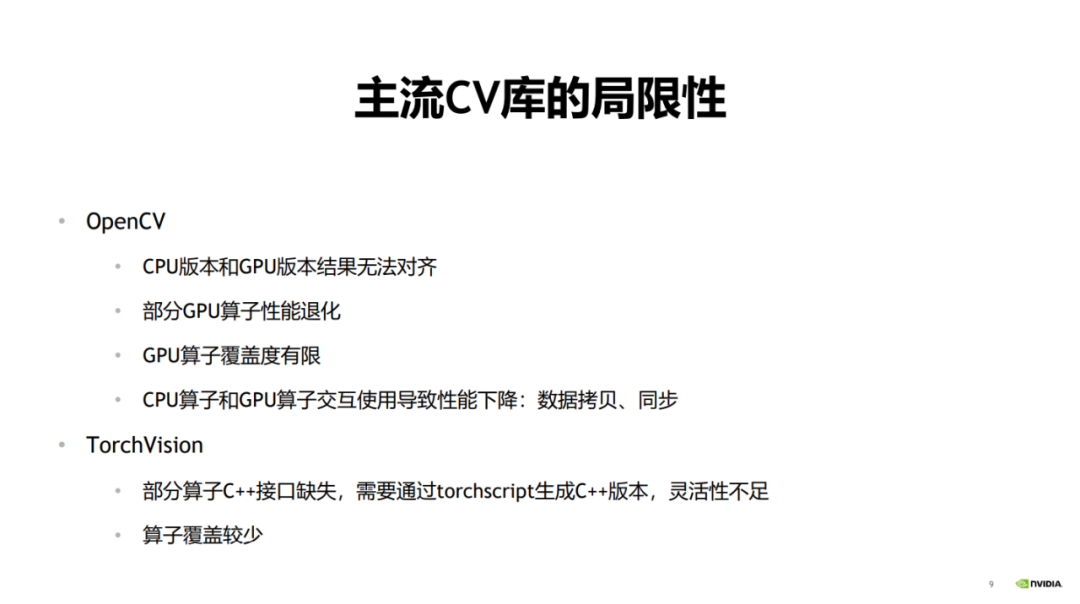
但是 OpenCV 的 CPU 版本和 GPU 版本之间可能会出现结果不一致的情况。典型的例子是 resize 算子,其在 CPU 版本和 GPU 版本上对于差值的计算方式是不一致的。
OpenCV 在训练和推理的时候会使用不同版本的算子,在训练的时候一般用 CPU,因为其 CPU 算子覆盖度比较高,在推理的时候一般用 GPU,因为性能比较好。因此,这也会导致结果对齐的问题。也就是说,当用 CPU 做模型训练,并用 GPU 做模型推理的时候,会导致最终的输出结果无法对齐。
其次,部分 GPU 算子的性能会有所退化。在 OpenCV 中,部分 GPU 算子本身的耗时比较大,从而导致整个算子的性能回退,甚至差于 CPU 版本。
第三,OpenCV 的 GPU 算子覆盖度是有限的,部分算子只有 CPU 版本。还有一些 GPU 算子在参数、数据类型等方面的覆盖度也没有 CPU 版本高,从而带来使用上的限制。
最后,如果在使用中将 CPU 算子和 GPU 算子交互使用,就会带来大量的 CPU 和 GPU 之间的数据拷贝和同步操作,进而导致整体的加速性能不够高。
另外一个常用的图像处理库是 TorchVision。
TorchVision 在做模型推理的时候,有些算子缺乏 C++ 接口,从而在调用的时候缺乏灵活性。如果要生成 C++ 版本,必须通过 TorchScript 生成。这会导致使用上的许多不便,因为在流程中间插入其它库的算子来交互使用会带来额外开销和工作量。TorchVision 还有一个缺点是算子的覆盖度不高。
以上就是目前的主流 CV 库的局限性。
二、统一 CV 流水线
既然前后处理的性能瓶颈主要在于使用 CPU 计算,而模型计算阶段使用 GPU 的技术已经越来越成熟。
那么,一个很自然的解决方案是,用 GPU 对前后处理进行加速,对整个算法流水线将会有非常大的性能提升。
为此,NVIDIA英伟达携手字节跳动开源了图像预处理算子库 CV-CUDA。CV-CUDA 能高效地在 GPU 上运行,算子速度能达到 OpenCV 的百倍左右。
2023 年 1 月 15 日,9:30-11:30,由 NVIDIA英伟达 主办的『CV-CUDA 首次公开课』,邀请了来自 NVIDIA英伟达、字节跳动、新浪微博的 3 位技术专家(张毅、盛一耀、庞锋),就相关主题进行深度分享,本文汇总了三位专家的演讲精华。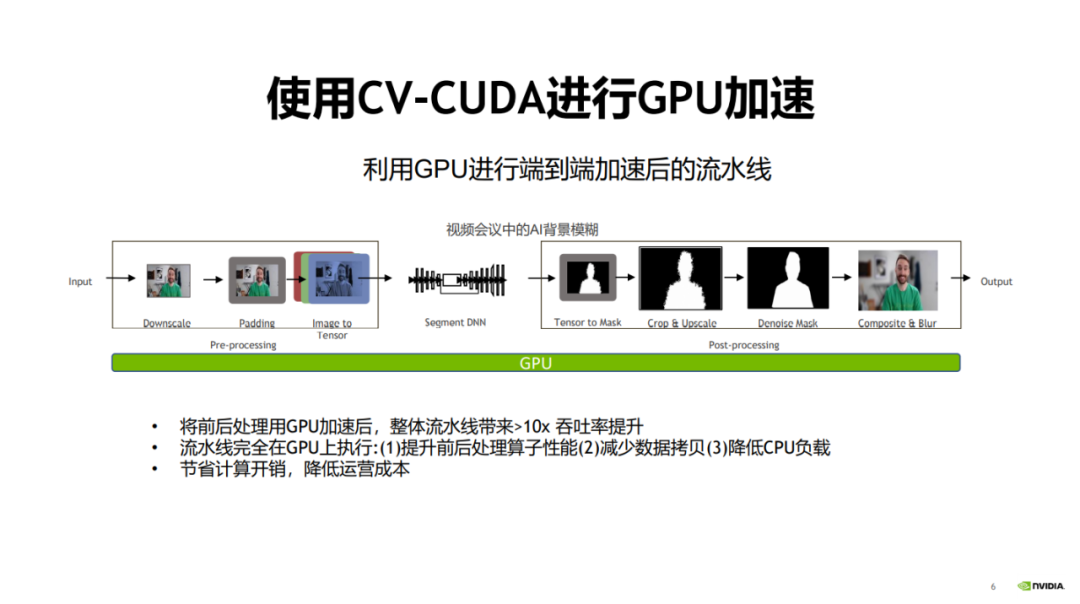
采用 GPU 替换 CPU 有很多好处。首先,前后处理的算子迁移到 GPU 上以后,可以提高算子的计算效率。
其次,由于所有的流程都是在 GPU 上进行的,可以减少 CPU 和 GPU 之间的数据拷贝。
最后,把 CPU 的负载迁移到 GPU 上后,可以降低 CPU 的负载,将 CPU 用于处理其它需要很复杂逻辑的任务。
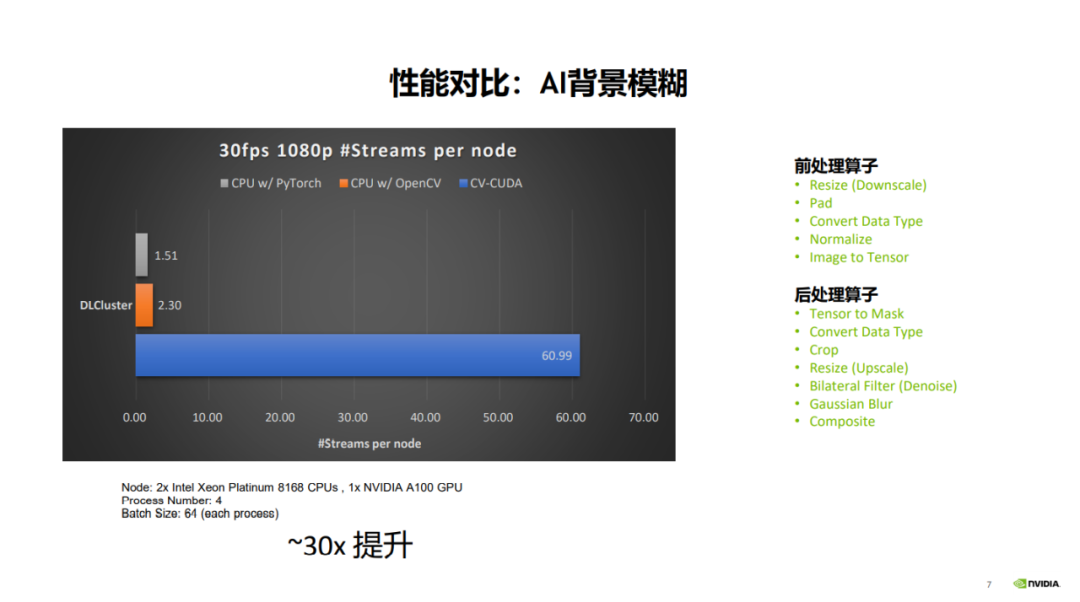
将整个流程迁移到 GPU 上后,对于整个流水线可以带来近 30 倍的提升,从而节省计算开销,降低运营成本。
通过图中数据对比可以看到,在相同的服务器和参数配置下,对于 30fps 1080p 视频流,OpenCV 最多可以开 2-3 个并行流,PyTorch(CPU)最多可以开 1.5 个并行流,而 CV-CUDA 最多可以开 60 个并行流。可以看出整体性能提升程度非常大,涉及到的前处理算子有 resize、padding、normalize 等,后处理算子有 crop、resize、compose 等。
三、异步化
为什么 GPU 可以适配前后处理的加速需求?得益于模型计算与前后处理之间的异步化,并与 GPU 的并行计算能力相适应。
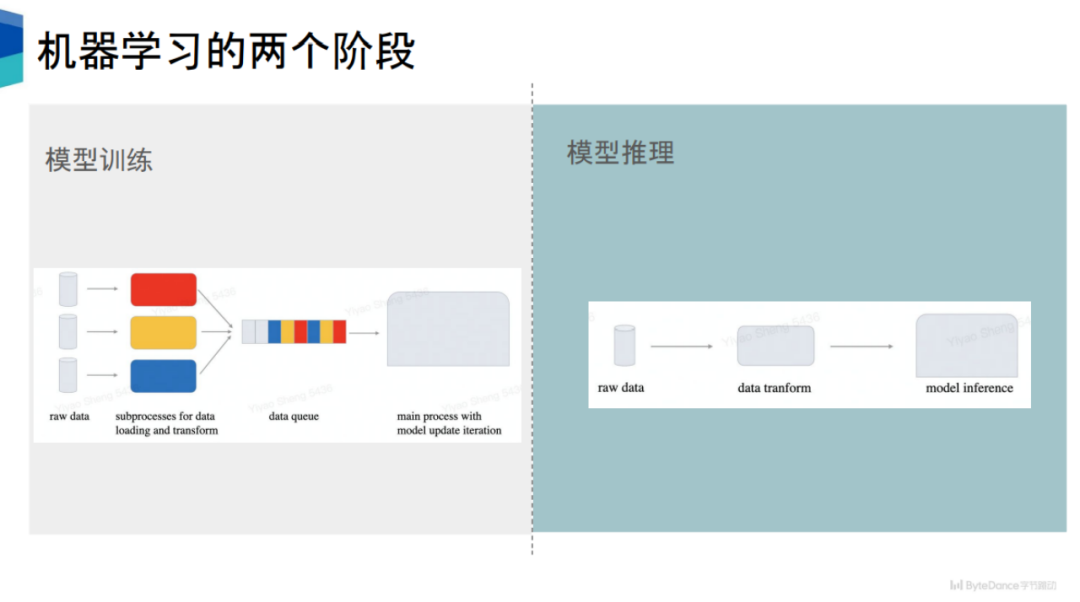
我们以模型训练和模型推理的预处理异步化分别进行说明。
1、模型训练的预处理异步化
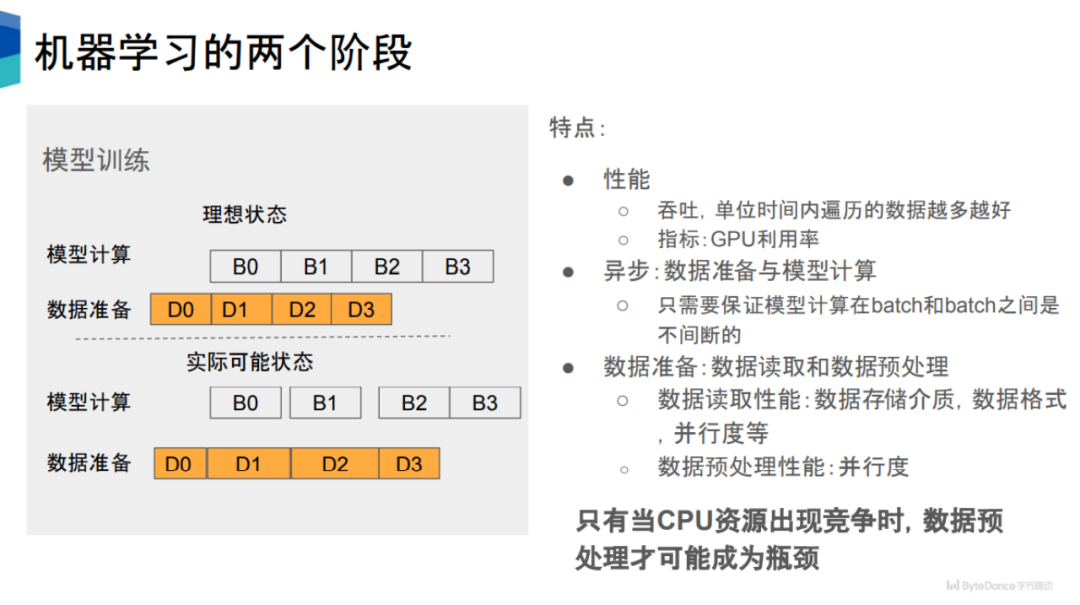
模型训练可以分为两部分,第一个是数据准备,第二个是模型计算。
目前主流的机器学习框架,比如 PyTorch、TensorFlow,它们在数据准备和模型计算之间是异步的。以 PyTorch 为例,其会开启多个子进程进行数据的准备。
如图中所示,其包含两个状态,即模型计算和数据准备,两者存在时间先后关系,比如当 D0 完成之后,就可以进行 B0,以此类推。
从性能角度看,我们期望数据准备的速度能够跟得上模型计算的速度。但实际情况中,一些数据读取和数据预处理过程的耗时很长,导致相应的模型计算在进行前有一定的空窗期,从而导致 GPU 利用率下降。
数据准备可以分成数据读取和数据预处理,这两个阶段可以串行执行,也可以并行执行,比如在 PyTorch 的框架下是串行执行的。
影响数据读取的性能因素有很多,比如数据存储介质、存储格式、并行度、执行进程数等。
相比之下,数据预处理的性能影响因素比较简单,就是并行度。并行度越高,数据预处理的性能越好。也就是说,让数据预处理与模型计算异步化,并提高数据预处理的并行度,可以提高数据预处理的性能。
2、模型推理的预处理异步化
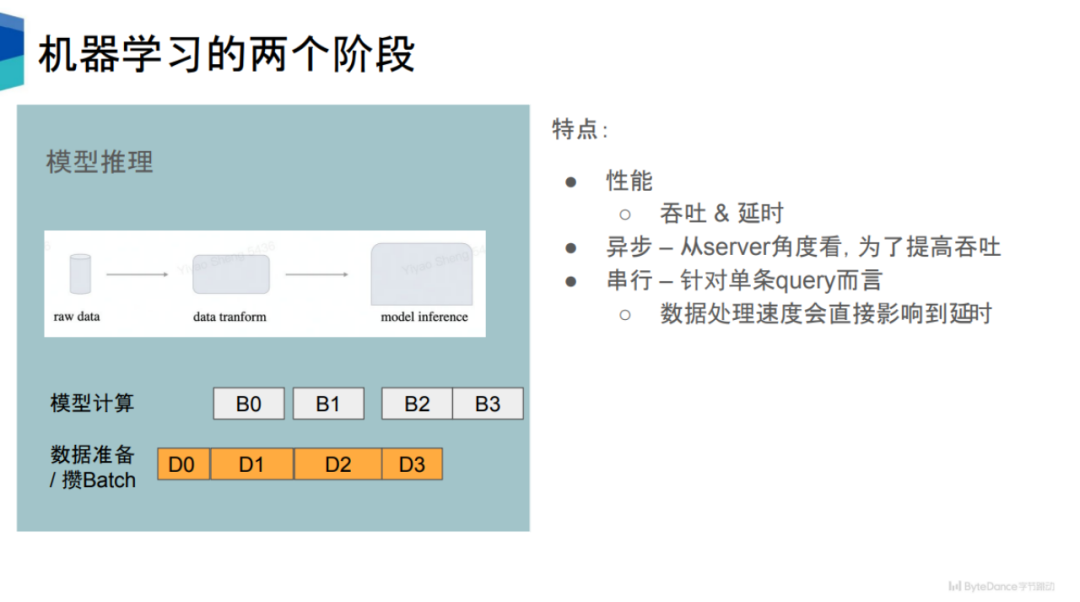
在模型推理阶段,其性能有两个指标,第一个是吞吐,第二个是延时。一定程度上,这两个指标是彼此互斥的。
对于单个 query 而言,当 server 接收到数据之后,会进行数据的预处理,再进行模型推理。所以对于单个 query 而言,一定程度上它是一个串行的过程。
但这样做在效率上是很低的,会浪费很多计算资源。为了提高吞吐量,很多推理引擎会采用和训练阶段一样的策略,将数据准备和模型计算异步化。在数据准备阶段,会积累一定量的 query,组合成一个 batch,再进行后续的计算,以提高整体的吞吐量。
从吞吐而言,模型推理和模型训练是比较类似的。把数据预处理阶段从 CPU 搬到 GPU 上,可以得到吞吐上的收益。
同时,从延时的角度上看,对于每条 query 语句,如果能够减少预处理过程所花费的时间,对于每条 query 而言,其延时也会得到相应的缩短。
模型推理还有一个特点是,其模型计算量比较小,因为只涉及前向计算,不涉及后向计算。这意味着模型推理对数据预处理的需求更高。
3、核心问题:CPU 资源竞争
假设有足够的 CPU 资源用于计算,理论上预处理不会成为性能瓶颈。因为一旦发现性能跟不上,只需要增加进程做预处理操作即可。
因此,只有当 CPU 出现资源竞争的时候,数据预处理才可能成为性能瓶颈。
在实际业务中,CPU 资源竞争的情况是很常见的,这会导致后续训练和推理阶段中 GPU 利用率降低,进而训练速度降低。
随着 GPU 算力不断增加,可以预见,对数据准备阶段的速度要求会越来越高。
为此,将预处理部分搬上 GPU,来缓解 CPU 资源竞争问题,提高 GPU 利用率,就成了很自然的选择。
总体而言,这种设计降低了系统的复杂性,将模型流水线的主体与 GPU 直接适配,对于提高 GPU 和 CPU 的利用率都能带来很大的助益。同时,它也避免了不同版本之间的结果对齐问题,减少了依赖性,符合 John Ousterhout 提出的软件设计原则。
四、 CV-CUDA
把预处理以及后处理过程搬上 GPU 需要满足多个条件。
第一是其性能至少要好于 CPU。这主要基于 GPU 的高并发计算能力。
第二是对预处理的加速,不能造成对其它流程比如模型推理的负面影响。对于第二个需求,CV-CUDA 的每个算子都留有 stream 和 CUDA 显存的接口,从而可以更合理地配置GPU的资源,使得在 GPU 上运行这些预处理算子的时候,不会过于影响到模型计算本身。
第三,互联网企业中有非常多样的业务需求,涉及的模型种类很多,相应的预处理逻辑也是种类繁多,因此预处理算子需要开发成定制化的,从而有更大的灵活性来实现复杂的逻辑。
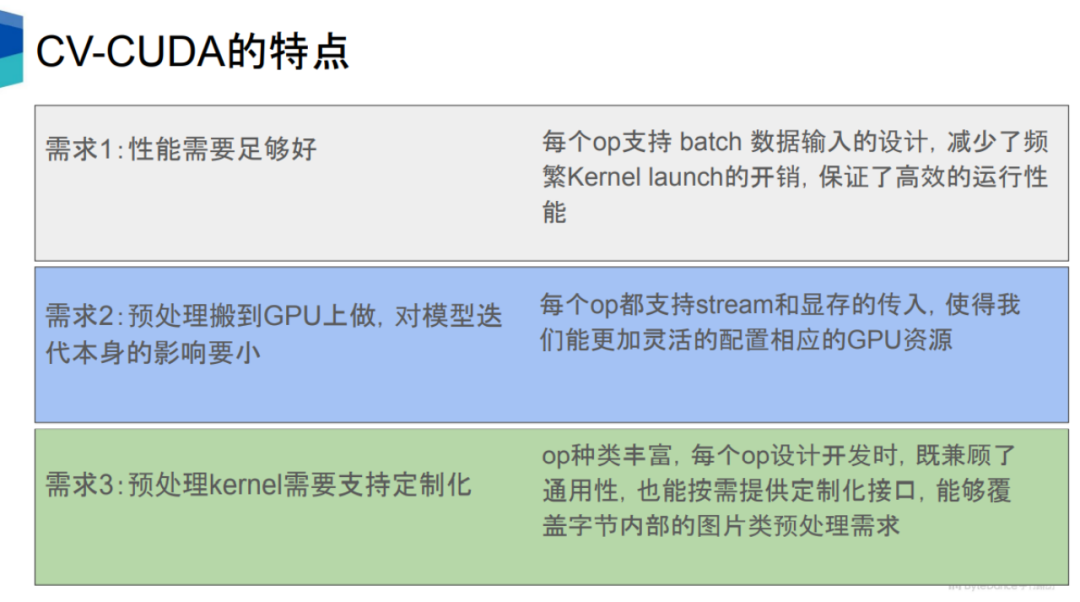
总体而言,CV-CUDA 从硬件、软件、算法、语言等方面对模型流水线中的前后处理阶段进行了加速,以及整个流水线的统一。
1、硬件
硬件方面,CV-CUDA 基于 GPU 的并行计算能力,能够大幅提高前后处理的速度和吞吐,减少模型计算的等待时间,提高 GPU 的利用率。
CV-CUDA 支持 Batch 和 Variable Shape 模式。Batch模式支持批处理,可以充分发挥 GPU 的并行特性,而 OpenCV 不管是 CPU 还是 GPU 版本都只能对单张图片进行调用。
Variable Shape 模式是指在一个batch当中,每张图片的长和宽可以不一样。网络上的图片一般长宽都是不一致的,主流框架的做法是把长和宽分别 resize 到同一个大小,再对同一长宽的图片打包为一个 batch,再对 batch 进行处理。CV-CUDA 可以直接把不同长和宽的图像直接放在一个 batch 中进行处理,不仅能提升效率,使用上也很方便。
Variable Shape 的另外一层含义是在对图像进行处理的时候,可以指定每张图片的某些参数,比如 rotate,对一个batch的图像可以指定每张图片的旋转角度。
2、软件
软件方面,CV-CUDA 开发了大量的软件优化方法来做进一步的优化,包括性能优化(比如访存优化)和资源利用优化(比如显存预分配),从而可以高效地运行在云端的训练和推理场景中。
首先是显存预分配设置。OpenCV在 调用 GPU 版本的时候,部分算子会在内部执行 cudaMalloc,这会导致耗时大量增加。在 CV-CUDA 中,所有的显存预分配都是在初始化阶段执行,而在训练和推理阶段,不会进行任何显存分配操作,从而提高效率。
其次,所有的算子都是异步操作的。CV-CUDA 对大量kernel进行了融合,从而减少 kernel 的数量,进而减少 kernel 的启动时间以及数据拷贝擦做,提高整体运行的效率。
第三,CV-CUDA 还对访存进行了优化,比如合并访存、向量化读写等,提高带宽的利用率,还利用 shared memory 来提高访存读写效率。
最后,CV-CUDA 在计算上也做了很多优化,比如 fast math、warp reduce/block reduce 等。
3、算法
算法方面,CV-CUDA 的算子都是独立设计的、定制化的,从而可以支持非常复杂的逻辑实现,并且方便进行使用和调试。
如何理解独立设计?图像处理库的算子调用有两种形式,一种是整体性的 pipeline 形式,只能获取 pipeline 的结果,比如 DALI,另一种是模块化的独立算子的形式,可以获取每一个算子的单独结果,比如 OpenCV。CV-CUDA 采用了和 OpenCV 相同的调用形式,在使用和调试上会比较方便。
4、语言
语言方面,CV-CUDA 支持丰富的 API,可以无缝将前后处理衔接训练和推理场景。
这些API包括常用的 C、C++、Python 的接口等,这使得我们可以同时支持训练和推理场景,它还支持 PyTorch、TensorRT 的接口,在未来,CV-CUDA 还将支持 Triton、TensorFlow、JAX 等接口。
推理阶段,可以直接用 Python 或 C++ 的接口进行推理,只要保证推理的时候将前后处理、模型、GPU 放在一个 stream 上即可。
五、应用案例
通过展示 CV-CUDA 在 NVIDIA 英伟达、字节跳动、新浪微博的应用案例,我们可以体会到 CV-CUDA 带来的性能提升有多显著。
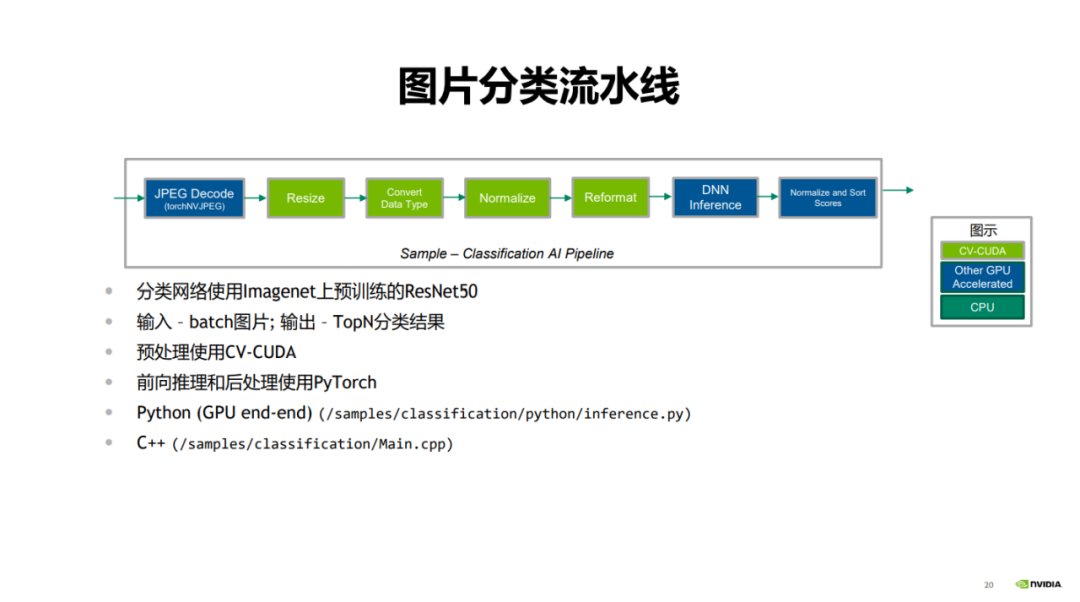
首先是 NVIDIA英伟达展示的图片分类案例。
在图片分类的流水线中,首先是 JPEG decode,其对图片进行解码;绿色部分是前处理步骤,包含 resize、convert data type、normalize 和 reformat;蓝色部分是使用 PyTorch 的前向推理过程,最后对分类的结果进行打分和排序。
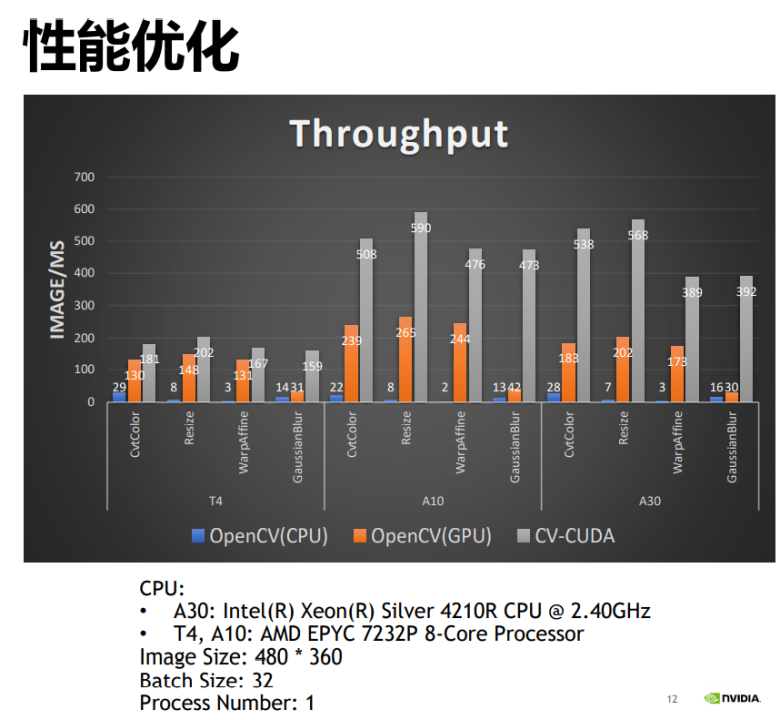
将 CV-CUDA 与 OpenCV 的 CPU 版本与 GPU 版本进行性能对比可以发现,OpenCV 的 GPU 版本相比于 CPU 版本能得到较大的性能提升,而通过应用 CV-CUDA,又能将性能翻倍。比如 OpenCV 的 CPU 算子每毫秒处理的图片数是 22 张,GPU 算子每毫秒处理的图片数是 200 多张,CV-CUDA 则每毫秒可以处理 500 多张图片,其吞吐量是 OpenCV 的 CPU 版本的 20 多倍,是 GPU 版本的两倍,性能提升很明显。
其次是字节跳动展示的 OCR1、OCR2、视频多模态三个案例。
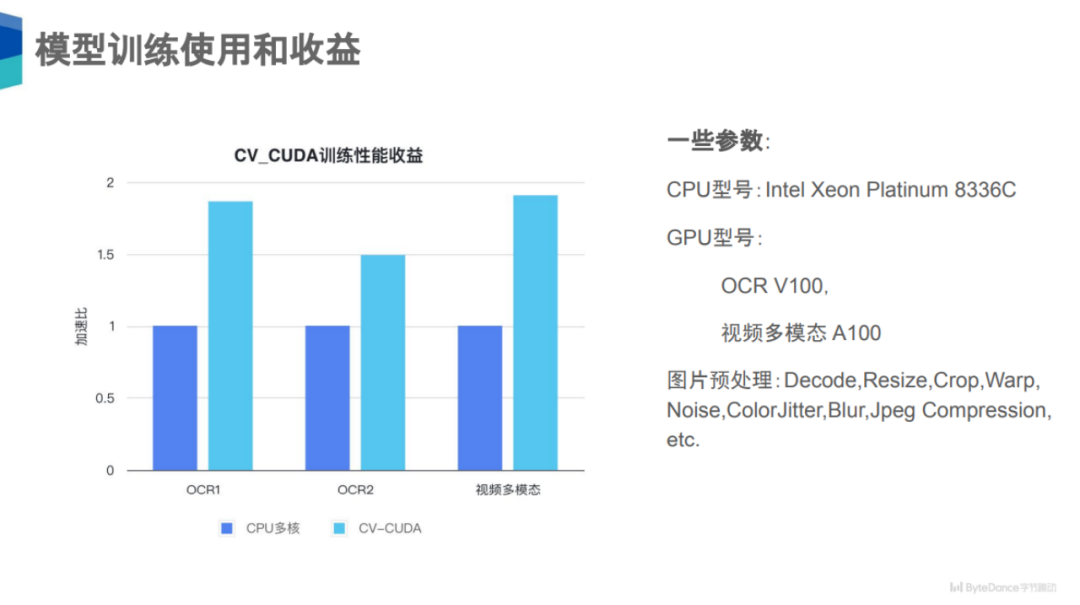
在模型训练上,可以看到在 OCR1、OCR2、视频多模态三个任务上,使用了 CV-CUDA 后获得了 50% 到 100% 的性能收益。
为什么有这么大的性能收益?实际上这三个任务比较大的一个共同点是,它们的图片预处理逻辑非常复杂,比如 decode、resize、crop 等,而且这些还是大类,实际上每个算子类中还可能有很多小类或子类预处理。对于这三个任务而言,其涉及到预处理链路上的数据增强种类可能就有十几种,所以其对于 CPU 的计算压力非常大,如果能把这部分计算搬到 GPU上,CPU 的资源竞争就会明显下降,整体吞吐也能提高很多。
最后是新浪微博展示的视频处理案例。
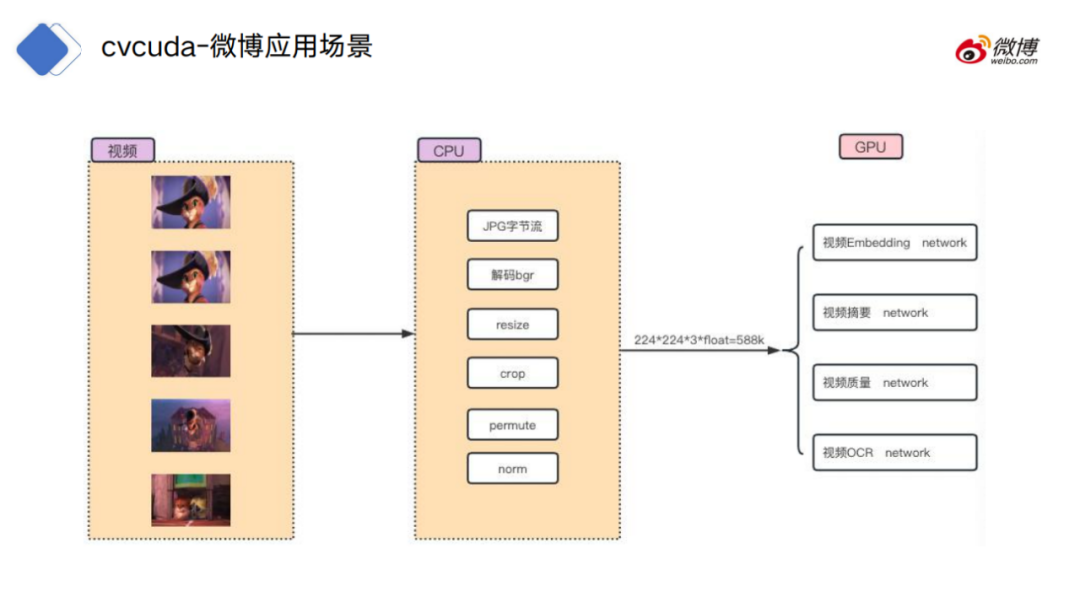
对于视频处理流程,传统的做法是把视频帧先在 CPU 环境中解码,把原始的字节流解码成图片数据,再做一些常规操作,比如 resize、crop 等,再把数据上传到 GPU 上做具体的模型计算。
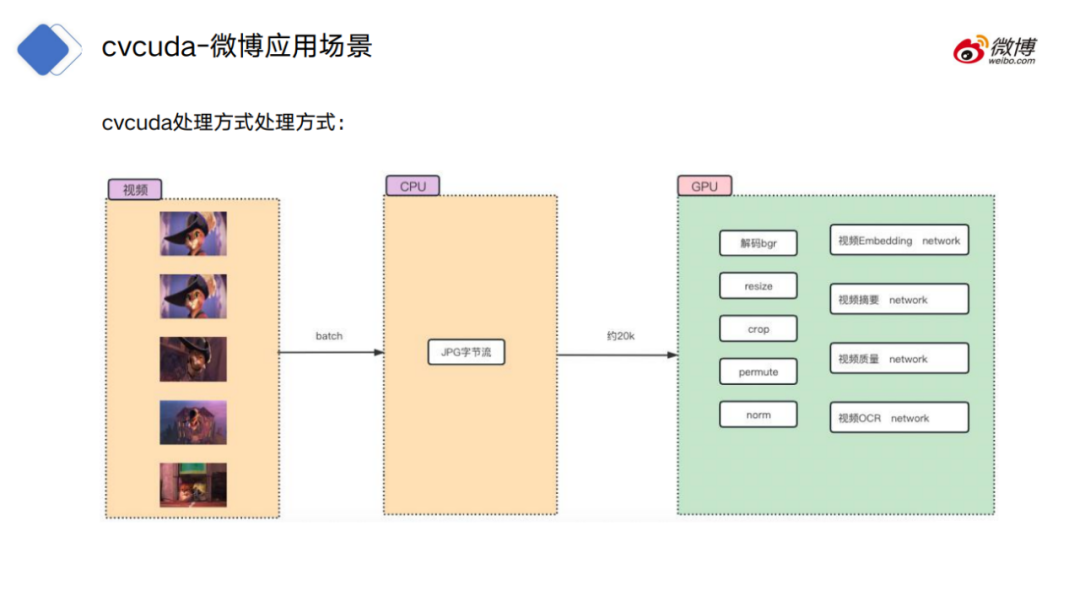
而 CV-CUDA 的处理方式是将 CPU 解码之后放在内存中的字节流上传到 GPU 上,并且预处理也位于 GPU 上,从而跟模型计算进行无缝衔接,不需要从显存和内存之间的拷贝操作。
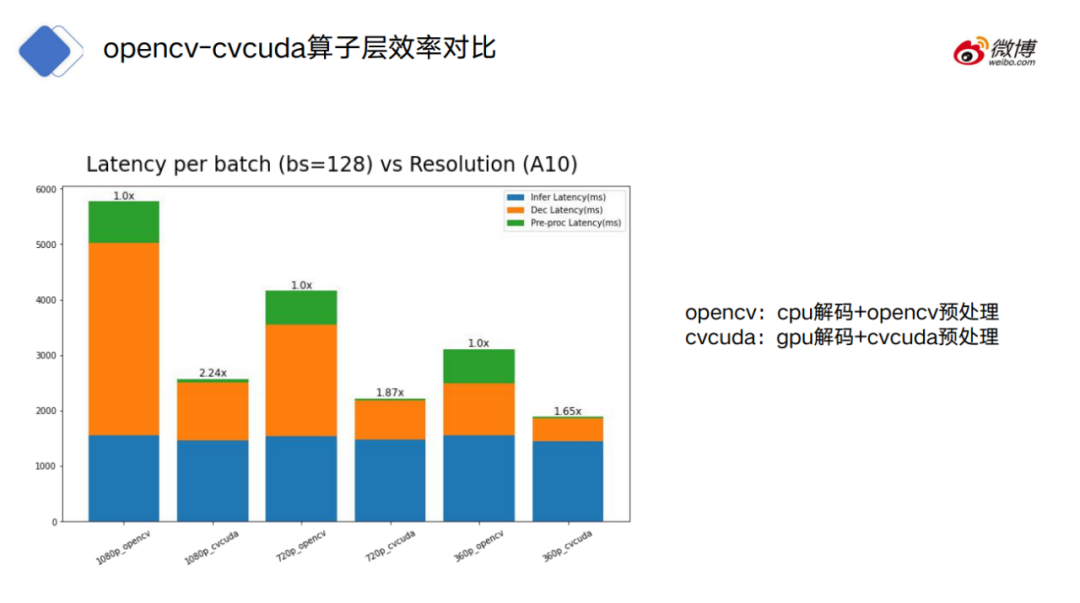
图中给出了采用 OpenCV(奇数)和 CV-CUDA(偶数)各自的处理时间,蓝色指的是模型的消耗时间,橙色指的是解码的消耗时间,绿色指的是预处理的消耗时间。
OpenCV 可以分为 CPU 解码和 GPU 解码两种模式,CV-CUDA 只采用 GPU 解码模式。
可以看到,对于 CPU 解码的 OpenCV,OpenCV 的解码和预处理都比 CV-CUDA 的耗时高得多。
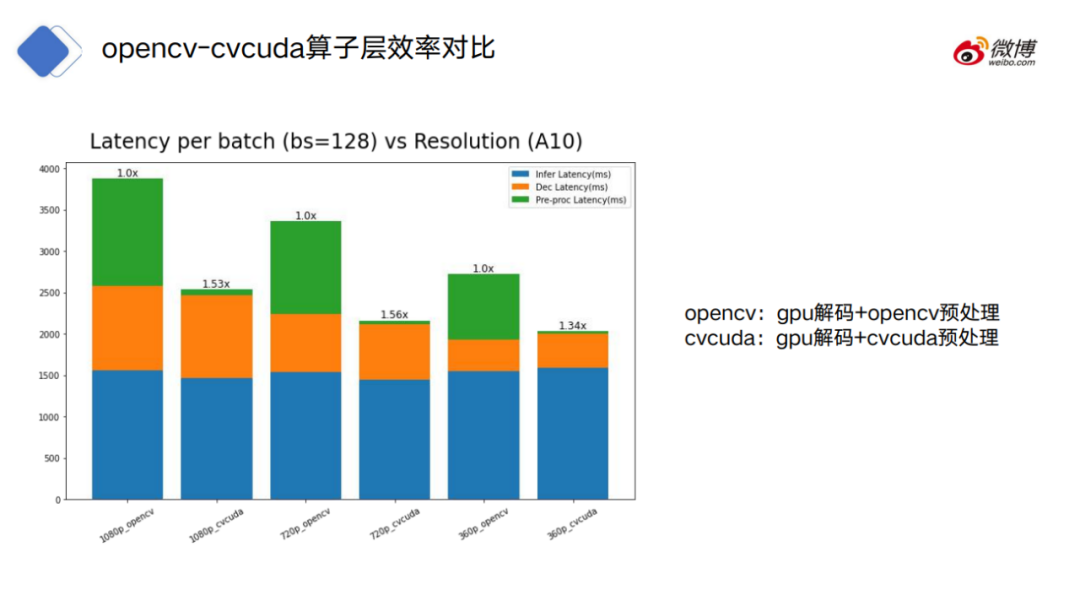
再看 OpenCV 采用 GPU 解码的情况,可以看到,OpenCV 和 CV-CUDA 在模型和解码部分的耗时是接近的,而预处理方面仍然差距很大。
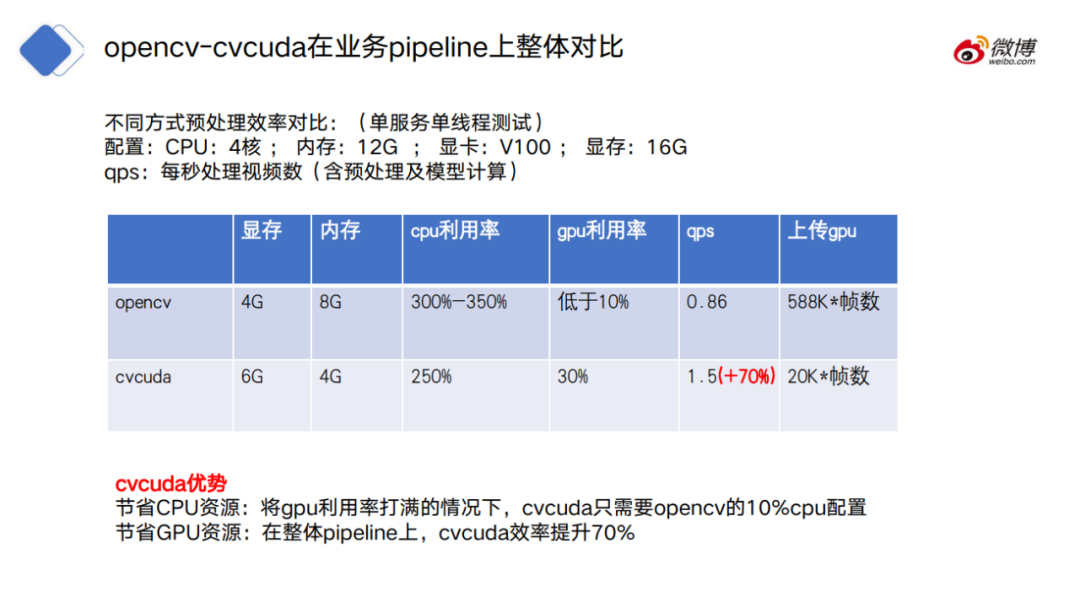
在 pipeline 整体对比上,CV-CUDA 也有很明显的优势,一方面 CV-CUDA 更节省 CPU 资源,也就是将 GPU 利用率打满的情况下,CV-CUDA 只需要 OpenCV 的 10%CPU 配置;同时,CV-CUDA 也更节省 GPU 资源,在整体 pipeline 上,CV-CUDA 效率提升70%。
六、未来展望
CV-CUDA 在模型训练和推理阶段都能有效地解决 CPU 资源竞争的问题,从而能够提高模型训练和推理的效率。
但如何正确理解 CV-CUDA 的优势?需要理解其发挥作用的根本前提,并且其优势相对于 CPU、OpenCV 并不是绝对的。
首先, CV-CUDA 实际上也不是万灵药。比如在模型训练阶段,如果瓶颈不是在预处理上,而是在数据读取、模型推理上。这时候,如果用 CV-CUDA 来替换原来的预处理方案,实际上也是没有任何用处的。
此外,在使用 CV-CUDA 的过程中,如果对预处理逻辑合理分配 CPU 和 GPU 的工作量,实际上有时候能够达到更好的性能效果。
比如,CPU 仍然可以进行图片解码和 resize,resize 之后再放到 GPU 上进行处理。
为什么把解码和 resize 放到 CPU 上做?首先,对于图片解码而言,其实 GPU 的硬解码单元是有限的。其次,对于 resize 而言,通常情况下,resize 都会把一张较大的图片,转换成一张较小的图片。
如果在 resize 之前,把数据拷贝到 GPU 上,可能会占用很多的显存数据搬运的带宽。
当然,CPU 和 GPU 之间的工作量具体怎么分配,还是需要结合实际情况来判断的。
而最重要的原则是,不要将 CPU 和 GPU 之间的计算交替穿插进行,因为跨 device 传输数据都是有开销的。如果交替过于频繁,反而可能将计算本身带来的收益抹平,进而导致性能不增反降。
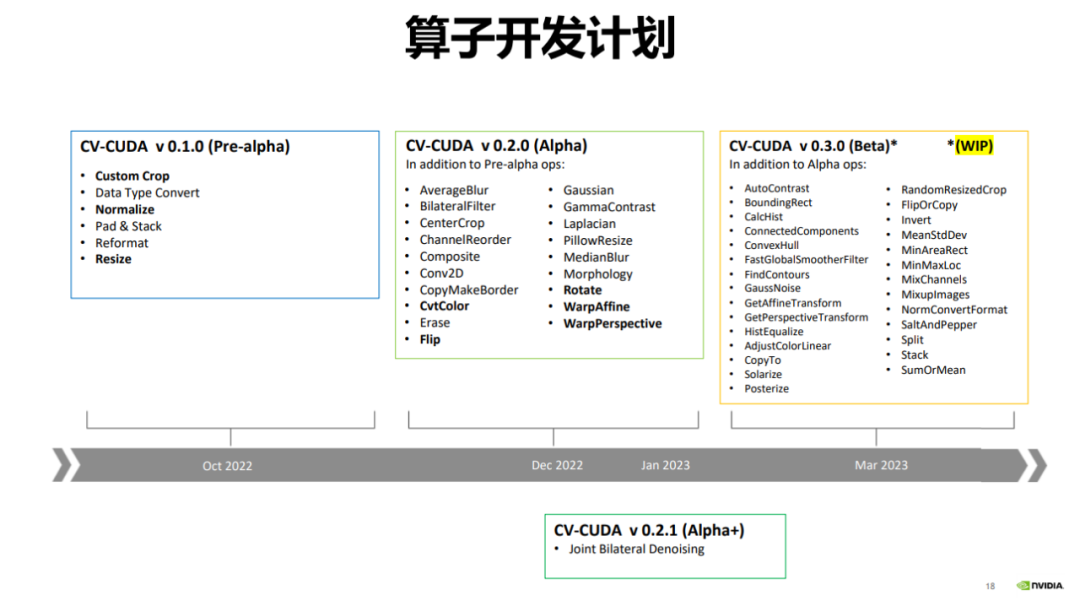
2022 年 12 月,CV-CUDA 发布了 alpha 版本,其中包含 20 多个算子,比如常用的 Flip、Rotate、Perspective、Resize 等。
目前 OpenCV 的算子更多,有数千个算子,CV-CUDA 目前只对比较常用的算子进行加速,后续会不断增加新的算子。
今年 3 月 CV-CUDA 还会发布 beta 版本,会增加 20 多的算子,达到 50 多个算子。beta 版本将包含一些非常用的算子,比如 ConvexHull、FindContours 等。
七、尾声
回过头来看 CV-CUDA 的设计方案,可以发现,其背后并没有太复杂的原理,甚至可以说一目了然。
从复杂性的角度,这可以说是 CV-CUDA 的优点。《软件设计的哲学》提过一个判断软件复杂性的原则——如果一个软件系统难以理解和修改,那就很复杂;如果很容易理解和修改,那就很简单。
可以将 CV-CUDA 的有效性理解为,模型计算阶段与 GPU 的适配性,带动了前后处理阶段与 GPU 的适配性。而这个趋势,其实才刚刚开始。
介绍如何使用Python进行高效的图片处理,涵盖批量添加水印、内容感知裁剪及主色调提取等实用案例,解析代码逻辑与适用场景,为开发者提供可落地的技术方案。
这项由普林斯顿大学计算机科学系团队主导的研究发表于2026年3月,论文编号为arXiv:2603.24836v1。有兴趣深入了解技术细节的读者,可以通过这个编号查询到完整论文。 一、魔法对齐技术:从复杂查表到巧妙变形 我们人类用双眼看世界时,大脑会自动对比左右眼的成像差异,瞬间判断出物体的距离和深度
Go语言在计算机视觉ML应用中优势显著:高性能、并发性、简洁性、跨平台性。实战案例中,Go与TensorFlow结合用于图像分类,通过图像加载、模型预测、结果后处理步骤实现预测类别打印。

随着计算机技术的不断发展,计算机视觉也跻身成为一种重要的新兴技术,它涉及到了图像处理、模式识别、机器学习等诸多方面的技术。结合计算机视觉的技术优势和云计算的优势,实现一个基于计算机视觉的云端视频监控系统成为了可能,而Java语言在开发云端应用方面具有显著的优势,本篇文章将介绍基于Java实现一个基于计算机视觉的云端视频监控系统的逻辑过程。一、环境准备1.计算
随着计算机技术的发展,计算机视觉已经成为一个重要的研究领域,其应用范围也越来越广泛。其中,人脸识别技术更是备受关注。本文将介绍如何在PHP中进行计算机视觉和人脸识别。1.计算机视觉概述计算机视觉是计算机科学和人工智能的重要分支之一,它致力于使计算机具备人类视觉的能力,从而能够“看懂”图像和视频等视觉信息。计算机视觉技术具有广泛的应用前景,例如图像搜索、自动驾
随着计算机技术的快速发展,计算机视觉这个领域也成为了越来越多Python程序员们关注的领域。本文将介绍如何使用Python和OpenCV框架构建一个计算机视觉服务器,实现一些基本的图像处理功能。安装OpenCV要使用OpenCV进行计算机视觉开发,首先需要在Python中安装OpenCV库。安装方式有很多种,这里介绍一种比较简单的方式:在命令行中输入以下命令
随着计算机视觉技术的不断发展,人体姿态估计已成为一个备受关注的研究方向。在本文中,将介绍如何使用Java编程语言实现一个基于计算机视觉的人体姿态估计应用程序,并且将详细介绍其中的逻辑过程。一、介绍人体姿态估计是指通过摄像头捕捉到的人体运动轨迹,对人体的姿态进行识别和分析的过程。在计算机视觉的领域中,人体姿态估计是一个非常有挑战的问题,因为人体姿态的变化非常复
随着计算机视觉技术的不断发展和应用,医学图像分析的领域也得到了大大的提升。Java作为一种多平台语言,在医学图像分析中也有广泛的应用。本文将介绍如何使用Java实现一个基于计算机视觉的医学图像分析应用程序的逻辑过程。一、医学图像的获取医学图像的获取一般分为两类:影像学检查和组织病理学检查。影像学检查包括X光、MRI、CT等成像技术。组织病理学检查则是对医学标
计算机视觉(ComputerVision)是人工智能领域的重要分支之一,它可以使计算机能够自动地感知和理解图像、视频等视觉信号,实现人机交互以及自动化控制等应用场景。OpenCV(OpenSourceComputerVisionLibrary)是一个流行的开源计算机视觉库,在计算机视觉、机器学习、深度学习等领域都有广泛的应用。本文将介绍在PHP中使
图像处理与分析python丰富的图像处理库和工具,使得其在图像处理与分析方面具有强大的功能。像Scikit-image、OpenCV和Pillow等库提供了各种图像处理和分析功能,如图像读写、图像格式转换、图像增强、图像分割、特征提取等。这些库使得Python能够轻松处理各种图像格式,并从图像中提取有价值的信息。演示代码:importnumpyasnpimportcv2#读取图像image=cv2.imread("image.jpg")#图像灰度化gray_image=cv2.cvtColor(image





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



