

多模态可控图片生成统一模型来了,模型参数、推理代码全部开源
论文地址:https://arxiv.org/abs/2305.11147代码地址:https://github.com/salesforce/UniControl项目主页:https://shorturl.at/lmMX6引言:StableDiffusion表现出了强大的视觉生成能力。然而,它们在生成具有空间、结构或几何控制的图像方面常常表现不足。ControlNet[1]和T2I-adpater[2]等工作实现针对不同模态的可控图片生成,但能够在单一统一的模型中适应各种视觉条件,仍然是一个未解决的挑战
- 论文地址:https://arxiv.org/abs/2305.11147
- 代码地址:https://github.com/salesforce/UniControl
- 项目主页:https://shorturl.at/lmMX6
引言:Stable Diffusion 表现出了强大的视觉生成能力。然而,它们在生成具有空间、结构或几何控制的图像方面常常表现不足。ControlNet [1] 和 T2I-adpater [2] 等工作实现针对不同模态的可控图片生成,但能够在单一统一的模型中适应各种视觉条件,仍然是一个未解决的挑战。UniControl 在单一的框架内合并了各种可控的条件到图像(C2I)任务。为了使 UniControl 有能力处理多样的视觉条件,作者引入了一个任务感知的 HyperNet 来调节下游的条件扩散模型,使其能够同时适应不同的 C2I 任务。UniControl 在九个不同的 C2I 任务上进行训练,展示了强大的视觉生成能力和 zero-shot 泛化能力。作者已开源模型参数和推理代码,数据集和训练代码也将尽快开源,欢迎大家交流使用。
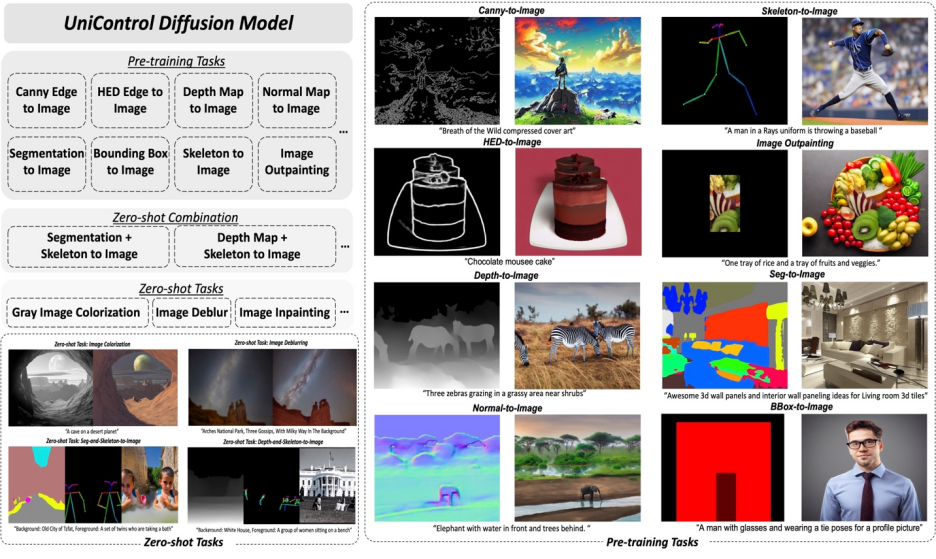
图 1: UniControl 模型由多个预训练任务和 zero-shot 任务组成
动机:现有的可控图片生成模型都是针对单一的模态进行设计,然而 Taskonomy [3] 等工作证明不同的视觉模态之间共享特征和信息,因此本文认为统一的多模态模型具有巨大的潜力。
解决:本文提出了 MOE-style Adapter 和 Task-aware HyperNet 来实现 UniControl 中的多模态条件生成能力。并且作者建立了一个新的数据集 MultiGen-20M,包含 9 大任务,超过两千万个 image-condition-prompt 三元组,图片尺寸≥512。
优点: 1) 更紧凑的模型 (1.4B #params, 5.78GB checkpoint),更少的参数实现多个 tasks。2) 更强大的视觉生成能力和控制的准确性。3) 在从未见过的模态上的 zero-shot 泛化能力。
1.介绍
生成式基础模型正在改变人工智能在自然语言处理、计算机视觉、音频处理和机器人控制等领域的交互方式。在自然语言处理中,像 InstructGPT 或 GPT-4 这样的生成式基础模型在各种任务上都表现优异,这种多任务处理能力是最吸引人的特性之一。此外,它们还可以进行 zero-shot 或 few-shot 的学习来处理未见过的任务。
然而,在视觉领域的生成模型中,这种多任务处理能力并不突出。虽然文本描述提供了一种灵活的方式来控制生成的图像的内容,但它们在提供像素级的空间、结构或几何控制方面往往不足。最近热门研究例如 ControlNet,T2I-adapter 可以增强 Stable Diffusion Model (SDM) 来实现精准的控制。然而,与可以由 CLIP 这样的统一模块处理的语言提示不同,每个 ControlNet 模型只能处理其训练过的特定模态。
为了克服先前工作的限制,本文提出了 UniControl,一个能同时处理语言和各种视觉条件的统一扩散模型。UniControl 的统一设计可以享受到提高训练和推理效率以及增强可控生成的优点。另一方面,UniControl 从不同视觉条件之间的固有联系中获益,来增强每个条件的生成效果。
UniControl 的统一可控生成能力依赖于两个部分,一个是 "MOE-style Adapter",另一个是 "Task-aware HyperNet"。MOE-style Adapter 有 70K 左右的参数,可以从各种模态中学习低级特征图,Task-aware HyperNet 可以将任务指令作为自然语言提示输入,并输出任务 embedding 嵌入下游的网络中,来调制下游模型的参数来适应不同模态的输入。
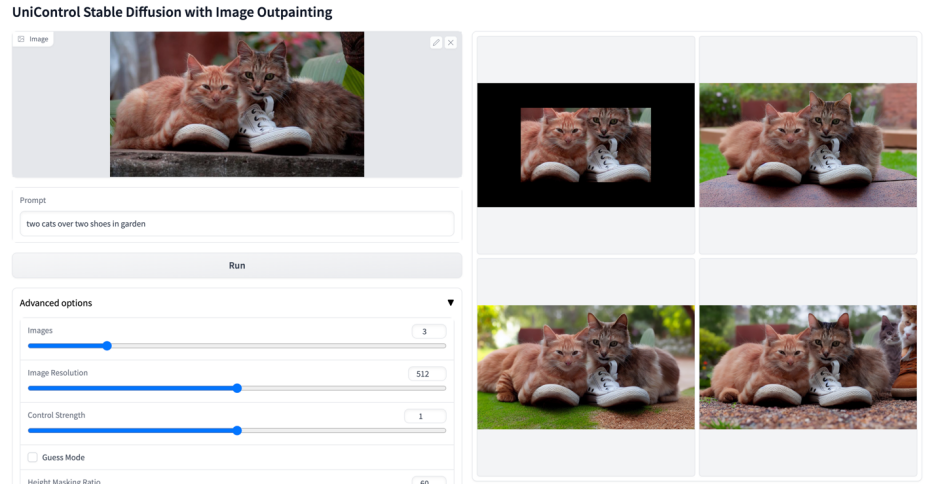
该研究对 UniControl 进行预训练,以获得多任务和 zero-shot 学习的能力,包括五个类别的九个不同任务:边缘 (Canny, HED, Sketch),区域映射 (Segmentation, Object Bound Box),骨架 (Human Skeleton),几何图 (Depth, Normal Surface) 和图片编辑 (Image Outpainting)。然后,该研究在 NVIDIA A100 硬件上训练 UniControl 超过 5000 个 GPU 小时 (当前新模型仍在继续训练)。并且 UniControl 展现出了对新任务的 zero-shot 适应能力。
该研究的贡献可以概括如下:
- 该研究提出了 UniControl,一个能处理各种视觉条件的统一模型 (1.4B #params, 5.78GB checkpoint),用于可控的视觉生成。
- 该研究收集了一个新的多条件视觉生成数据集,包含超过 2000 万个图像 - 文本 - 条件三元组,涵盖五个类别的九个不同任务。
- 该研究进行了实验,证明了统一模型 UniControl 由于学习了不同视觉条件之间的内在关系,超过了每个单任务的受控图像生成。
- UniControl 表现出了以 zero-shot 方式适应未见过的任务的能力,展现了其在开放环境中广泛使用的可能性和潜力。
2. 模型设计
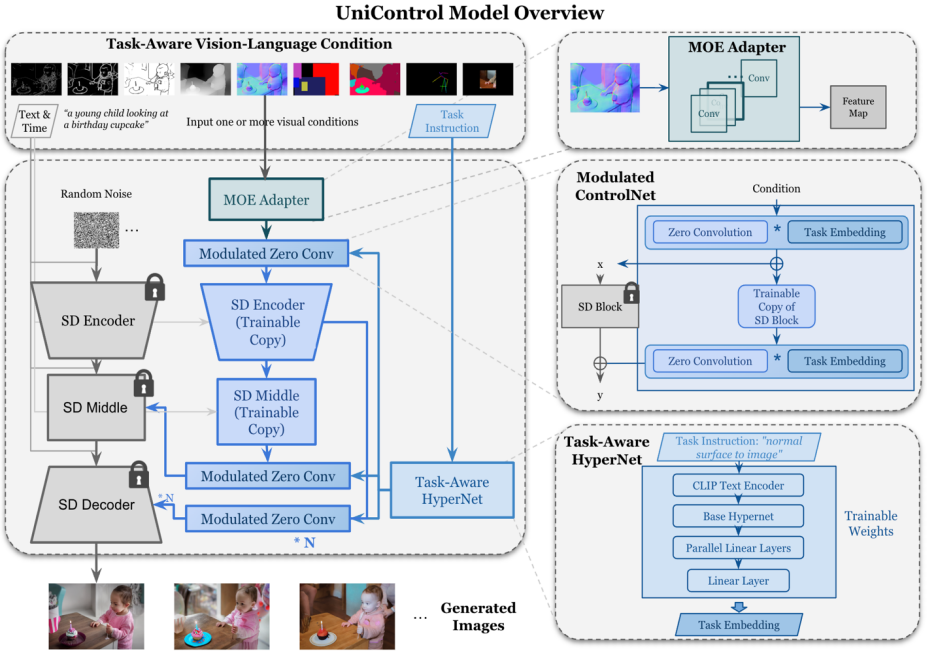
图 2: 模型结构。为了适应多个任务,该研究设计了 MOE-style Adapter,每个任务大约有 70K 个参数,以及一个任务感知 Task-aware HyperNet(约 12M 参数)来调制 7 个零卷积层。这个结构允许在一个单一的模型中实现多任务功能,既保证了多任务的多样性,也保留了底层的参数共享。相比于等效的堆叠的单任务模型(每个模型大约有 1.4B 参数),显著地减少了模型的大小。
UniControl 模型设计确保了两个性质:
1) 克服来自不同模态的低级特征之间的不对齐。这有助于 UniControl 从所有任务中学习必要的和独特的信息。例如,当模型将分割图作为视觉条件时,可能会忽略 3D 信息。
2) 能够跨任务学习元知识。这使得模型能够理解任务之间的共享知识以及它们之间的差异。
为了提供这些属性,模型引入了两个新颖的模块:MOE-style Adapter 和 Task-aware HyperNet。
MOE-style Adapter 是一组卷积模块,每个 Adapter 对应一个单独的模态,灵感来自专家混合模型(MOE),用作 UniControl 捕获各种低级视觉条件的特征。此适配器模块具有约 70K 的参数,计算效率极高。此后视觉特征将被送入统一的网络中处理。
Task-aware HyperNet 则是通过任务指令条件对 ControlNet 的零卷积模块进行调节。HyperNet 首先将任务指令投影为 task embedding,然后研究者将 task embedding 注入到 ControlNet 的零卷积层中。在这里 task embedding 和零卷积层的卷积核矩阵尺寸是对应的。类似 StyleGAN [4],该研究直接将两者相乘来调制卷积参数,调制后的卷积参数作为最终的卷积参数。因此每个 task 的调制后零卷积参数是不一样的,这里保证了模型对于每个模态的适应能力,除此之外,所有的权重是共享的。
3. 模型训练
不同于 SDM 或 ControlNet,这些模型的图像生成条件是单一的语言提示,或如 canny 这样的单一类型的视觉条件。UniControl 需要处理来自不同任务的各种视觉条件,以及语言提示。因此 UniControl 的输入包含四部分: noise, text prompt, visual condition, task instruction。其中 task instruction 可以自然的根据 visual condition 的模态得到。
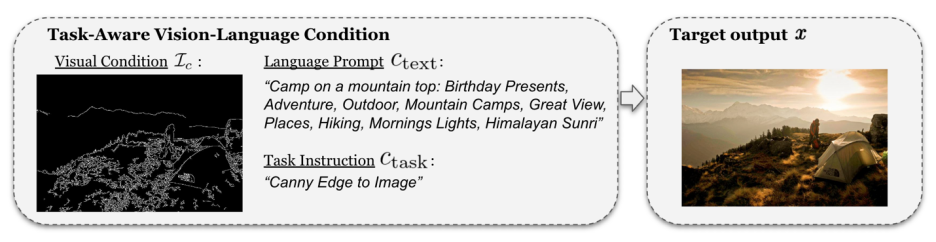
有了这样生成的训练配对,该研究采用 DDPM [5] 对模型进行训练。
4. 实验结果
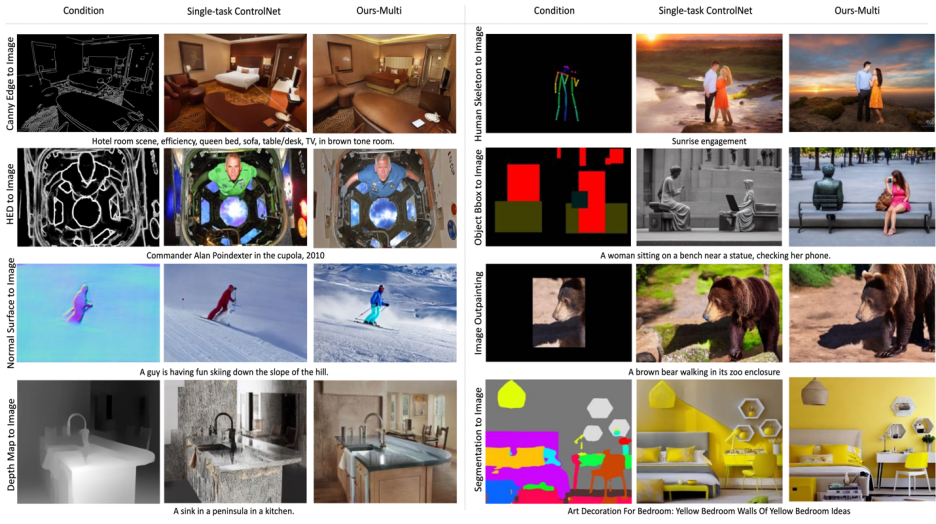
图 6: 测试集视觉对比结果。测试数据来自于 MSCOCO [6] 和 Laion [7]
与官方或该研究复现的 ControlNet 对比结果如图 6 所示,更多结果请参考论文。
5.Zero-shot Tasks 泛化
模型在以下两个场景中测试 zero-shot 能力:
混合任务泛化:该研究考虑两种不同的视觉条件作为 UniControl 的输入,一个是分割图和人类骨骼的混合,并在文本提示中添加特定关键词 "背景" 和 "前景"。此外,该研究将混合任务指令重写为结合的两个任务的指令混合,例如 "分割图和人类骨骼到图像"。
新任务泛化:UniControl 需要在新的未见过的视觉条件上生成可控制的图像。为了实现这一点,基于未见过的和见过的预训练任务之间的关系估计任务权重至关重要。任务权重可以通过手动分配或计算嵌入空间中的任务指令的相似度得分来估计。MOE-style Adapter 可以与估计的任务权重线性组装,以从新的未见过的视觉条件中提取浅层特征。
可视化的结果如图 7 所示,更多结果请参考论文。
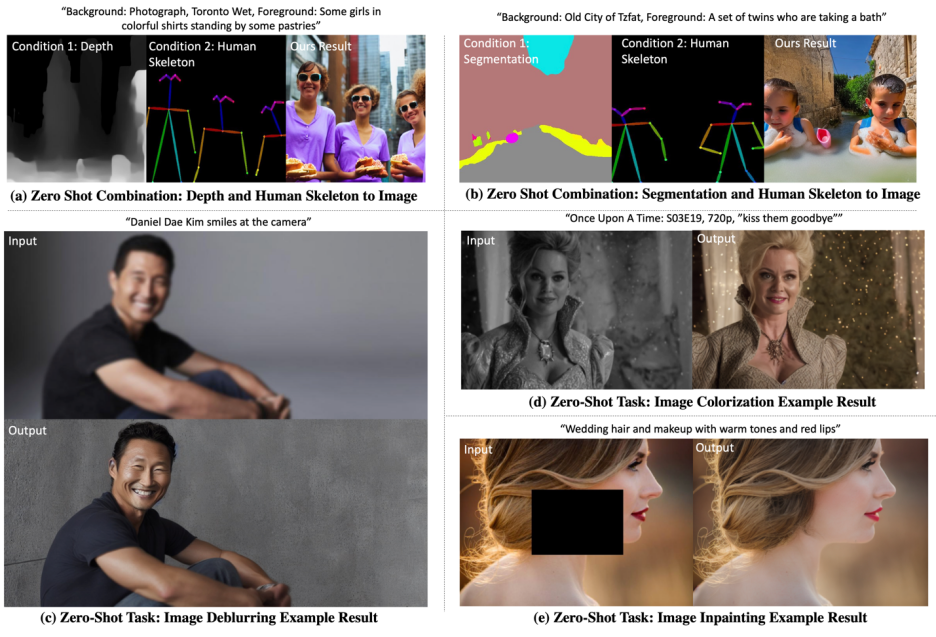
图 7: UniControl 在 Zero-shot tasks 上的可视化结果
6.总结
总的来说,UniControl 模型通过其控制的多样性,为可控视觉生成提供了一个新的基础模型。这种模型能够为实现图像生成任务的更高水平的自主性和人类控制能力提供可能。该研究期待和更多的研究者讨论和合作,以进一步推动这一领域的发展。
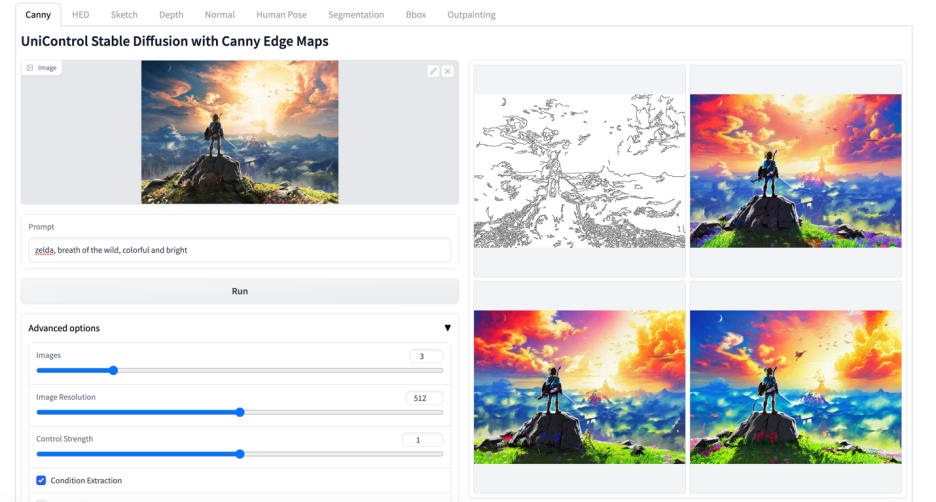
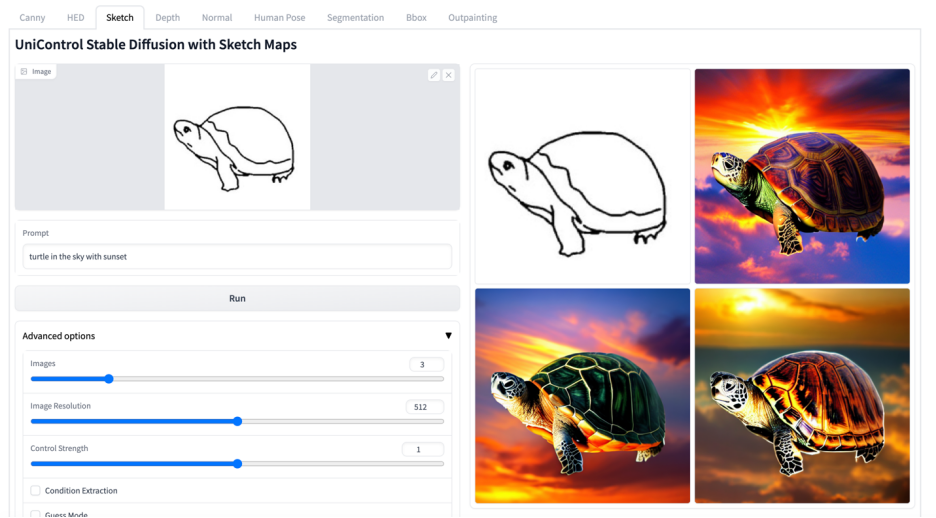
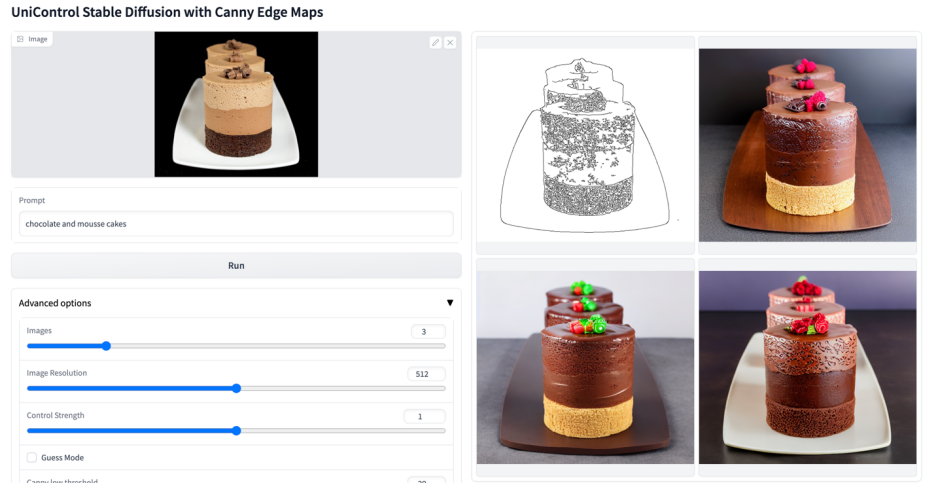
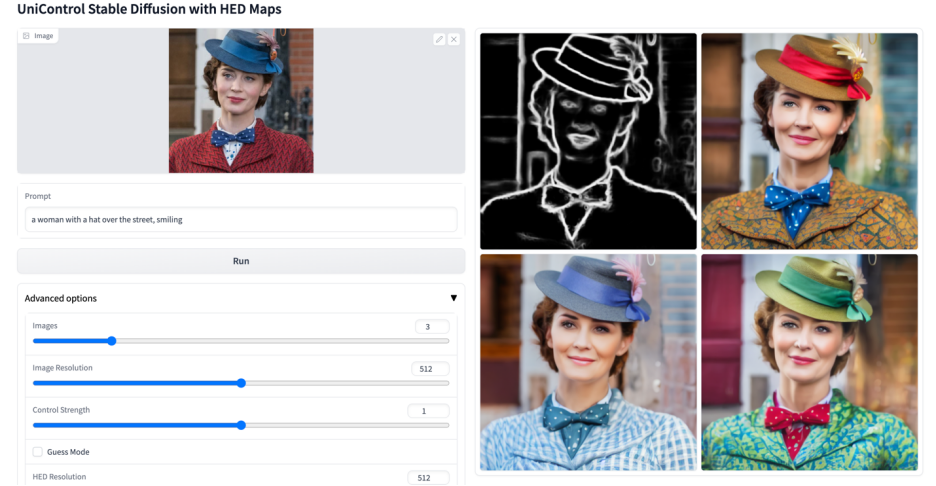
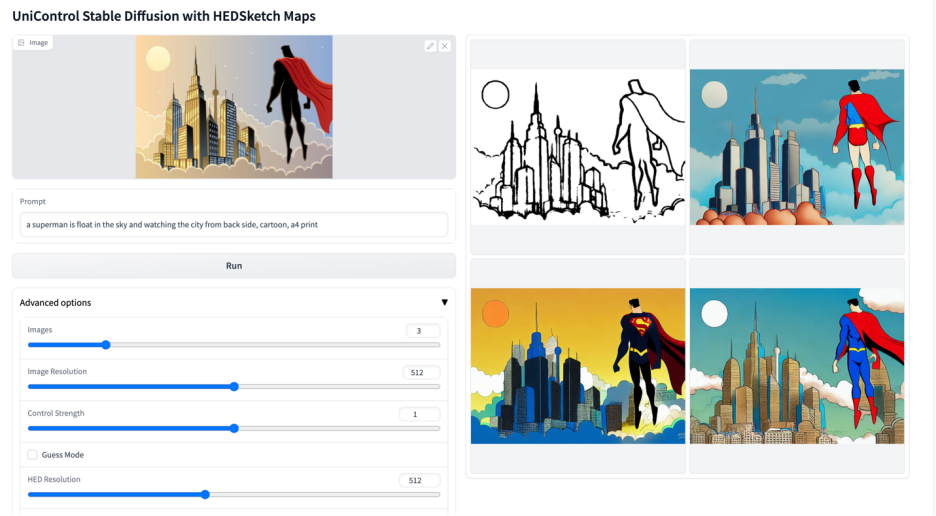
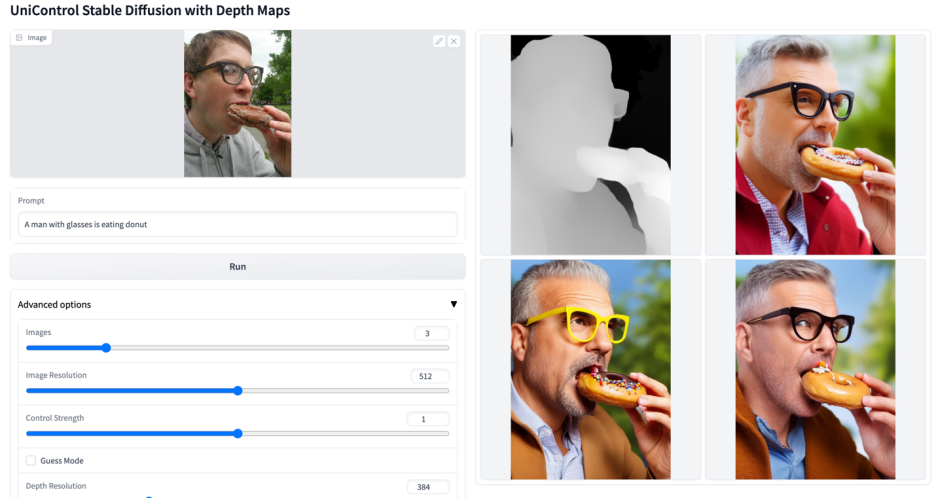
更多视觉效果
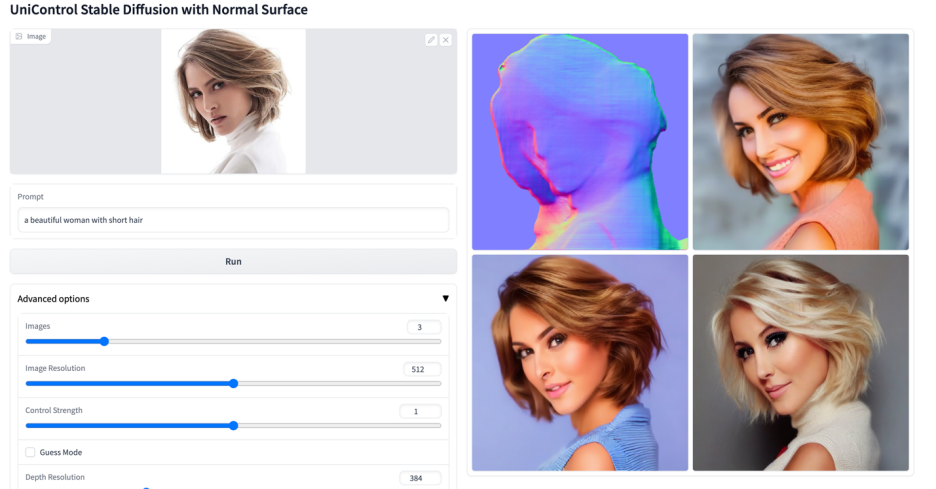
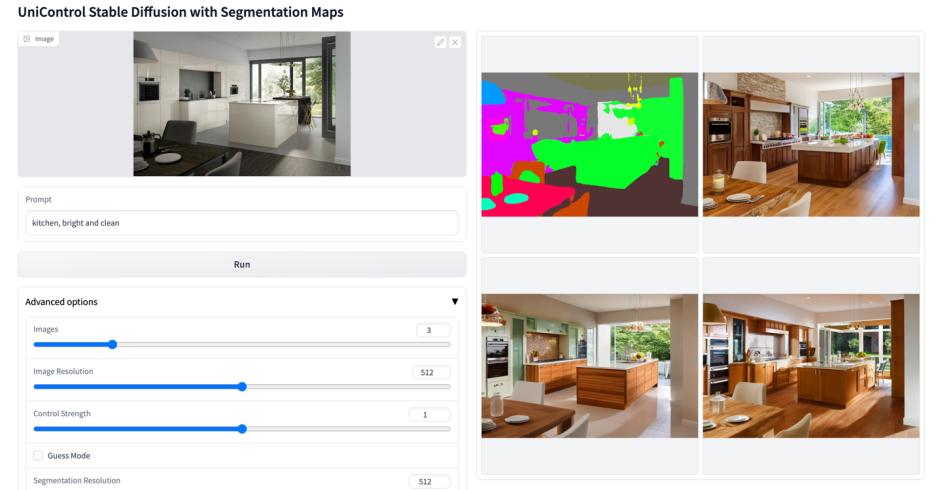
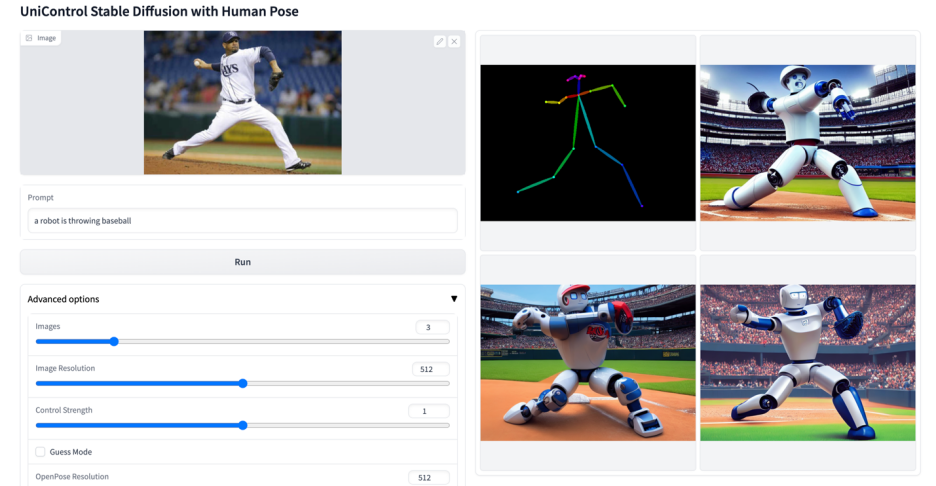
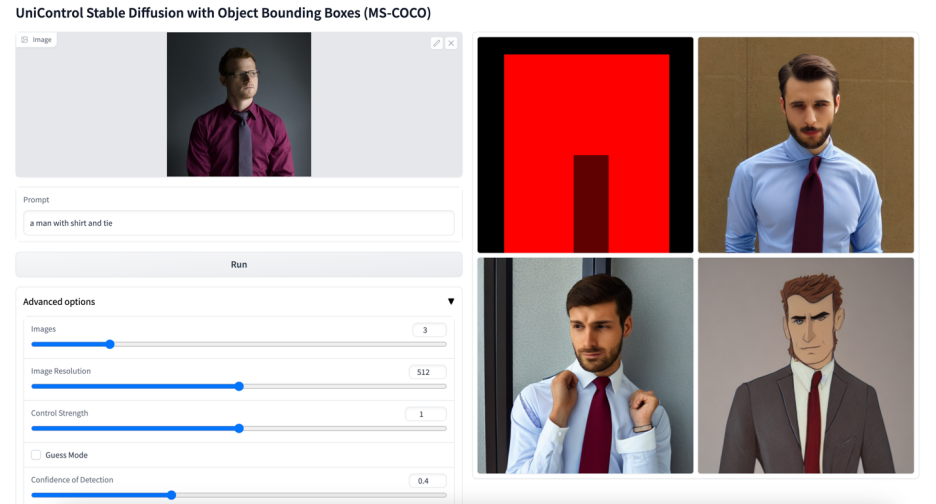
近日Cloudflare收购Astro团队,以强化开源Web框架生态。Astro以内容优先、多框架兼容、毫秒级加载著称,收购后继续保持MIT许可,并支持多平台部署。全新Astro6Beta重构开发服务器,原生集成内容安全策略,极大地提升运行性能与开发体验。
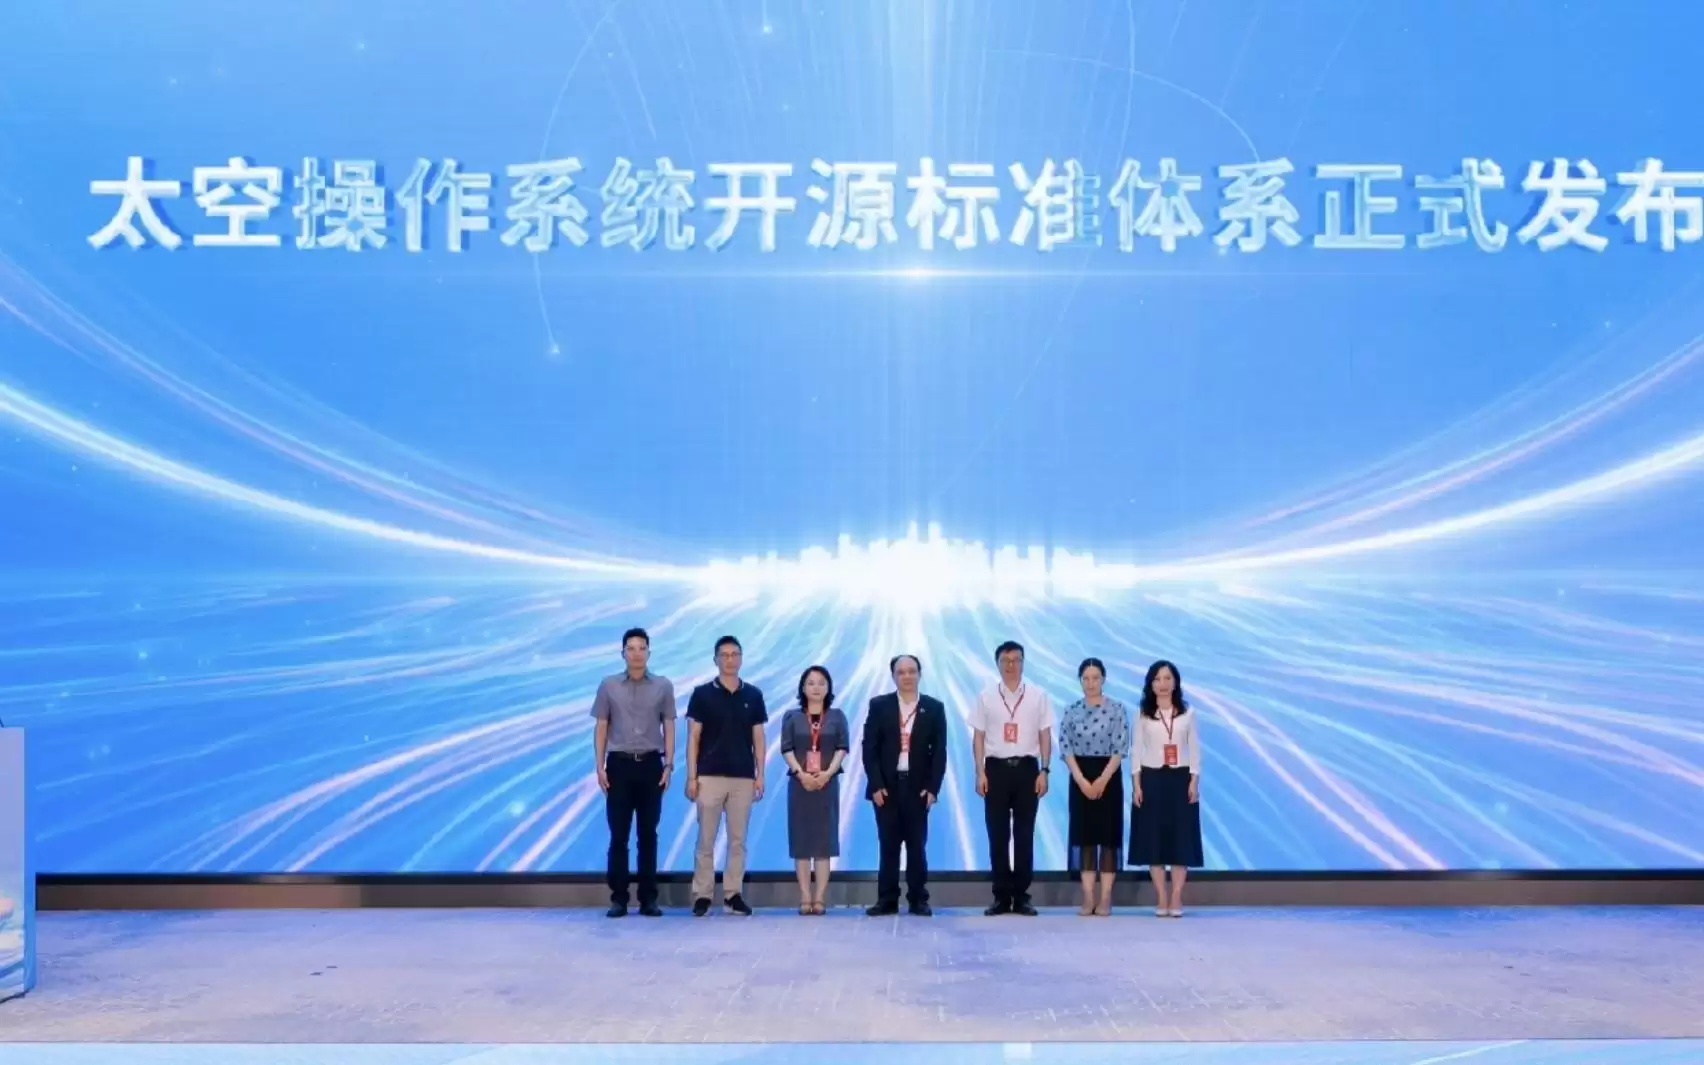
6月29日,2026全球数字经济大会的太空算力论坛在北京海淀举办。这场论坛上,北京太空算力创新中心正式揭牌,同时国内首个太空操作系统开源标准体系也对外亮相。这标志着,我们在太空算力产业的标准化、协同化发展上,迈出了重要一步。活动由全球数字经济大会组委会主办,“北京团队”——市经信局、中关村科学城管委
本文首发于 NebulaGraph 公众号NebulaGraph VEditor 是一个拥有高性能、高可定制的所见即所得图可视化编辑器前端库。NebulaGraph VEditor 底层基于 SVG 绘图,它通过合理抽象代码结构以易于二次开发和自定义绘制,极适用于审批流,工作流,血缘关系,ETL 处
李志信 (GitHubID LaurenceLiZhixin),中山大学软件工程专业在校学生,擅长使用 Ja va/Go 语言,专注于云原生和微服务等技术方向。3月19日,初春的杭州,依旧阴雨朦胧。透过 EFC 健身房的落地窗往外看,远处的楼宇、青山、整齐的街道和稀疏的车辆在水雾中若隐若现。午后的小
今日,StreamNative宣布发布并开源首版AWS Simple Queue Service (SQS) connector[1],这着实令人振奋!借助SQS connector,您能够毫不费力地在Pulsar与SQS之间实现数据的流动,进而充分发挥这两种消息系统各自的优势。可以说,这是Stre
01 网易 Duilib 框架概述 Duilib 是 Windows 系统下的开源的 DirectUI 界面库(遵循 BSD 协议),完全免费,可用于商业软件开发。Duilib 可以简单方便地实现大多数界面需求,包括换肤、换色、透明等功能,支持多种图片格式,使用 XML 可以方便地定制窗口,能较好地
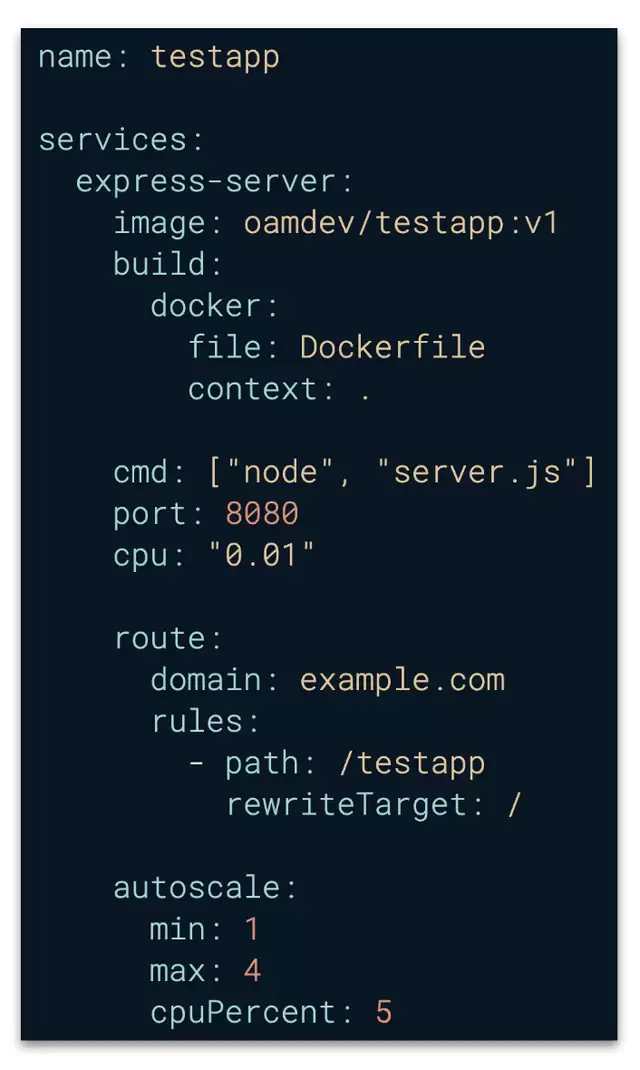
美国西部时间 2020 年 11 月 18 日,在云原生技术“最高盛宴”的 KubeCon 北美峰会 2020 上,CNCF 应用交付领域小组(CNCF SIG App Delivery) 与 Open Application Model (OAM) 社区,以及来自阿里云、微软云的 OAM 项目维护
本文涉及的开源框架,仅包含前端、后端和客户端三个方面开源的世界里到处都是“奇珍异宝”,那些琳琅满目的开源项目,它们各有特色有的是简单清爽的小工具,有的是令人称奇的黑科技,还有的是解决痛点的技术方案。这些开源项目处处散发着“诱人”的气息,让人跃跃欲试、欲罢不能。作为程序员的你,看到那些高星、高性能、高
Databend 是一款现代云数仓。专为弹性和高效设计,为您的大规模分析需求保驾护航。自由且开源。即刻体验云服务:https://app.databend.cn 。What's On In Databend探索 Databend 本周新进展,遇到更贴近你心意的 Databend 。多源数据目录在 D
Databend 是一款现代云数仓。专为弹性和高效设计,为您的大规模分析需求保驾护航。自由且开源。即刻体验云服务:https://app.databend.cn 。What's On In Databend探索 Databend 本周新进展,遇到更贴近你心意的 Databend 。理解连接参数连接参





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



