

贫穷让我预训练
一、要不要预训练预训练的效果是直接的,需要的资源常常令人望而却步。如果有这样一种预训练方法,它需要算力、数据、人工的资源很少,低到单人单卡原始语料就可以启动。经过无监督的数据处理,完成一次迁移到自己领域的预训练之后,就能获得零样本的NLG、NLG和向量表示推理能力,其他向量表示的召回能力超过BM25,那么你有兴趣尝试吗?要不要做一件事,需要衡量投入产出来决定。预训练是大事,需要一些前置条件和资源,也要又充足的预期收益才会实行。通常所需要的条件有:充足的语料库建设,通常来说质量比数量更难得,所以语料库的质量
一、要不要预训练
预训练的效果是直接的,需要的资源常常令人望而却步。如果有这样一种预训练方法,它需要算力、数据、人工的资源很少,低到单人单卡原始语料就可以启动。经过无监督的数据处理,完成一次迁移到自己领域的预训练之后,就能获得零样本的NLG、NLG和向量表示推理能力,其他向量表示的召回能力超过BM25,那么你有兴趣尝试吗?
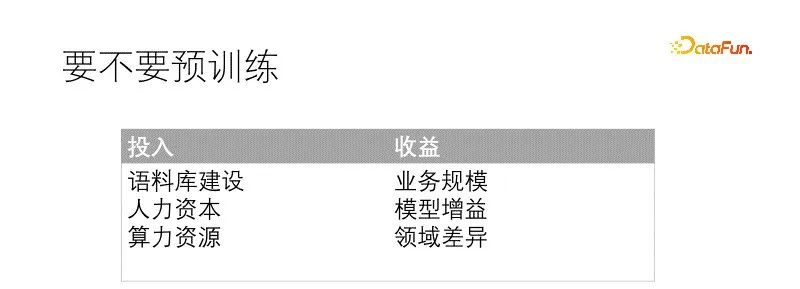
要不要做一件事,需要衡量投入产出来决定。预训练是大事,需要一些前置条件和资源,也要又充足的预期收益才会实行。通常所需要的条件有:充足的语料库建设,通常来说质量比数量更难得,所以语料库的质量可以放松些,数量一定要管够;其次是具备相应的人才储备和人力预算,相较而言,小模型训练更容易,障碍更少,大模型遇到的问题会多些;最后才是算力资源,根据场景和人才搭配,丰俭由人,最好有一块大内存显卡。预训练带来的收益也很直观,迁移模型能直接带来效果提升,提升幅度跟预训练投入和领域差异直接相关,最终收益由模型提升和业务规模共同增益。
在我们的场景中,数据领域跟通用领域差异极大,甚至需要大幅度更替词表,业务规模也已经足够。如果不预训练的话,也会为每个下游任务专门微调模型。预训练的预期收益是确定的。我们的语料库质量上很烂,但是数量足够。算力资源很有限,配合相应的人才储备可弥补。此时预训练的条件都已经具备。
直接决定我们启动预训练的因素是需要维护的下游模型太多了,特别占用机器和人力资源,需要给每个任务都要准备一大堆数据训练出一个专属模型,模型治理的复杂度急剧增加。所以我们探索预训练,希望能构建统一的预训练任务,让各个下游模型都受益。我们做这件事的时候也不是一蹴而就的,需要维护的模型多也意味着模型经验多,结合之前多个项目经验,包括一些自监督学习、对比学习、多任务学习等模型,经过反复实验迭代融合成形的。
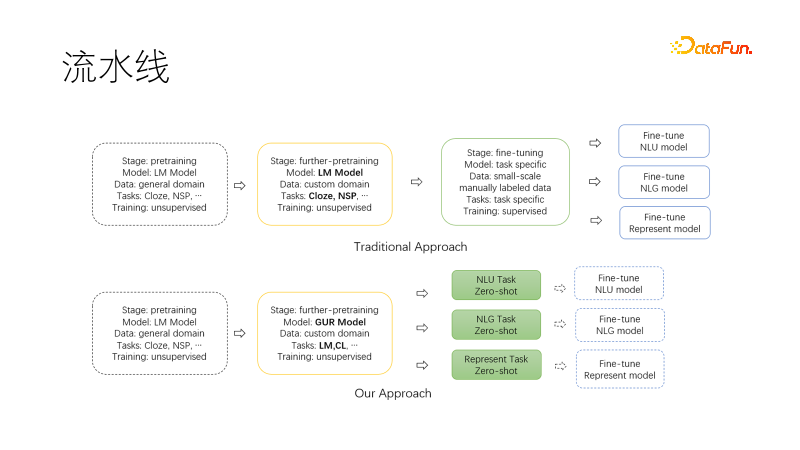
上图是传统的nlp流水线范式,基于已有的通用预训练模型,在可选的迁移预训练完成后,为每个下游任务收集数据集,微调训练,并且需要诸多人工和显卡维护多个下游模型和服务。
下图是我们提出的新范式,在迁移到我们领域继续预训练时候,使用联合语言建模任务和对比学习任务,使得产出模型具备零样本的NLU、NLG、向量表示能力,这些能力是模型化的,可以按需取用。如此需要维护的模型就少了,尤其是在项目启动时候可以直接用于调研,如果有需要再进一步微调,需要的数据量也大大降低。
二、如何预训练
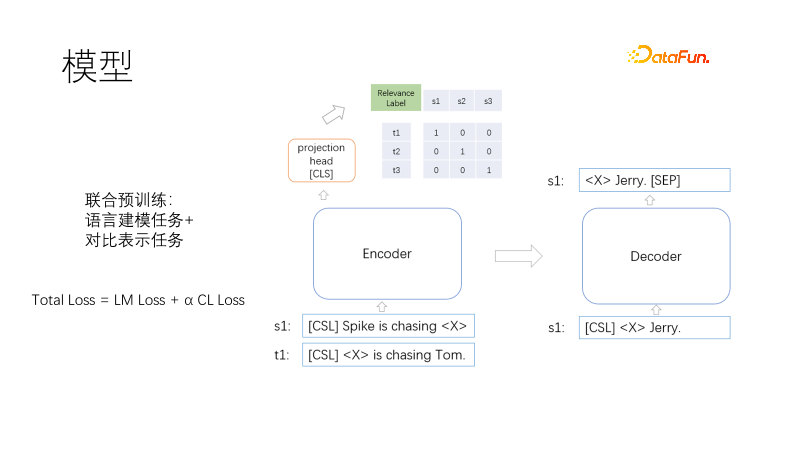
这是我们的预训练模型架构,包括Transformer的编码器、解码器和向量表示头。
预训练的目标包括语言建模和对比表示,损失函数为Total Loss = LM Loss + α CL Loss,采用语言建模任务与对比表示任务联合训练,其中α表示权重系数。语言建模采用掩码模型,类似于T5,只解码掩码部分。对比表示任务类似于CLIP,在一个批次内,有一对相关训练正样本,其他未负样本,对于每一条样本对(i,I)中的i,有一个正样本I,其他样本为负样本,使用对称交叉熵损失,迫使正样本的表示相近,负样本的表示相远。采用T5方式解码可以缩短解码长度。一个非线性向量表示头加载编码器上方,一是向量表示场景中要求更快,二是两个所示函数作用远离,防止训练目标冲突。那么问题来了,完形填空的任务很常见,不需要样本,那相似性样本对是怎么来的呢?
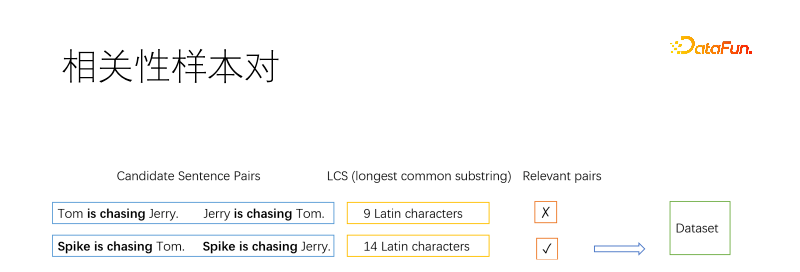
当然,作为预训方法,样本对一定是无监督算法挖掘的。通常信息检索领域采用挖掘正样本基本方法是逆完形填空,在一篇文档中挖掘几个片段,假定他们相关。我们这里将文档拆分为句子,然后枚举句子对。我们采用最长公共子串来判定两个句子是否相关。如图取两个正负句对,最长公共子串长到一定程度判定为相似,否则不相似。阈值自取,比如长句子为三个汉字,英文字母要求多一些,短句子可以放松些。
我们采用相关性作为样本对,而不是语义等价性,是因为二者目标是冲突的。如上图所示,猫抓老鼠跟老鼠抓猫,语义相反却相关。我们的场景搜索为主,更加侧重相关性。而且相关性比语义等价性更广泛,语义等价更适合在相关性基础上继续微调。
有些句子筛选多次,有些句子没有被筛选。我们限制句子入选频次上限。对于落选句子,可以复制作为正样本,可以拼接到入选句子中,还可以用逆向完型填空作为正样本。
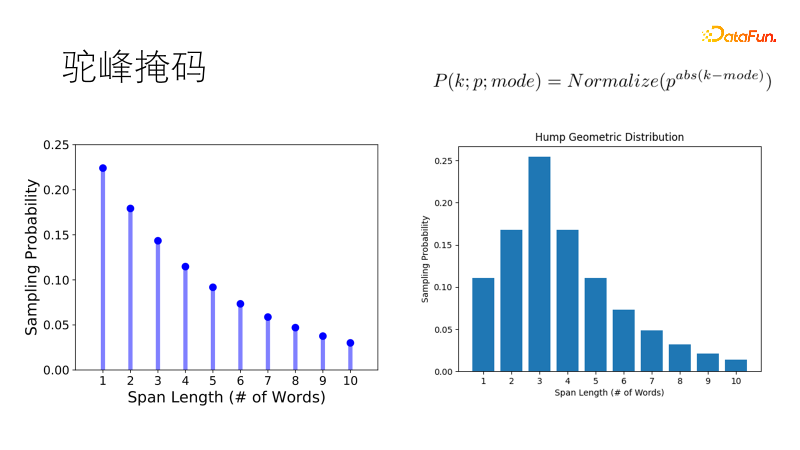
传统的掩码方式如SpanBert,采用几何分布采样掩码长度,短掩码概率高,长掩码概率低,适用于长句子。但我们的语料是支离破碎的,当面对一二十个字的短句子时,传统倾向掩码两个单字胜过遮蔽一个双字,这不符合我们期望。所以我们改进了这个分布,让他采样最优长度的概率最大,其他长度概率逐次降低,就像一个骆驼的驼峰,成为驼峰几何分布,在我们短句富集的场景中更加健壮。
三、实验效果
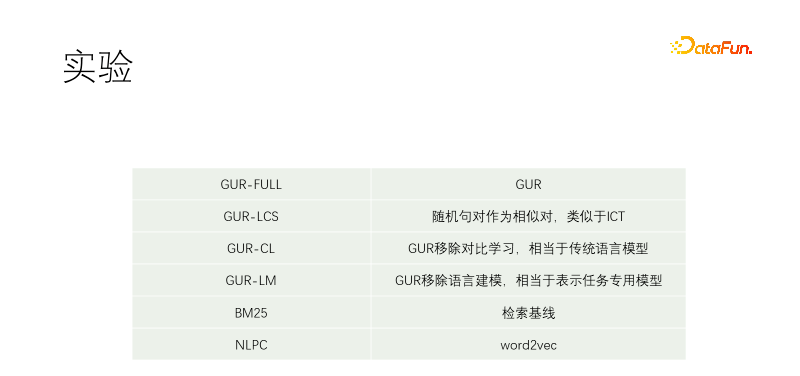
我们做了对照实验。包括GUR-FULL,用到了语言建模和向量对比表示;UR-LCS的样本对没有经过LCS筛选过滤;UR-CL没有对比表示学习,相当于传统的语言模型;GUR-LM只有向量对比表示学习,没有语言建模学习,相当于为下游任务专门微调;NLPC是百度场内的一个word2vec算子。
实验从一个T5-small开始继续预训练。训练语料包括维基百科、维基文库、CSL和我们的自有语料。我们的自有语料从物料库抓来的,质量很差,质量最佳的部分是物料库的标题。所以在其他文档中挖正样本时是近乎任意文本对筛选,而在我们语料库中是用标题匹配正文的每一个句子。GUR-LCS没有经过LCS选,如果不这样干的话,样本对太烂了,这么做的话,跟GUR-FULL差别就小多了。
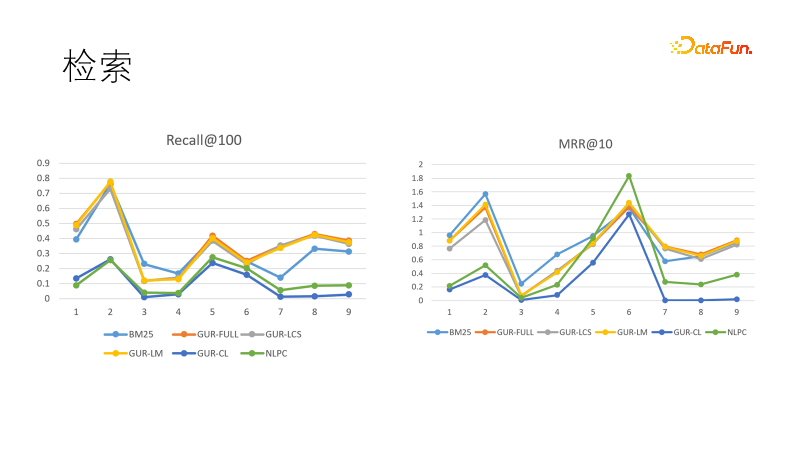
我们在几个检索任务中评测模型的向量表示效果。左图是几个模型在召回中的表现,我们发现经过向量表示学习的模型表现都是最好的,胜过BM25。我们还比较了排序目标,这回BM25扳回一局。这表明密集模型的泛化能力强,稀疏模型的确定性强,二者可以互补。实际上在信息检索领域的下游任务中,密集模型和稀疏模型经常搭配使用。
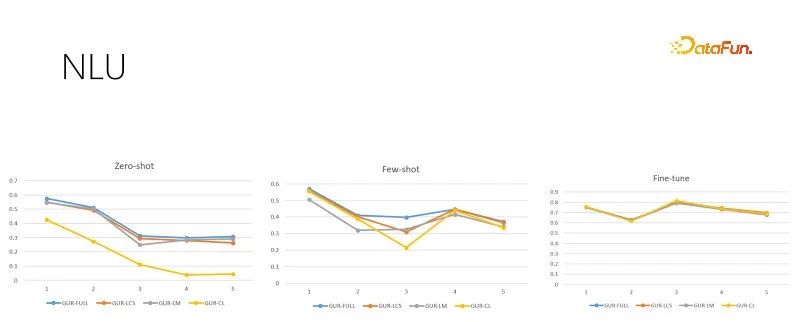
上图是在不同训练样本量的NLU评测任务,每个任务有几十到几百个类别,以ACC得分评估效果。GUR模型还将分类的标签转化为向量,来为每个句子找到最近的标签。上图从左到右依据训练样本量递增分别是零样本、小样本和充足微调评测。右图是经过充足微调之后的模型表现,表明了各个子任务的本身难度,也是零样本和小样本表现的天花板。可见GUR模型可以依靠向量表示就可以在一些分类任务中实现零样本推理。并且GUR模型的小样本能力表现最突出。
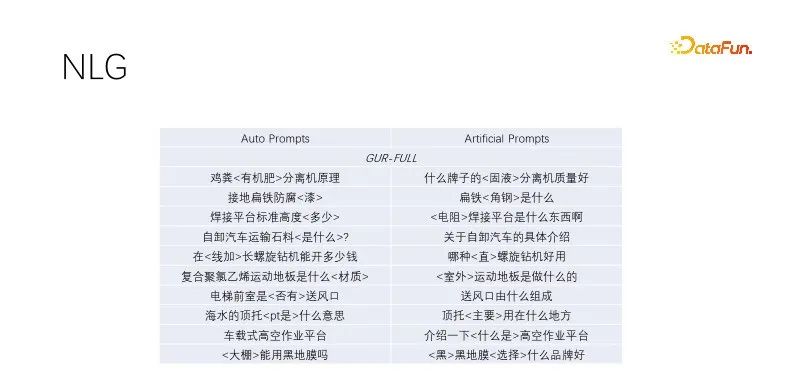
这是在NLG的零样本表现。我们在做标题生成和query扩展中,挖掘优质流量的标题,将关键词保留,非关键词随机掩码,经过语言建模训练的模型表现都不错。这种自动prompt效果跟人工构造的目标效果差不多,多样性更广泛,能够满足大批量生产。经过语言建模任务的几个模型表现差不多,上图采用GUR模型样例。
四、结语
本文提出了一种新的预训练范式,上述对照实验表明了,联合训练不会造成目标冲突。GUR模型在继续预训练时,可以在保持语言建模能力的基础上,增加向量表示的能力。一次预训练,到处零原样本推理。适合业务部门低成本预训练。
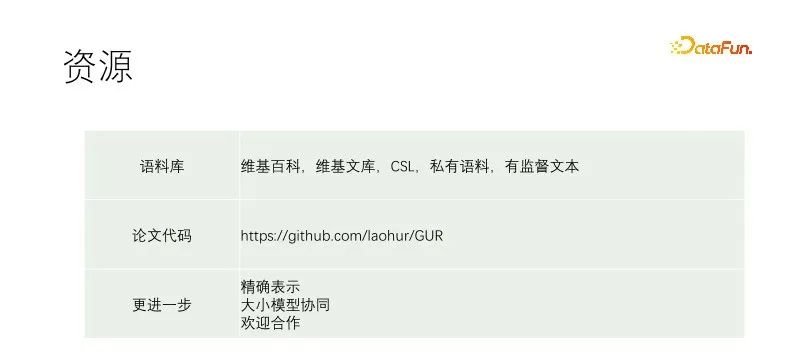
上述链接记载了我们的训练细节,参考文献详见论文引用,代码版本比论文新一点。希望能给AI民主化做一点微小贡献。大小模型有各自应用场景,GUR模型除了直接用于下游任务之外,还可以结合大模型使用。我们在流水线中先用小模型识别再用大模型指令任务,大模型也可以给小模型生产样本,GUR小模型可以给大模型提供向量检索。
论文中的模型为了探索多个实验选用的小模型,实践中若选用更大模型增益明显。我们的探索还很不够,需要有进一步工作,如果有意愿的话可以联系laohur@gmail.com,期待能与大家共同进步。

豆包智能助手:你的跨场景AI效率伙伴 在AI工具层出不穷的今天,找到一款真正能融入日常、解决实际问题的助手并不容易。豆包智能助手通过融合前沿的自然语言处理与多模态交互技术,恰好填补了这一需求。它从学习到创作,为用户提供了一站式的跨场景智能服务,其核心价值在于显著提升我们的日常效率。 直接访问其官网

智能知识管理新范式:NotebookLM 2026深度解析 知识管理工具正迎来一场静默的革命。如果说过去的工具是在帮我们整理文件柜,那么以NotebookLM为代表的新一代平台,则致力于构建一个会思考、能互动的“第二大脑”。2026年,其全新升级的官网成为体验这场变革的前沿阵地,它究竟如何重新定义我

智能知识管理的新范式:NotebookLM全景解析 在信息爆炸的今天,传统的文档整理方式越来越显得力不从心。你猜怎么着?一个深度融合了AI与自然语言处理技术的工具,正在悄然重塑我们管理知识的方式。它便是NotebookLM——这款新一代的智能知识管理解决方案,凭借其三大核心优势,为高效的知识体系构建


卡内基梅隆大学团队构建PRAGMA框架,系统性评测大型语言模型的语用理解能力。框架涵盖预设、含义、言语行为、指代消解、语境依赖五大维度。测试显示,所有AI表现显著低于人类,尤其在讽刺和间接表达上差距明显,且模型规模与能力并非正比关系。

秘塔AI搜索引擎:智能信息检索的新范式 在信息过载的时代,精准获取知识变得前所未有的重要。秘塔AI搜索引擎网页版的出现,恰好回应了这一需求。它不只是一个搜索框的升级,而是凭借前沿技术,将信息检索体验推向了高效与精准的新高度。无论是简单的日常查询,还是复杂的专业探索,它都能深刻理解用户意图,并给出令人

探索人工智能技术前沿的窗口——deepseek官网全方位解析 在人工智能浪潮奔涌的今天,有一个平台正悄然成为连接技术与应用的重要桥梁。作为AI领域的创新力量,deepseek官网为用户打开了接触尖端技术与解决方案的便捷通道。 deepseek官网网址 想要直达这个AI技术宝库?官方入口地址就是htt

DEEPSEEK网页版入口是否已成为您获取智能服务的关键障碍? 当我们需要获取智能服务时,一个便捷的入口往往成为决定性因素。这款基于先进自然语言处理技术的AI工具,正在以其卓越的交互能力重塑着信息获取的方式。今天,我们就来详细梳理官方访问路径与特色功能,帮助您开启高效智能体验的全新可能。 DEEPS

Photoshop虽强,但门槛不低:试试这个在线平替方案 说到专业修图,Photoshop自然是标杆。但它的复杂性也让很多普通用户望而却步:安装包大、操作门槛高,处理张图片还得专门打开软件。有没有更便捷的选择?当然有。网页版PS工具的出现,就是为了解决这个痛点。今天要聊的「易可图」,就是其中一款颇具






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
