

不到1000步微调,将LLaMA上下文扩展到32K,田渊栋团队最新研究
在大家不断升级迭代自家大模型的时候,LLM(大语言模型)对上下文窗口的处理能力,也成为一个重要评估指标。比如OpenAI的gpt-3.5-turbo提供16ktoken的上下文窗口选项,AnthropicAI的更是将Claude处理token能力提升到100k。大模型处理上下文窗口是个什么概念,就拿GPT-4支持32ktoken来说,这相当于50页的文字,意味着在对话或生成文本时,GPT-4最多可以记住50页左右内容。一般来讲,大语言模型处理上下文窗口大小的能力是预定好的。例如,MetaAI发布的LLaM
在大家不断升级迭代自家大模型的时候,LLM(大语言模型)对上下文窗口的处理能力,也成为一个重要评估指标。
比如 OpenAI 的 gpt-3.5-turbo 提供 16k token 的上下文窗口选项,AnthropicAI 的更是将 Claude 处理 token 能力提升到 100k。大模型处理上下文窗口是个什么概念,就拿 GPT-4 支持 32k token 来说,这相当于 50 页的文字,意味着在对话或生成文本时,GPT-4 最多可以记住 50 页左右内容。
一般来讲,大语言模型处理上下文窗口大小的能力是预定好的。例如,Meta AI 发布的 LLaMA 模型,其输入 token 大小必须少于 2048。
然而,在进行长对话、总结长文档或执行长期计划等应用程序中,经常会超过预先设置的上下文窗口限制,因而,能够处理更长上下文窗口的 LLM 更受欢迎。
但这又面临一个新的问题,从头开始训练具有较长上下文窗口的 LLM 需要很大的投入。这自然引出一个疑问:我们能否扩展现有的预训练 LLM 的上下文窗口?
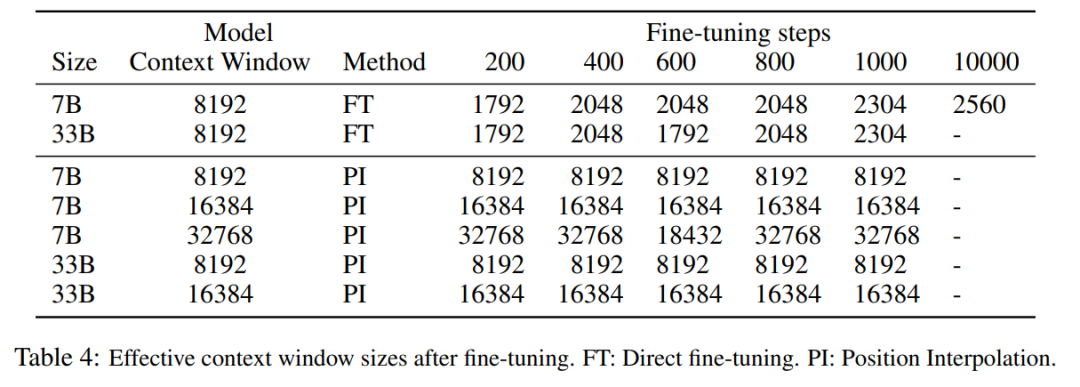
一种直接的方法是对现有的预训练 Transformer 进行微调,以获得更长的上下文窗口。然而,实证结果表明,使用这种方式训练的模型对长上下文窗口的适应速度非常慢。经过 10000 个批次的训练后,有效上下文窗口的增加仍然非常小,仅从 2048 增加到 2560(实验部分的表 4 可以看出)。这表明这种方法在扩展到更长的上下文窗口上效率低下。
本文中,来自 Meta 的研究者引入了位置插值(Position Interpolation,PI)来对某些现有的预训练 LLM(包括 LLaMA)的上下文窗口进行扩展。结果表明,LLaMA 上下文窗口从 2k 扩展到 32k,只需要小于 1000 步的微调。
 图片
论文地址:https://arxiv.org/pdf/2306.15595.pdf
该研究的关键思想不是进行外推(extrapolation),而是直接缩小位置索引,使得最大位置索引与预训练阶段的上下文窗口限制相匹配。换句话说,为了容纳更多的输入 token,该研究在相邻的整数位置上插值位置编码,利用了位置编码可以应用于非整数位置的事实,与在训练过的位置之外进行外推相比,后者可能导致灾难性的数值。
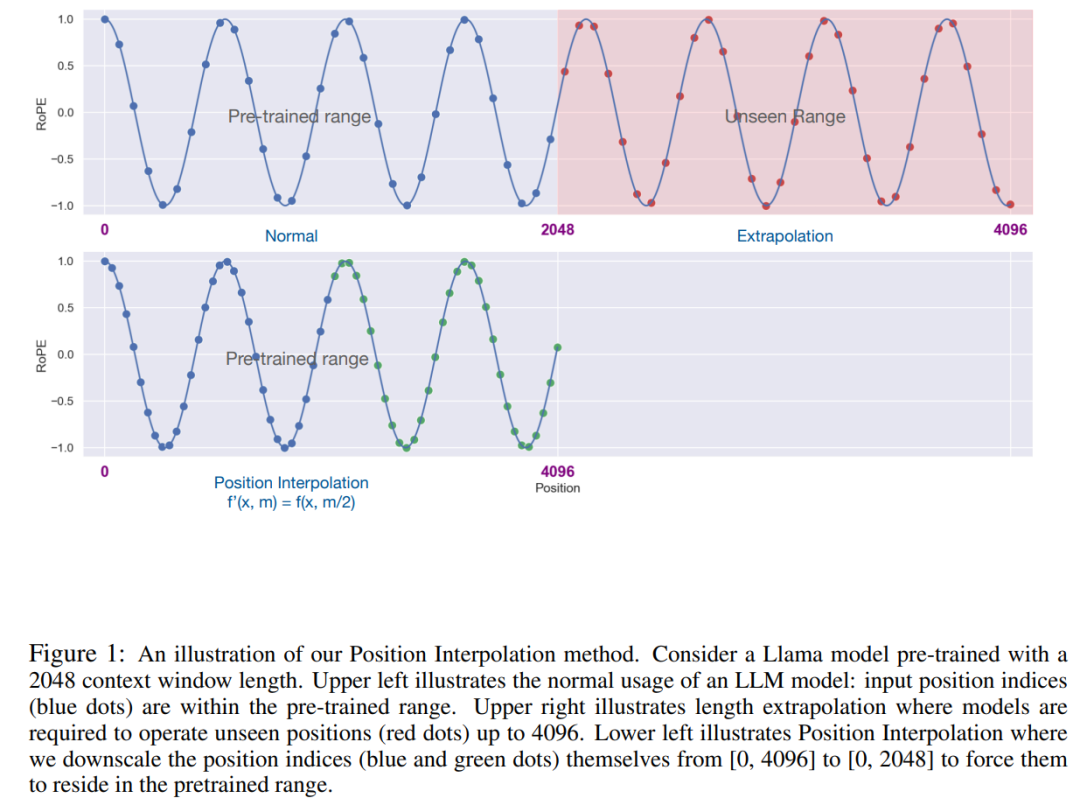
PI 方法将基于 RoPE(旋转位置编码)的预训练 LLM(如 LLaMA)的上下文窗口大小扩展到最多 32768,只需进行最小的微调(在 1000 个步骤内),这一研究在需要长上下文的各种任务上性能较好,包括检索、语言建模以及从 LLaMA 7B 到 65B 的长文档摘要。与此同时,通过 PI 扩展的模型在其原始上下文窗口内相对保持了较好的质量。
方法
在我们比较熟悉的 LLaMA、ChatGLM-6B、PaLM 等大语言模型中,都有 RoPE 身影,该方法由追一科技苏剑林等人提出,RoPE 通过绝对编码的方式实现了相对位置编码。
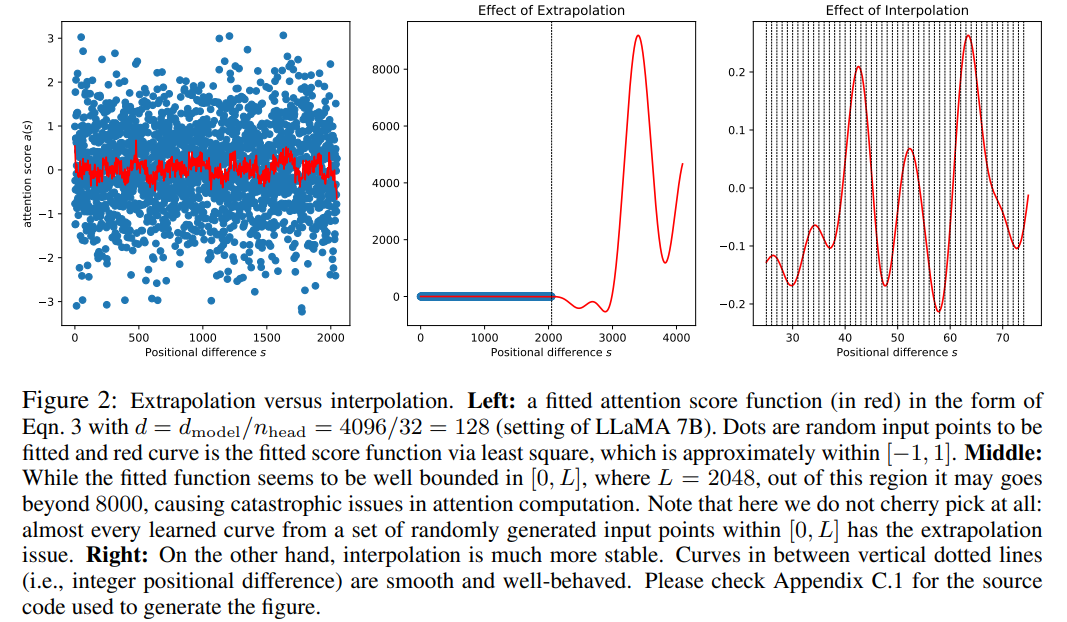
虽然 RoPE 中的注意力得分只取决于相对位置,但它的外推性能并不好。特别是,当直接扩展到更大的上下文窗口时,困惑度可能会飙升到非常高的数字 (即 > 10^3)。
本文采用位置插值的方法,其与外推方法的比较如下。由于基函数 ϕ_j 的平滑性,插值更加稳定,不会导致野值。
 图片
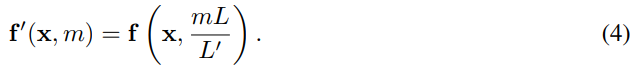
该研究将 RoPE f 替换为 f ′,得到如下公式
 图片
该研究将在位置编码上的转换称为位置插值。这一步将位置索引从 [0, L′ ) 缩减到 [0, L) ,以匹配计算 RoPE 前的原始索引范围。因此,作为 RoPE 的输入,任意两个 token 之间的最大相对距离已从 L ′ 缩减到 L。通过在扩展前后对位置索引和相对距离的范围进行对齐,减轻了由于上下文窗口扩展而对注意力分数计算产生的影响,这使得模型更容易适应。
值得注意的是,重新缩放位置索引方法不会引入额外的权重,也不会以任何方式修改模型架构。
实验
该研究展示了位置插值可以有效地将上下文窗口扩展到原始大小的 32 倍,并且这种扩展只需进行几百个训练步骤即可完成。
表 1 和表 2 报告了 PI 模型和基线模型在 PG-19 、 Arxiv Math Proof-pile 数据集上的困惑度。结果表明使用 PI 方法扩展的模型在较长的上下文窗口大小下显著改善了困惑度。
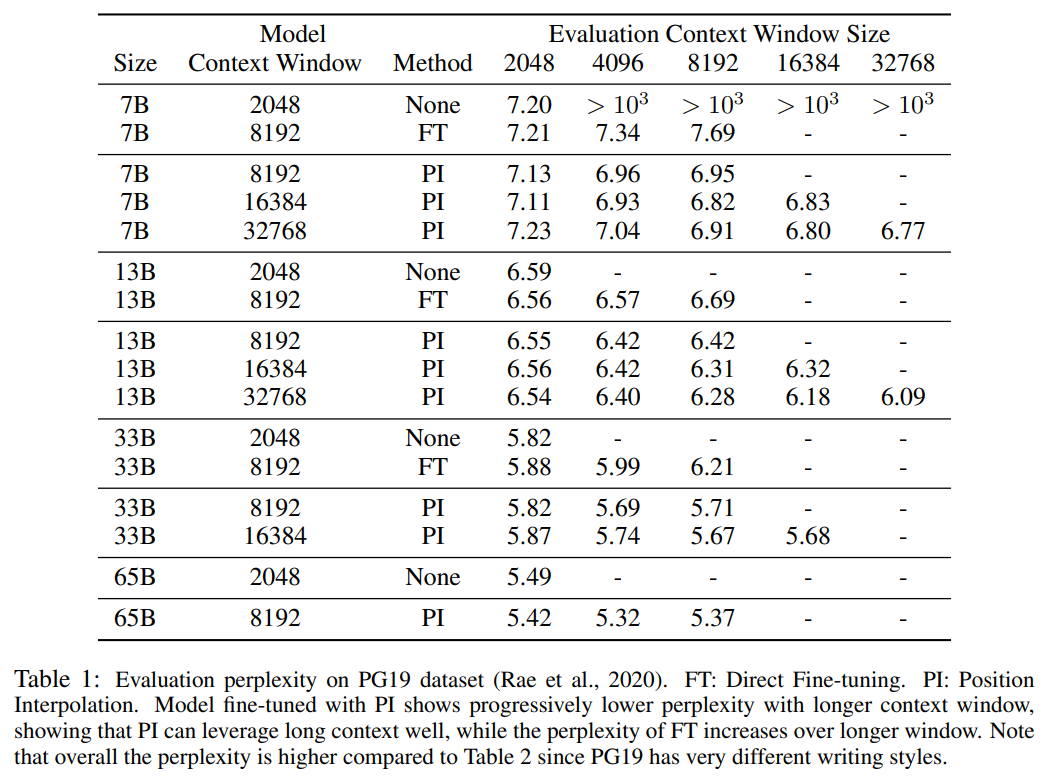
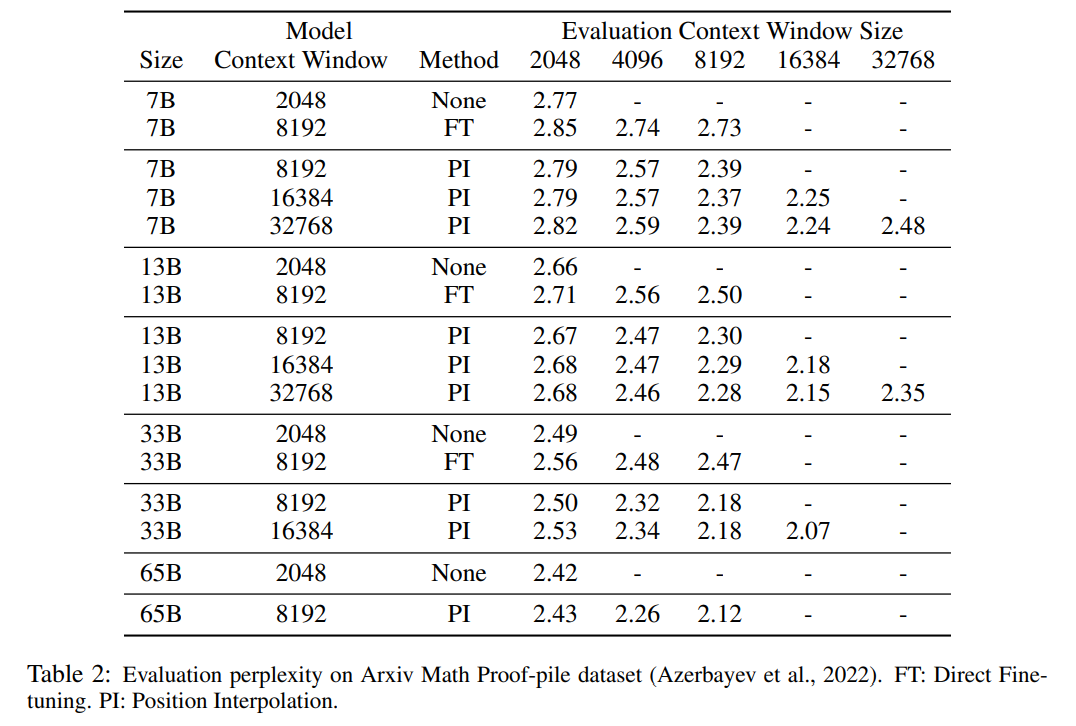
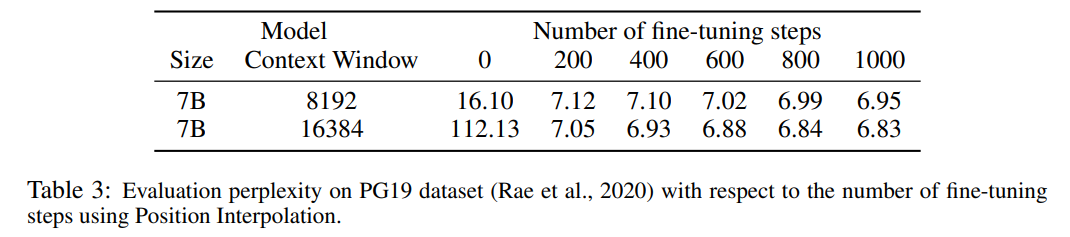
表 3 报告了在 PG19 数据集上使用 PI 方法,将 LLaMA 7B 模型扩展到 8192 和 16384 上下文窗口大小时的困惑度与微调步数之间的关系。
由结果可得,在没有微调的情况下(步数为 0),模型可以展现出一定的语言建模能力,如将上下文窗口扩展到 8192 时的困惑度小于 20(相比之下,直接外推方法的困惑度大于 10^3)。在 200 个步骤时,模型的困惑度超过了 2048 上下文窗口大小下原始模型的困惑度,表明模型能够有效利用比预训练设置更长的序列进行语言建模。在 1000 个步骤时可以看到模型稳步改进,并取得了更好的困惑度。
 图片
下表表明,通过 PI 扩展的模型在有效上下文窗口大小方面都成功地实现了扩展目标,即仅通过微调 200 个步骤后,有效上下文窗口大小达到最大值,在 7B 和 33B 模型大小以及最高 32768 上下文窗口的情况下保持一致。相比之下,仅通过直接微调扩展的 LLaMA 模型的有效上下文窗口大小仅从 2048 增加到 2560,即使经过 10000 多个步骤的微调,也没有明显加速窗口大小增加的迹象。
 图片
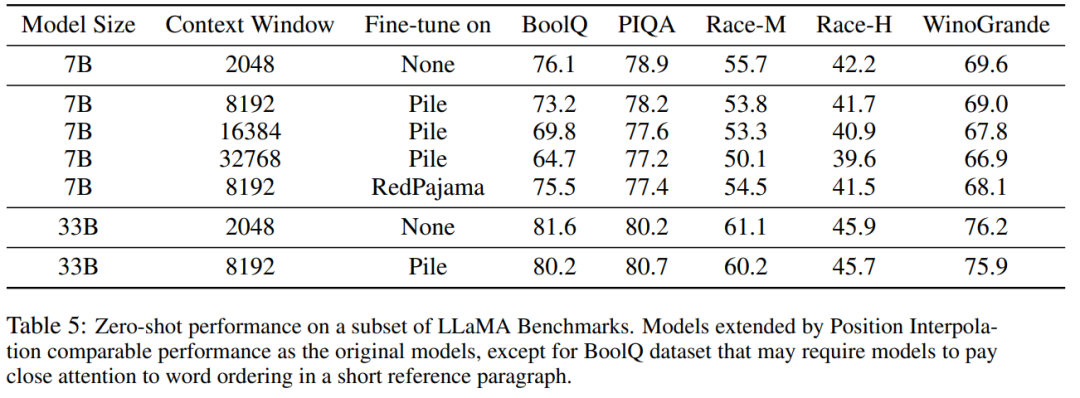
表 5 显示扩展到 8192 的模型在原始基准任务上产生了可比较的结果,而该基准任务是针对更小的上下文窗口设计的,对于 7B 和 33B 模型大小,在基准任务中的退化最多达到 2%。
 图片
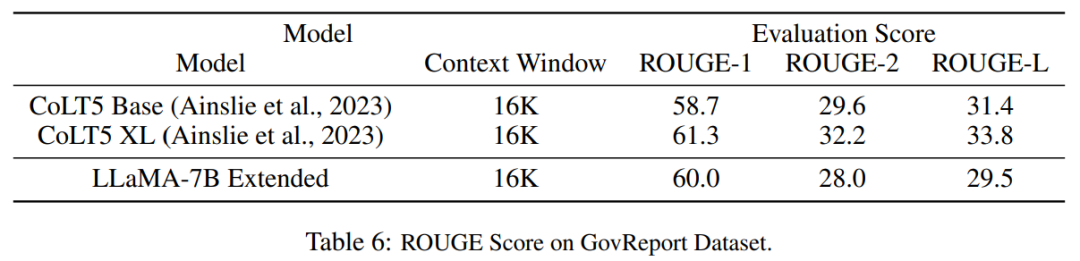
表 6 表明,具有 16384 上下文窗口的 PI 模型,可以有效地处理长文本摘要任务。
 图片
Meta多轮裁员致员工士气降至冰点,上月裁员约8000人。幸存员工被迫承担AI训练杂活,对CEO扎克伯格提出的黑客松活动反应冷淡。扎克伯格承诺今年不再裁员,但承认可能犯更多错误。
Meta首席技术官承认员工士气跌至历史最低点,源于AI转型中裁员8000人及强制调派员工从事枯燥数据标注。管理层致歉并推出涨零食预算、限制管理幅度等福利,但外界对效果持保留态度。
Meta新AI团队MSL成立不到半年,已完成首批核心模型内部交付并进入测试阶段,涵盖文本与图像处理能力。工程化落地仍是难点,公司已重组架构、引进人才并集中资源,计划2026至2027年推出搭载自主AI的终端产品,包括Ray-BanDisplay智能眼镜,目前暂停海外铺货以保障美国订单。
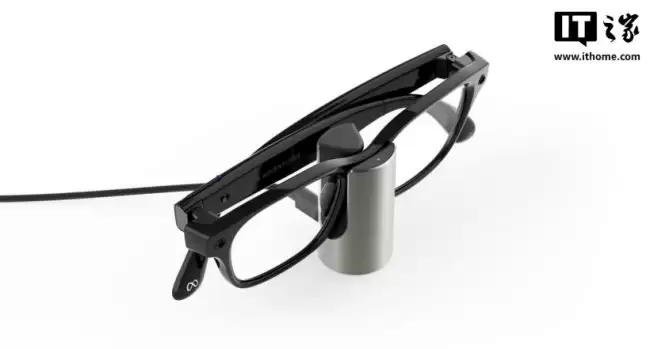
Meta推出一款60美元不锈钢充电底座,专为雷朋联名款及OakleyMetaHSTN智能眼镜设计,但不支持雷朋Display。底座重108克,支持20分钟充至50%、一小时充满,采用USB-C接口但需自备充电线,主打随手一放的便捷体验。
Meta收回强制工程师加入AI团队的指令,承认重组存在失误。此前调动7000名员工,现改为尊重个人选择,并给予调岗优先安置权。员工曾抱怨工作类似数据标注,士气跌至近二十年最低。
豆包大模型2.1Pro正式发布,多项基准测试接近GPT-5.5等水平,日均Tokens调用量达180万亿。Meta推出299美元智能眼镜新系列。甲骨文上财年裁员约2.1万人,部分岗位被AI取代。高通拟40亿美元收购AI芯片初创公司Modular。
Meta公司近日暂停了一项内部计划,该计划原拟通过追踪员工鼠标移动及数字活动来训练AI模型,但由于存在数据安全漏洞——敏感数据可被所有员工访问,已承认正就此展开调查,但未透露暂停将持续多久。
Meta公司今年五月发布内部指南,严格禁止工程师使用Anthropic的ClaudeCode和OpenAI的Codex等外部AI工具生成编程挑战、分析安全漏洞或测试自家模型,以防模型蒸馏引发法律纠纷与事态升级。
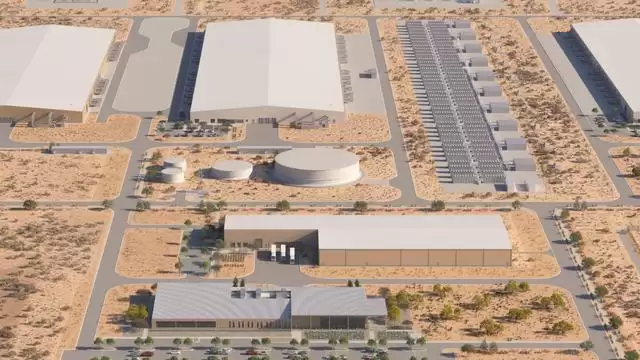
Meta公司自主研发的Vistara定制芯片,利用CXL2.0和PCIeGen5接口,将退役服务器中的DDR4内存接入新一代DDR5服务器,从而延长硬件使用寿命、降低资本支出。这一方案计划部署于超大规模AI数据中心,有效缓解内存资源紧缺与浪费问题。
Meta正用大语言模型替代人工内容审核,已接管约50%的审核请求,每年可节省数十亿美元。计划年底进一步减少人工参与,部分内容的人工审核比例可能削减超90%。同时扎克伯格投入巨资开发个人超级智能技术。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
