

如何使用Java开发一个基于Apache Spark的大数据处理应用
如何使用Java开发一个基于ApacheSpark的大数据处理应用在当今的信息时代,大数据已经成为了企业和组织的重要资产。为了有效地利用这些海量数据,需要强大的工具和技术来处理和分析数据。ApacheSpark作为一个快速、可靠的大数据处理框架,成为了许多企业和组织的首选。本文将介绍如何使用Java语言开发一个基于ApacheSpark的大数据处理应用
如何使用Java开发一个基于Apache Spark的大数据处理应用
在当今的信息时代,大数据已经成为了企业和组织的重要资产。为了有效地利用这些海量数据,需要强大的工具和技术来处理和分析数据。Apache Spark作为一个快速、可靠的大数据处理框架,成为了许多企业和组织的首选。
本文将介绍如何使用Java语言开发一个基于Apache Spark的大数据处理应用。我们将从安装和配置开始,一步一步地引导您完成整个开发过程。
- 安装和配置Spark
首先,您需要下载和安装Apache Spark。您可以从官方网站(https://spark.apache.org/downloads.html)上下载最新版本的Spark。解压缩下载的文件并设置环境变量以访问Spark。
- 创建一个Maven项目
在开始我们的开发之前,我们需要创建一个Maven项目。打开您喜欢的IDE(比如IntelliJ IDEA或Eclipse),创建一个新的Maven项目,并在pom.xml文件中添加Spark依赖。
        org.apache.spark
        spark-core_2.11
        2.4.5


        org.apache.spark
        spark-sql_2.11
        2.4.5
- 创建SparkSession
在Java中,我们使用SparkSession来执行Spark的操作。下面是创建一个SparkSession的示例代码。
import org.apache.spark.sql.SparkSession;

public class SparkApplication {
    public static void main(String[] args) {
        SparkSession spark = SparkSession.builder().appName("Spark Application").master("local[*]").getOrCreate();
    }
}在上面的代码中,我们使用SparkSession.builder()来创建一个SparkSession对象,并设置了应用名和运行模式。
- 读取和处理数据
Spark提供了丰富的API来读取和处理各种数据源,包括文本文件、CSV文件、JSON文件和数据库等。下面是一个读取文本文件并执行简单处理的示例代码。
import org.apache.spark.sql.Dataset;
import org.apache.spark.sql.Row;
import org.apache.spark.sql.SparkSession;

public class SparkApplication {
    public static void main(String[] args) {
        SparkSession spark = SparkSession.builder().appName("Spark Application").master("local[*]").getOrCreate();

        Dataset data = spark.read().textFile("data.txt");
        Dataset processedData = data.filter(row -> row.getString(0).contains("Spark"));

        processedData.show();
    }
}
在上面的代码中,我们使用spark.read().textFile("data.txt")来读取文本文件,并使用filter方法来筛选包含"Spark"关键字的行。最后,使用show方法打印处理后的数据。
- 执行计算和输出结果
除了处理数据,Spark还支持各种计算操作,比如聚合、排序和连接等。下面是一个计算平均值的示例代码。
import org.apache.spark.sql.Dataset;
import org.apache.spark.sql.Row;
import org.apache.spark.sql.SparkSession;
import static org.apache.spark.sql.functions.*;

public class SparkApplication {
    public static void main(String[] args) {
        SparkSession spark = SparkSession.builder().appName("Spark Application").master("local[*]").getOrCreate();

        Dataset data = spark.read().csv("data.csv");
        Dataset result = data.select(avg(col("value")));

        result.show();
    }
}
在上面的代码中,我们使用spark.read().csv("data.csv")来读取CSV文件,并使用select方法和avg函数来计算平均值。最后,使用show方法打印结果。
- 提升性能
为了提高应用程序的性能,我们可以使用Spark的一些优化技术,如持久化、并行化和分区等。以下是一个持久化数据集的示例代码。
import org.apache.spark.sql.Dataset;
import org.apache.spark.sql.Row;
import org.apache.spark.sql.SparkSession;
import org.apache.spark.storage.StorageLevel;

public class SparkApplication {
    public static void main(String[] args) {
        SparkSession spark = SparkSession.builder().appName("Spark Application").master("local[*]").getOrCreate();

        Dataset data = spark.read().csv("data.csv");
        data.persist(StorageLevel.MEMORY_AND_DISK());

        // 对数据集进行操作

        data.unpersist();
    }
}
在上面的代码中,我们使用data.persist(StorageLevel.MEMORY_AND_DISK())来持久化数据集,并在操作完成后使用data.unpersist()将其释放。
通过上述步骤,您可以使用Java语言开发一个基于Apache Spark的大数据处理应用。这个应用可以读取和处理各种数据源,并执行复杂的计算操作。同时,您还可以通过Spark的优化技术来提高应用程序的性能。
希望本文对您使用Java开发基于Apache Spark的大数据处理应用有所帮助!祝您编程愉快、顺利完成项目!
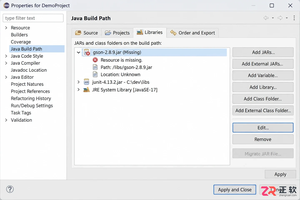
Eclipse导入项目后出现红叉导致无法运行?本文详解检查构建路径、匹配JDK版本、更新Maven依赖及清理项目缓存的实操步骤,助你快速解决编译错误。
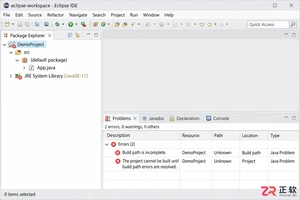
本文详解Eclipse导入项目后出现红叉或红色感叹号的常见原因,包括JDK版本冲突、库文件缺失及Maven依赖问题,提供基于Problems视图的快速定位方法与具体修复步骤。
Python在大数据处理中虽非最快,但通过合理方法仍可高效应用。1.使用Pandas时指定列类型、仅加载所需列、分块读取并及时释放内存,提升数据清洗效率;2.利用Dask进行分布式计算,支持超大文件的多核并行处理;3.结合NumPy实现向量化运算,避免循环,提高数值计算速度;4.合理使用数据库与外部存储,按需提取数据,并利用Parquet等格式优化读写性能。通过上述方法,Python可在大数据场景中发挥重要作用。
如何结合Elasticsearch与Java开发构建搜索应用?1.环境搭建包括安装Elasticsearch、配置Java开发环境及添加ElasticsearchJavaHighLevelRESTClient依赖;2.核心概念涵盖索引、文档、映射、查询和分析器;3.基本操作涉及连接Elasticsearch、创建索引、索引文档、搜索文档、更新文档和删除文档;4.高级查询支持布尔查询、范围查询、模糊查询、前缀查询、通配符查询和聚合查询;5.性能优化需合理设计Mapping、使用批量操作、优化查询语句、使用缓
跨平台Java框架可通过共享代码库为多个平台构建应用程序,显著提升开发效率。这些框架的主要好处包括:代码重复利用、快速原型设计、一致的用户体验和更低的维护成本。Flutter是一个使用Dart语言并以其性能、开发速度和UI而闻名的流行跨平台框架。
流处理技术用于大数据处理流处理是一种即时处理数据流的技术。在C++中,ApacheKafka可用于流处理。流处理提供实时数据处理、可伸缩性和容错性。本例使用ApacheKafka从Kafka主题读取数据并计算平均值。

随着互联网的发展,数据量越来越大,如何高效地处理和计算海量数据成为了一个迫切的问题。在这种背景下,ApacheBeam应运而生,它是一个分布式数据处理框架,可在多种运行环境中运行,是大数据处理领域的一颗新星。本文将介绍如何将PHP和ApacheBeam集成起来,实现高效的大数据处理和计算。一、ApacheBeam简介ApacheBeam是一个分布式数
基于Java的实时大数据处理框架:ApacheStorm:分布式实时处理平台,适合无界数据流,核心概念是“拓扑”。ApacheFlink:统一分布式处理引擎,侧重状态处理和流处理,采用“数据流”概念和“管道”编程。
Storm是用于处理实时数据流的分布式框架。其架构基于发布-订阅模型,包括读取数据并将其发布到拓扑中的Spout,以及处理数据的Bolt。在实战中,Storm可用于计算实时网站流量://创建Spout和Bolt来处理网站流量和计算平均请求数//使用StormSubmitter提交拓扑Storm是一个强大的框架,非常适合处理实时数据流。
如何处理Java开发中的线程死锁检测问题在Java开发中,线程死锁是一个常见的问题。当多个线程相互依赖于彼此释放资源时,可能会发生线程死锁。如果线程被阻塞并且无法继续执行,程序可能陷入无限等待的状态。线程死锁通常是由于以下几种情况引起的:互斥条件:多个线程试图同时获取同一个资源。请求与保持条件:线程持有一个资源,同时又请求另一个资源。不可剥夺条件:线程持有的





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



