

简单掌握MLOps的操作指南
译者|崔皓审校|重楼摘要本文强调MLOps(机器学习运营)的重要性,并详细介绍了其五个关键阶段:问题框架、解决方案框架、数据准备、模型构建和分析以及模型服务和监控。文章通过一个金融科技案例研究,详细解释了如何在实践中应用这五个阶段。最后,文章强调了实施MLOps的好处,包括解决业务问题、使用正确的工具、善用代表问题的数据集、构建最优的机器学习模型,以及部署和监控模型。开篇许多数据科学项目因为各种原因都不为人所知。MLOps就是其中一个,MLOps指的是从数据阶段到部署阶段的过程,它可以确保机器学习模型的成
译者 | 崔皓
审校 | 重楼
摘要
本文强调MLOps(机器学习运营)的重要性,并详细介绍了其五个关键阶段:问题框架、解决方案框架、数据准备、模型构建和分析以及模型服务和监控。文章通过一个金融科技案例研究,详细解释了如何在实践中应用这五个阶段。最后,文章强调了实施MLOps的好处,包括解决业务问题、使用正确的工具、善用代表问题的数据集、构建最优的机器学习模型,以及部署和监控模型。
开篇
许多数据科学项目因为各种原因都不为人所知。MLOps就是其中一个, MLOps指的是从数据阶段到部署阶段的过程,它可以确保机器学习模型的成功。在这篇文章中,你将了解到MLOps的关键阶段(从数据科学家的角度)以及一些常见的陷阱。
小提示:根据估计,2019年MLOps市场规模为232亿美元,并预计到2025年将达到1260亿美元。这是因为MLOps在业内被广泛应用
MLOps的动机
MLOps是一种专注于运营数据科学模型的实践。通常,在大多数企业中,数据科学家负责建模数据集,预处理数据,进行特征工程,最后构建模型。然后,模型被“扔”给工程团队,以便部署成API或者站点。在这个过程中,科学(建模)和工程(部署)往往在各自的孤岛中进行,两部分工作的隔离导致部署延迟,在最坏的情况下,会导致部署错误。MLOps可以快速准确地部署企业规模的ML模型。数据科学往往被人认为 “说起来容易做起来难”。MLOps就是这一领域的灵丹妙药,用来根治从模型学习到生产部署的各种疑难杂症。其实数据科学家都清楚,90%的ML模型并没有投入生产。MLOps给数据科学和工程团队带来了标准和流程,确保他们紧密且持续地合作。这种合作对于确保模型成功部署至关重要。
简述MLOps
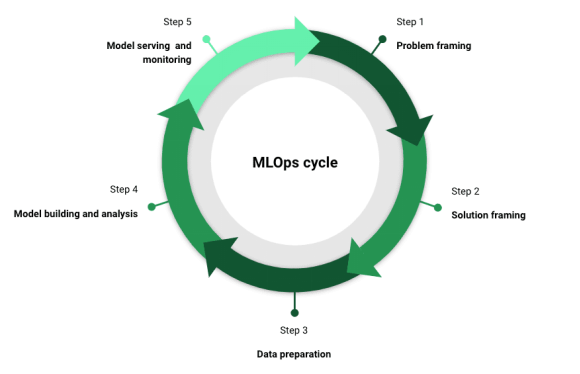
对于熟悉DevOps的人来说,MLOps对于机器学习应用就像DevOps对于软件应用一样重要。MLOps有多种形式,然而有五个关键阶段对于MLOps策略至关重要,同时每个阶段都需要与利益相关者进行沟通。下面我们就展开说明有哪五个阶段:
问题框架
为了成功部署模型并进行使用,深入理解业务问题是至关重要的。在这个阶段,与所有利益相关者进行交流是必要的,以获得项目的支持。这些利益相关者包括工程师、产品经理、合规人员等
解决方案框架
只有在问题陈述被详细讨论之后,才开始考虑“如何”以及是否需要机器学习来解决业务问题?一开始,作为数据科学家,我建议避开机器学习,这一举动可能会让人觉得奇怪。因为“巨大的力量带来的是巨大的责任”。我们只要确保机器学习模型被建立、部署和仔细监控,以确保它满足并继续满足业务需求。同时,在这个阶段也应该与利益相关者讨论时间表和资源。
数据准备
一旦决定走机器学习的路线,就开始考虑"数据"。这个阶段包括数据收集、数据清洗、数据转换、特征工程和标签(对于监督学习)。在这里需要记住的格言是"垃圾输入,垃圾输出"。这个步骤通常是过程中最痛苦的步骤,对于确保模型成功至关重要。要确保多次验证数据和特征,以确保它们与业务问题相符。记录你在创建数据集时做出的所有假设。例如:一个特征的异常值真的是异常值吗?
模型构建和分析
在这个阶段,需要构建和评估多个模型,选择最能解决问题的模型架构。选择的优化指标应反映业务需求。现在,有许多机器学习库可以加快这个步骤。记住记录和跟踪你的实验,以确保机器学习流水线的可重复性。
模型服务和监控
一旦我们从前一阶段构建出模型对象,需要考虑如何让最终用户“使用”它。最小化响应延迟,以及最大化吞吐量。部署服务模型为REST API端点,并将其部署到云上的Docker容器或在边缘设备上。即便是顺利部署了服务,但也不能高兴得太早,因为还存在变数。例如,生产中的数据可能会漂移,导致模型衰退,或者模型会受到对抗性攻击。我们需要为机器学习应用建立强大的监控基础设施。这里需要监控两件事:
需要重新写的内容是:1. 部署环境的健康状况(例如:负载、使用情况、延迟)
需要重写的内容是:2. 模型的健康状况(例如:性能指标,输出分布)
在这个阶段也需要确定监控频率。每天、每周还是每月监控ML应用程序?至此,已经建立、部署和监控了一个健壮的机器学习应用程序。但是,轮子并没有停止旋转,因为上述步骤需要不断迭代。
金融科技案例研究
为了将上述五个阶段付诸实践,我们会举一个案例作为最佳实践的参考。假设你是一家金融科技公司的数据科学家,负责部署一个用于检测欺诈交易的欺诈模型。在这种情况下,首先要深入研究检测的欺诈类型(是第一方还是第三方?)。交易如何被确定为欺诈或非欺诈?是由最终用户报告的,还是你必须使用启发式方法来识别欺诈?谁会使用模型?它将实时使用还是批量模式?回答上述问题对解决这个业务问题至关重要。
接下来,我们需要考虑哪种解决方案能够最有效地解决这个问题。我们需要确定是使用机器学习来解决这个问题,还是先从简单的启发式方法入手来处理欺诈行为?我们还需要弄清楚是否所有的欺诈行为都源自于一小部分IP地址?
如果你决定构建一个机器学习模型(假设这个案例是监督学习),你将需要标签和特征。你将如何处理缺失的变量?异常值呢?欺诈标签的观察窗口是多少?即用户报告欺诈交易需要多长时间?是否有一个数据仓库可以用来构建特征?在向前移动之前,确保验证数据和特征。这也是与利益相关者就项目方向进行交流的好时机
一旦你有了所需的数据,就构建模型并进行必要的分析。确保模型指标与业务使用相符。(例如:对于这个用例,可能是第一分位数的召回率)。所选的模型算法是否满足延迟要求?
最后,需要与工程协调部署和服务模型。由于欺诈检测是一个非常动态的环境,欺诈者努力保持在系统前面,所以监控非常重要。对于数据和模型都需要有一个监控计划。例如,人口稳定性指数(PSI)是常用的用来跟踪数据漂移的指标。你计划多久重新训练一次模型?
现在,你可以成功地通过使用机器学习(如果需要的话!)来减少欺诈交易,从而创造商业价值。
结论
希望你在阅读这篇文章后能够理解MLOps对企业实现机器学习到部署所带来的好处。总的来说,MLOps可以为数据科学团队带来以下优势:
- 解决正确的业务问题
- 使用正确的工具来解决问题
- 利用代表问题的数据集
- 构建最优的机器学习模型
- 最后部署和监控模型以确保持续的成功
然而,要注意常见的陷阱,以确保你的数据科学项目不会成为数据科学墓地的一块墓碑!数据科学应用是一个活生生的东西。数据和模型需要持续被监控。从一开始就应该考虑AI治理,而不是作为事后的想法。牢记这些原则,我相信你可以真正地利用机器学习(如果需要的话!)创造商业价值。
译者介绍
崔皓,51CTO社区编辑,资深架构师,拥有18年的软件开发和架构经验,10年分布式架构经验。
原文标题:How to MLOps like a Boss: A Guide to Machine Learning without Tears,作者:Natesh Babu Arunachalam

在当今信息技术飞速发展的时代,数据科学和人工智能等领域正日益成为热门话题。作为一门功能强大且易于学习的编程语言,Python在这些领域中扮演着至关重要的角色。本文将从多个角度分析为什么选择Python,并结合具体的代码示例来展示Python在数据科学和人工智能领域的重要性。首先,Python具有简洁明了的语法结构,易于理解和学习。相比于其他编程语言,Pyth
数据可视化是将数据转化为可视化表示形式的过程,使我们能够轻松理解和分析复杂的信息。借助python的强大工具,如Matplotlib和Seaborn,数据可视化变得比以往任何时候都更加简单。Matplotlib:基础图表库Matplotlib是Python中创建各种图表类型的首选库。它提供了广泛的函数来生成条形图、折线图、散点图、饼图等。通过pyplot接口,可以轻松绘制和自定义图表。例如,以下代码绘制一个简单的条形图,显示不同类别的数据:importmatplotlib.pyplotaspltdata=
引言pythonCPython是一种高级编程语言,以其简洁、易读性以及广泛的库和社区支持而闻名。在机器学习和数据科学领域,CPython因其强大的数据处理、机器学习算法和数据可视化功能而备受欢迎。本文将深入探讨CPython在这些领域的应用,并提供演示代码以展示其功能。机器学习数据预处理:CPython提供NumPy和pandas等库,可用于数据清洗、转换和操作。示例:importpandasaspddata=pd.read_csv("data.csv")#导入数据data["age"]=data["ag
随着人工智能时代的到来,机器学习成为了一项热门技术,受到广大开发者的追捧。python作为一门强大的编程语言,拥有丰富的库和工具,非常适合用于机器学习的开发。本文将介绍一些Python机器学习的秘诀,帮助开发者快速掌握机器学习技术,开启人工智能时代的大门。1.掌握Python基础在学习机器学习之前,必须先掌握Python的基础知识,包括语法、数据类型、控制流语句、函数、类和对象等。掌握Python基础后,可以学习NumPy、SciPy和pandas等Python机器学习库。2.理解机器学习的基本概念机器学
在当今快速发展的科技时代,各种编程语言的应用范围日益广泛,其中Go语言作为一种高效、简洁、易于学习和使用的编程语言,受到越来越多企业和开发者的青睐。Go语言(也称为Golang)是由Google开发的一种编程语言,它强调简洁、高效和并发编程,适用于各种应用场景。那么,哪些行业对Go语言的需求较大呢?接下来将分析一些主要行业,并探讨它们对Go语言的需求。互联网
数据分析已成为企业决策和战略规划的重要组成部分。python,一门功能强大且用途广泛的编程语言,已成为数据分析师和数据科学家的首选工具。本文将深入探究Python在数据分析中的强大功能,从数据获取和清理到建模和可视化。数据获取与清理Python提供了一个广泛的库,用于从各种来源获取数据,包括文件、数据库和api。可以使用pandas库轻松读取和处理数据帧,而numpy库则提供了高效的数组处理功能。数据清理涉及识别和处理缺失值、异常值和重复项。Python中的dropna、fillna和duplicated
1.Python与机器学习的邂逅python作为一种简单易学、功能强大的编程语言,深受广大开发者的喜爱。而机器学习作为人工智能的一个分支,旨在让计算机学会如何从数据中学习并做出预测或决策。Python与机器学习的结合,可谓是珠联璧合,为我们带来了一系列强大的工具和库,使得机器学习变得更加容易实现和应用。2.Python机器学习库探秘Python中提供了众多功能丰富的机器学习库,其中最受欢迎的包括:NumPy:提供了高效的数值计算功能,是机器学习的基础库。SciPy:提供了更高级的科学计算工具,是NumPy
机器学习是计算机科学的一个分支,它使计算机能够从数据中学习并在没有明确编程的情况下做出决策。机器学习算法可以通过训练数据来学习,并根据学到的知识对新数据做出预测或决策。python是一种通用的、解释型、面向对象的编程语言。它具有简单、易学、功能强大的特点,非常适合用于机器学习。Python提供了丰富的机器学习库,可以帮助我们轻松地构建机器学习模型。以下是一个使用Python构建机器学习王国的示例代码:#导入必要的库importpandasaspdfromsklearn.model_selectionimp
1.Python机器学习简介机器学习是人工智能的一个分支,它允许计算机在没有被明确编程的情况下学习任务。这使得机器学习非常适合处理复杂和多变的数据,并从中提取见解。python是一种广泛用于机器学习的编程语言。它具有丰富的库和工具,可以帮助您轻松地构建和训练机器学习模型。2.Python机器学习基础在开始机器学习之前,您需要了解一些基本概念。这些概念包括:数据:机器学习模型需要数据来训练和学习。数据可以是结构化的(如表格数据)或非结构化的(如文本或图像)。特征:特征是数据中可以用来预测目标变量的变量。例如
背景数据已渗透到我们生活的各个层面,从智能传感器到庞大数据库。从这些数据中提取有用信息已变得至关避要,以帮助我们制定明智的决策、提升运营效率和创造创新洞察。使用诸如pandas、NumPy等库的编程语言(如:python)扮演着关键的角色。数据提取基础数据提取的第一步是将数据从数据源加载到存储结构中。Pandas的read_csv()方法允许从CSV文件加载数据,而read_sql()方法用于从连接的数据库中获取数据。加载的数据随后可以进行清理和转换,以使其适合于进一步的探索和建模。数据探索一旦数据加载完





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



