

文生3D模型大突破!MVDream重磅来袭,一句话生成超逼真三维模型
这真是太不可思议了!现在只需打几个字就能轻松地创造出精美而高质量的3D模型了?这不,国外一篇博客引爆网络,把一个叫MVDream的东西摆到了我们面前。用户只需要寥寥数语,就可以创造出一个栩栩如生的3D模型。而且和之前不同的是,MVDream看起来是真的「懂」物理。下面就来看看这个MVDream有多神奇吧~MVDream小哥表示,大模型时代,我们已经看到了太多太多文本生成模型、图片生成模型。而且这些模型的性能也越来越强大。我们后来还亲眼目睹了文生视频模型的诞生,当然还有今天要提到的3D模型想象一下,只需输入
这真是太不可思议了!
现在只需打几个字就能轻松地创造出精美而高质量的3D模型了?
这不,国外一篇博客引爆网络,把一个叫MVDream的东西摆到了我们面前。
用户只需要寥寥数语,就可以创造出一个栩栩如生的3D模型。
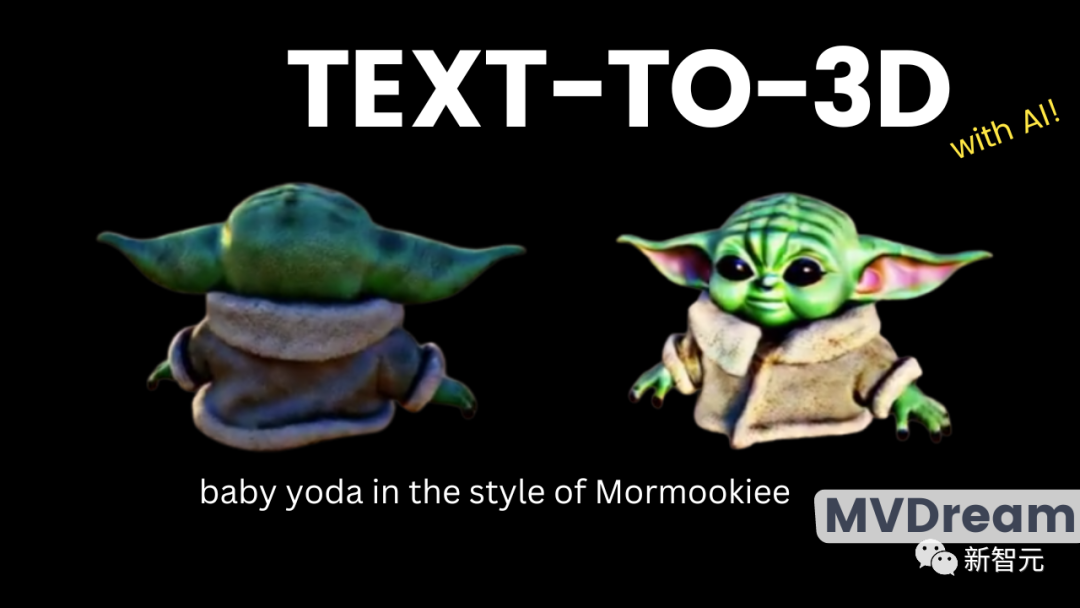
而且和之前不同的是,MVDream看起来是真的「懂」物理。
下面就来看看这个MVDream有多神奇吧~
MVDream
小哥表示,大模型时代,我们已经看到了太多太多文本生成模型、图片生成模型。而且这些模型的性能也越来越强大。
我们后来还亲眼目睹了文生视频模型的诞生,当然还有今天要提到的3D模型
想象一下,只需输入一句话,就能生成一个仿佛真实世界中存在的物体模型,甚至还包含所有必要的细节,这样的场景有多酷啊
而且这绝对不是一件简单的事,尤其是用户需要生成的模型所呈现的细节要足够逼真。
先来看看效果~
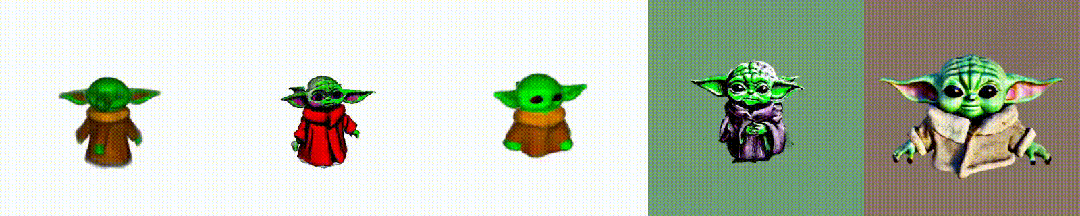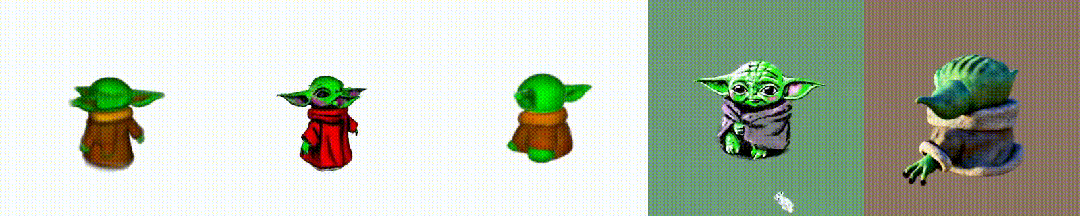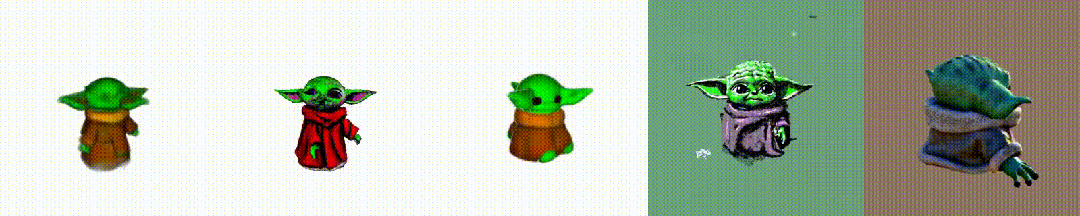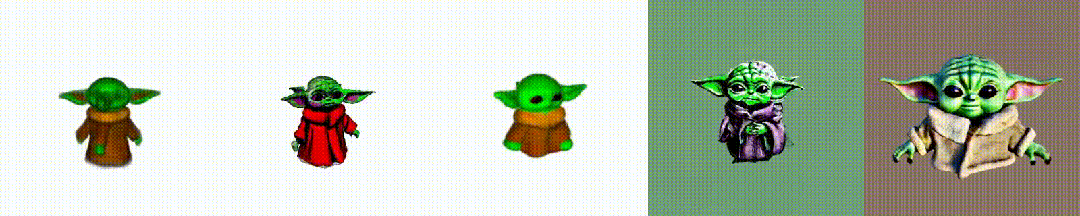
在同一个提示下,最右边展示的是MVDream的成品
肉眼可见5个模型的差距。前几个模型完全违背了客观事实,只有从某几个角度看才是对的。
比如前四张图片,生成的模型居然有不止两只耳朵。而第四张图片虽然看起来细节更丰满一点,但是转到某个角度我们能发现,人物的脸是凹进去的,上面还插着一只耳朵。
谁懂啊,小编一下就想起了之前很火的小猪佩奇正视图。
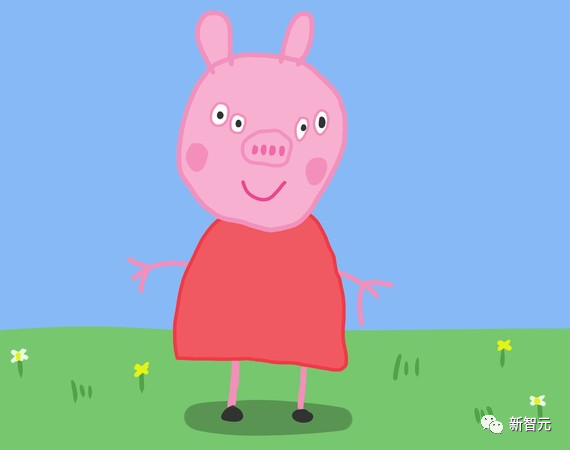
这是一种情况,从某些角度来看是向你展示的,但绝对不能从其他角度去看,会有生命危险
可最右边MVDream的生成模型显然不一样。无论3D模型怎样转动,你都不会觉得有任何反常规的地方。
这也就是之前提到的,MVDream对物理常识了如指掌,不会为了确保每个视图都有两只耳朵而制造一些奇奇怪怪的东西
小哥指出,判断一个3D模型是否成功的关键在于观察其不同视角是否逼真且质量是否高
而且还要保证模型在空间上的连贯性,而不是像上面多个耳朵的模型那样。
生成3D模型的主要方法之一,就是对摄像机的视角进行模拟,然后生成某一视角下所能看到的东西。
换个词,这就是所谓的2D提升(2D lifting)。就是将不同的视角拼接在一起,形成最终的3D模型。
出现上面多耳的情况,就是因为生成模型对整个物体在三维空间的样态信息掌握的不充分。而MVDream恰恰就是在这方面往前迈了一大步。
这个新模型解决了之前一直存在的3D视角下的一致性问题
分数蒸馏采样
这种方法被称为分数蒸馏采样(score distillation sampling),是由DreamFusion开发的
在开始学习分数蒸馏采样技术之前,我们需要先了解一下该方法所采用的架构
换句话说,这实际上只是另一种二维图像扩散模型,类似的还有DALLE、MidJourney和Stable Diffusion模型
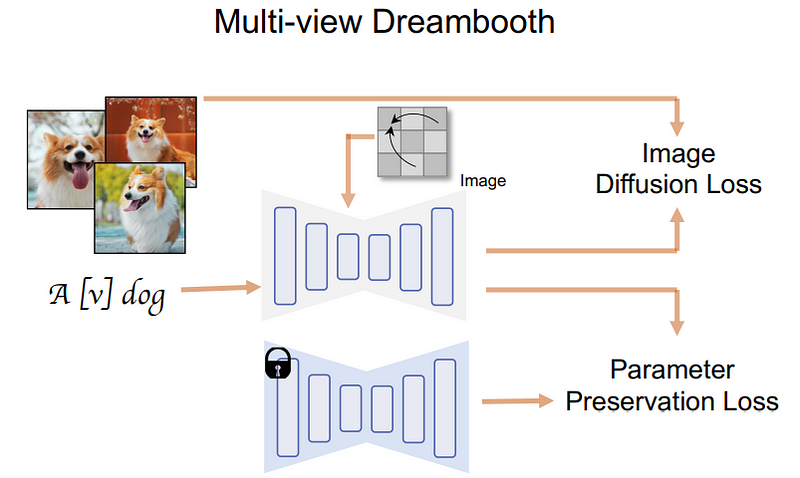
更具体地说,一切的一切都是从预训练好的DreamBooth模型开始的,DreamBooth是一个基于Stable Diffusion生图的开源模型。
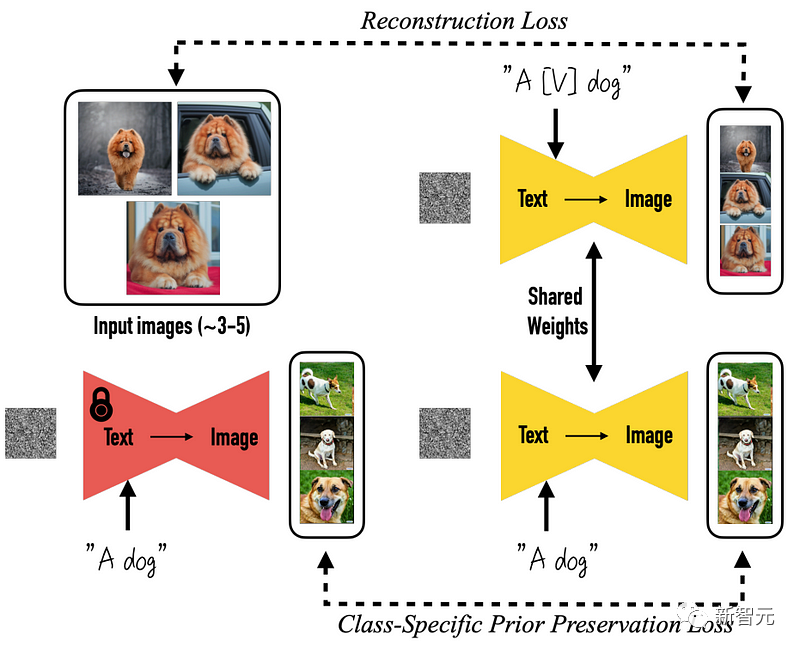
改变来了,这意味着事情发生了转变
研究团队后续所做的是,直接渲染一组多视角图像,而不是只渲染一张图像,这一步需要有各种物体的三维数据集才可以完成。
在这里,研究人员从数据集中获取了三维物体的多个视图,利用它们来训练模型,再使其向后生成这些视图。
具体做法是将下图中的蓝色自注意块改为三维自注意块,也就是说,研究人员只需要增加一个维度来重建多个图像,而不是一个图像。
在下图中,我们可以看到每个视图的模型中都输入了摄像机和时间步(timestep),以帮助模型了解哪个图像将用在哪里,以及需要生成的是哪种视图
现在,所有图像都连接在一起,生成也同样在一起完成。因此它们就可以共享信息,更好地理解全局的情况。
首先,将文本输入模型,然后通过训练模型从数据集中准确地重建物体
而这里也就是研究团队应用多视图分数蒸馏采样过程的地方。
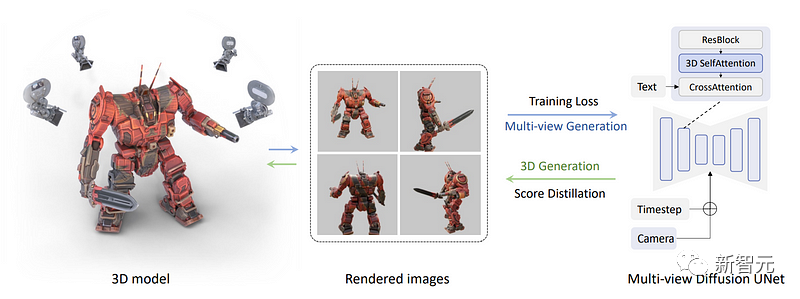
现在,有了一个多视图的扩散模型,团队可以生成一个物体的多个视图了。
接下来,我们需要使用这些视图来重建一个与真实世界一致的三维模型,而不仅仅是视图
这里需要使用NeRF(neural radiance fields,神经辐射场)来实现,就像前面提到的DreamFusion一样。
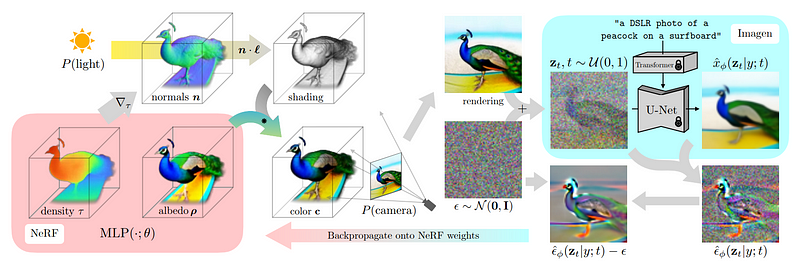
在这一步中,我们的目标是冻结之前训练好的多视角扩散模型。换句话说,我们在这一步中只是使用上面各个视角的图片,而不再进行训练
在初始渲染的指导下,研究人员开始使用多视角扩散模型生成一些带有噪声的初始图像版本
为了让模型了解到需要生成不同版本的图像,研究人员添加了噪声,但同时仍然能够接收到背景信息
接下来,可以利用这个模型进一步生成更高质量的图像
添加用于生成该图像的图像,并移除我们手动添加的噪声,以便在下一步中使用该结果来指导和改进NeRF模型。
为了在下一步中生成更好的结果,这些步骤的目的是更好地理解NeRF模型应该集中在图像的哪个部分
不断重复这个过程,直到生成一个令人满意的3D模型
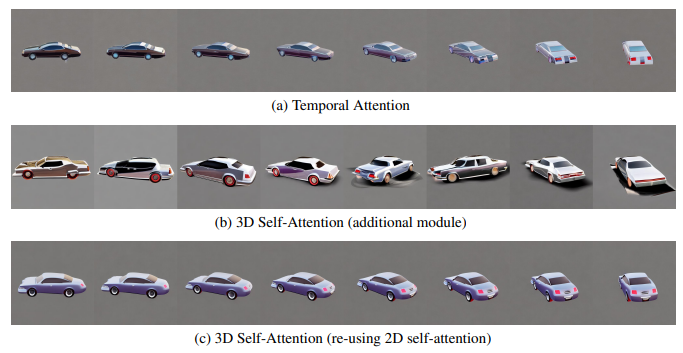
而对于多视角扩散模型的图像生成质量的评估,以及不同的设计会如何影响其性能的判断,该团队是这么操作的。
首先,他们比较了用于建立跨视角一致性模型的注意力模块的选择。
这些选项包括:
(1)视频扩散模型中广泛使用的一维时间自注意;
(2)在现有模型中增加全新的三维自注意模块;
(3)重新使用现有的二维自注意模块进行三维注意。
为了准确展示这些模块之间的差异,在这项实验中,研究人员采用了8帧的90度视角变化来训练模型,以更贴近视频的设置
在实验中,研究团队同时保持了较高的图像分辨率,即512×512作为原始的标清模型。如下图所示,研究人员发现,即使在静态场景中进行了如此有限的视角变化,时间自注意力仍然会受到内容偏移的影响,无法保持视角的一致性
团队假设,这是因为时间注意力只能在不同帧的相同像素之间交换信息,而在视点变化时,相应像素之间可能相距甚远。
另一方面,在不学习一致性的情况下,添加新的三维注意会导致严重的质量下降。
研究人员认为,这是因为从头开始学习新的参数会消耗更多的训练数据和时间,而对于这种三维模型有限的情况并不适用。他们提出了重新使用二维自注意机制的策略,以实现最佳的一致性而不降低生成质量
团队还注意到,如果将图像大小减小到256,视图数减小到4,这些模块之间的差异会小得多。然而,为了达到最佳一致性,研究人员在以下实验中根据初步观察做出了选择。
此外,研究人员在threestudio(thr)库中实现了多视角的分数蒸馏采样,并引入了多视角扩散的引导。该库在一个统一的框架下实现了最先进的文本到三维模型的生成方法
研究人员使用threestudio中的隐式容积(implicit-volume)作为三维表示的实现方式,其中包括多分辨率的哈希网格(hash-grid)
在研究摄像机视图时,研究人员采用了与渲染三维数据集时完全相同的方式对摄像机进行了俩人采样
在此之外,研究人员还对3D模型进行了10000步的优化,使用了AdamW优化器,并将学习率设置为0.01
在分数蒸馏采样中,最初的8000步中,最大和最小时间步长分别从0.98步降至0.5步和0.02步
渲染的起始分辨率是64×64,经过5000步逐渐增加至256×256
以下是更多的案例:
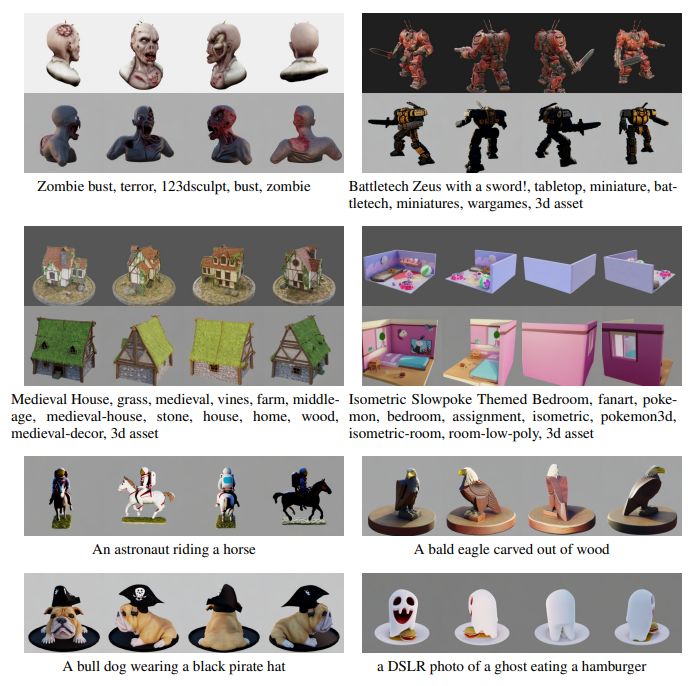
研究团队利用二维文本到图像模型,进行多视角合成,并通过迭代的过程,创建了文本到3D模型的方法
这种新方法目前还存在一些局限性,最主要的问题是生成的图像分辨率只有256x256像素,可以说非常低了
此外,研究人员还指出,执行这项任务的数据集的大小在某种程度上一定会限制这种方法的通用性,因为数据集的太小的话,就没办法更逼真的反应我们这个复杂的世界。
在开始之前,先确认硬件已经就位:关机,把新硬盘装上,再重新开机。开机后第一件事,就是检查系统是否识别到了新设备。用 dmesg | grep ad2 看一眼,如果输出类似 ad2: 9765MB [19841/16/63] at ata1-master UDMA33 这样的信息,说明新硬盘已经被成功
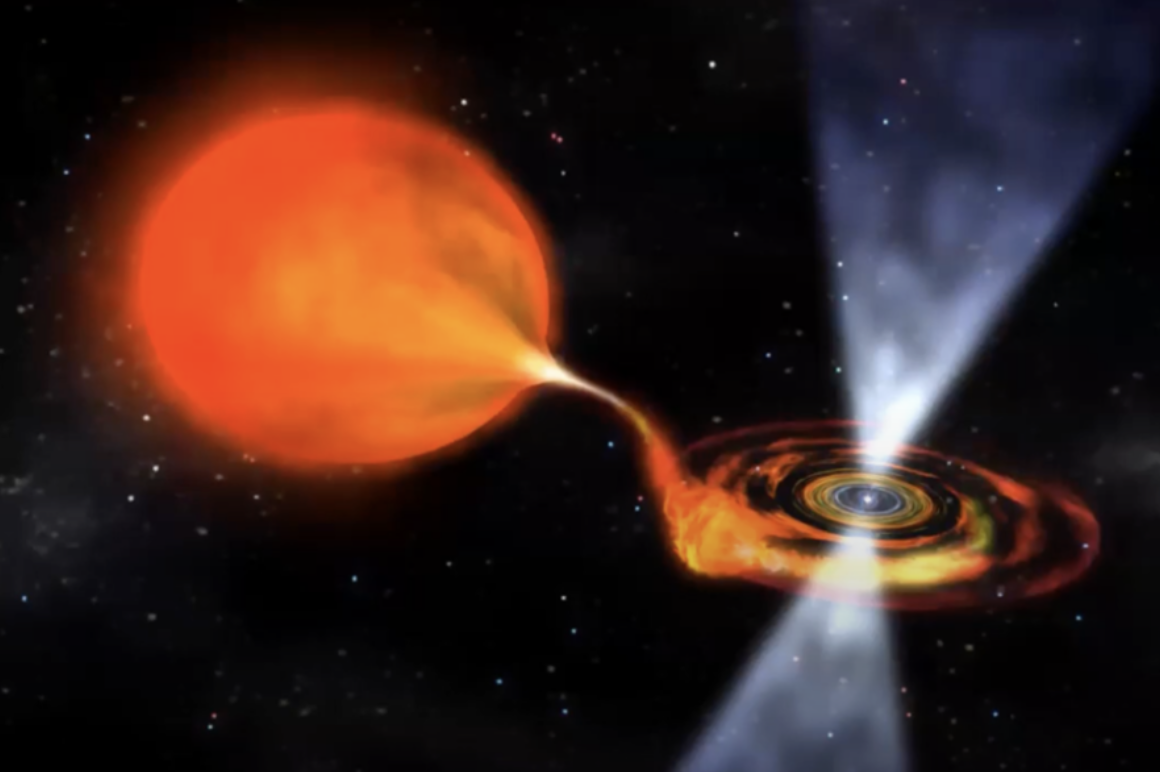
7月25日消息 天文学界最近有一项挺有意思的发现。根据中国科学院发布的信息,由南京天文光学技术研究所研究员王靓团队,联合国家天文台研究员罗阿理等人,利用LAMOST望远镜第十次公开的海量光谱数据,再结合多种测光数据,成功揪出了两颗全新的共生星,同时还锁定了12颗“仅吸积共生星”的候选体。这成果可不只

5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及
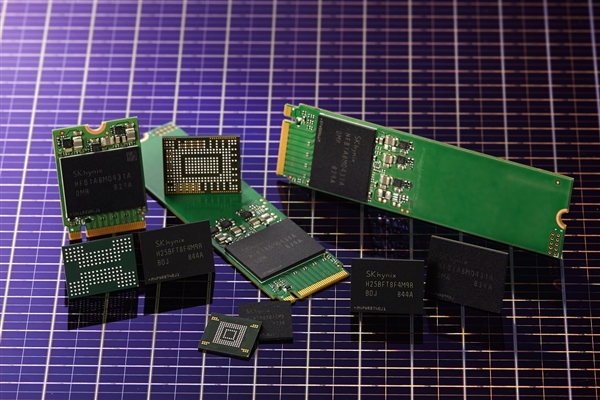
在千兆宽带、5G通信与云服务深度普及的2026年,大众普遍以为超大文件传输已步入“秒级时代”,但现实远未达到这般畅快。当面对数TB乃至数十TB级别的庞大数据集时,当下最可靠、最迅捷且兼顾安全性的传输方案,依然是“物理位移”——依靠人工携带存储介质完成跨地域交付。一位来自河南信阳的用户讲述了真实经历:他曾需将4TB资料从信阳送往郑州,首次尝试纯网络传输,系统预估总耗时近72小时;最终改用专人驱车运送,单程仅需约2.5小时,当天即完成取件与送达,整体效率显著超越线上方式。该实例迅速引发热议,多位资深IT博主随
大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型
现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升
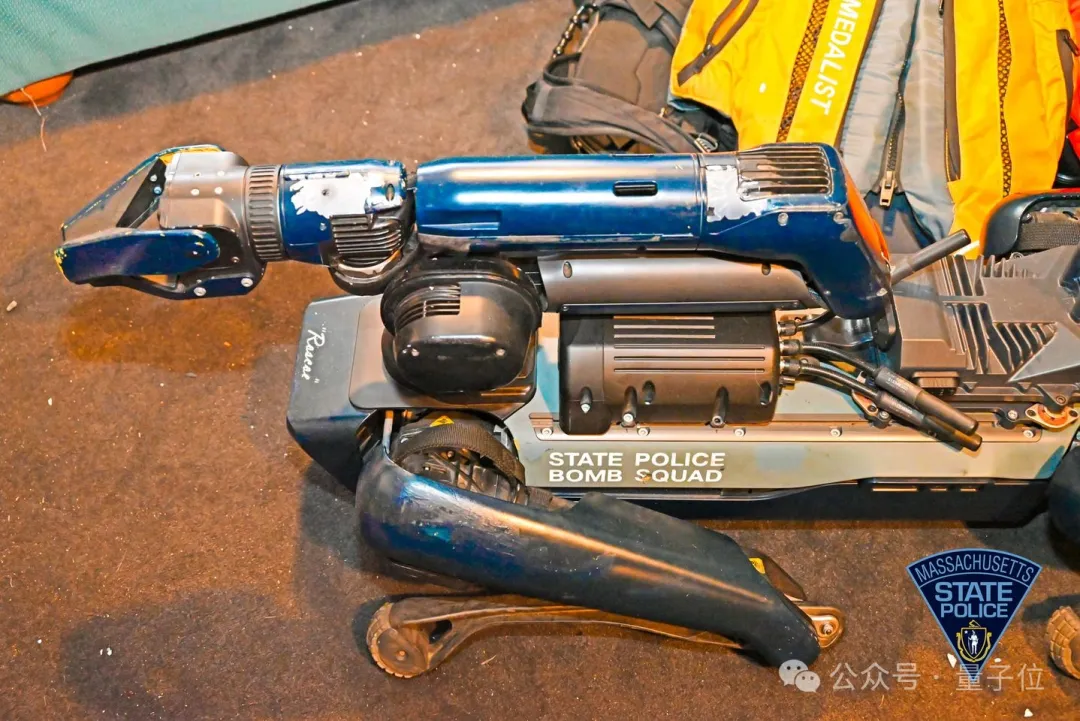
美国警察最新公布一则案件:波士顿动力机器狗首次被枪杀阵亡。官方图显示,机器狗身上有多处枪伤,金属外壳凹陷,油漆脱落,已经无法继续使用。对于机器狗此番牺牲,警方也给予了高度评价:这是在为人类执法伙伴挡住了子弹。波士顿动力机器狗首次被枪杀马萨诸塞州警方详细地披露了案件细节。那是一个平常的周三下午,一名嫌疑人持枪藏在一处住宅内。警察随后派出一只名为Roscoe的机器狗和两台PacBot510履带式机器人,以协助搜捕。在人类士兵遥控操作下,Roscoe对房屋进行了地毯式搜索。结果就在机器狗清查完地下室一个壁橱,然
只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



