

数据扩充技术对模型泛化能力的影响问题
数据扩充技术对模型泛化能力的影响问题,需要具体代码示例摘要:随着深度学习的广泛应用,越来越多的数据扩充技术被用于解决数据不足的问题。本文将探讨数据扩充技术对模型泛化能力的影响,并通过具体代码示例来说明其效果。引言在深度学习任务中,数据是训练模型的关键。然而,现实中往往存在数据不足的问题。为了解决这一问题,研究人员提出了数据扩充技术,通过对现有数据进行变换和增
数据扩充技术对模型泛化能力的影响问题,需要具体代码示例
摘要:随着深度学习的广泛应用,越来越多的数据扩充技术被用于解决数据不足的问题。本文将探讨数据扩充技术对模型泛化能力的影响,并通过具体代码示例来说明其效果。
- 引言
在深度学习任务中,数据是训练模型的关键。然而,现实中往往存在数据不足的问题。为了解决这一问题,研究人员提出了数据扩充技术,通过对现有数据进行变换和增强,生成更多的训练样本。数据扩充技术已经取得了显著的进展,并在各种深度学习任务中广泛应用。 - 数据扩充技术的分类
数据扩充技术可以分为几个主要类别:几何变换、颜色变换、噪声添加等。几何变换包括平移、旋转、缩放等操作,可以改变图像的位置、角度和大小。颜色变换可以改变图像的亮度、对比度、色彩饱和度等,从而增加数据的多样性。噪声添加可以在图像中添加各种噪声,模拟真实世界中的不确定性。 - 数据扩充技术对模型泛化能力的影响
通过数据扩充技术生成的扩充数据可以提供更多的训练样本,有助于提高模型的泛化能力。具体来说,数据扩充可以增加训练数据的多样性,提高模型对不同样本的适应能力。例如,在图像分类任务中,通过随机旋转和平移图像,模型可以更好地识别不同角度和位置下的物体。此外,数据扩充还可以提高模型的鲁棒性,使其对输入数据的噪声和干扰更具有抵抗力。 - 数据扩充技术的实际应用
下面通过具体代码示例来说明数据扩充技术的实际应用效果。以图像分类任务为例,我们使用Python和Keras库实现一个简单的卷积神经网络模型。
首先,导入所需的库和模块:
import numpy as np
from keras import models
from keras import layers
from keras.preprocessing.image import ImageDataGenerator
然后,定义数据生成器,并设置数据扩充参数:
datagen = ImageDataGenerator(
    rotation_range=20,  # 随机旋转角度范围
    width_shift_range=0.2,  # 随机水平平移范围
    height_shift_range=0.2,  # 随机垂直平移范围
    shear_range=0.2,  # 随机错切变换范围
    zoom_range=0.2,  # 随机缩放范围
    horizontal_flip=True,  # 随机水平翻转
    fill_mode='nearest'  # 边界填充方式
)
接下来,加载训练数据,并使用数据生成器进行数据扩充:
train_data = np.load('train_data.npy')
train_labels = np.load('train_labels.npy')

train_generator = datagen.flow(
    train_data, train_labels,
    batch_size=32
)
最后,定义模型结构,进行训练和评估:
model = models.Sequential()
model.add(layers.Conv2D(32, (3, 3), activation='relu', input_shape=(32, 32, 3)))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Flatten())
model.add(layers.Dense(64, activation='relu'))
model.add(layers.Dense(10, activation='softmax'))

model.compile(optimizer='rmsprop',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

model.fit_generator(
    train_generator,
    steps_per_epoch=len(train_data) // 32,
    epochs=100
)

test_data = np.load('test_data.npy')
test_labels = np.load('test_labels.npy')

test_loss, test_acc = model.evaluate(test_data, test_labels)
通过上述代码,我们可以看到,在训练过程中,数据生成器会根据设置的参数对训练数据进行随机扩充。这样,模型可以在训练中接触到更多不同的样本变化,提高泛化能力。最后,通过评估过程,可以得到模型在测试集上的准确率。
- 结论
通过数据扩充技术,我们可以从有限的数据中生成更多的训练样本,提高模型的泛化能力。具体代码示例也展示了如何在图像分类任务中使用数据扩充技术。然而,需要注意的是,数据扩充并不是万能的,过度的数据扩充可能导致模型对于真实数据的表现下降。因此,在实际应用中,需要根据具体任务和数据集来选择合适的数据扩充技术和参数。
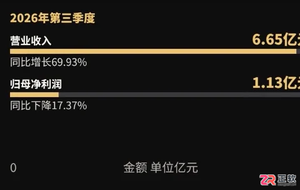
解析宇树科技营收增长但净利下降的原因,说明一加Ace 7 Pro 185Hz高刷的具体适用场景,并厘清Gemini 4 Carbon在长任务与代码安全方面的开放范围,提供准确的数据阅读方法。
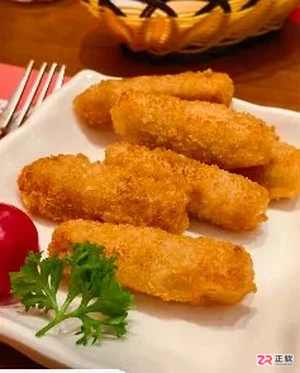
Mate70 Pro与iPhone16 Pro拍照样张对比:观察食物暖色、展厅背景色差和红叶层次,说明构图与拍摄条件的限制,区分风格偏好与综合影像能力。
解析本周AI产品动态:说明Claude Ultra仅对已验证账户取消五小时窗口限制而非无限使用;明确Apple智能接入千问处于开发者测试阶段,非全量Siri能力开放;指出GO-3与灵渠OS仅为场景演示,不提供通用部署教程。引导用户依据官方公告核对自身设备与账户条件。
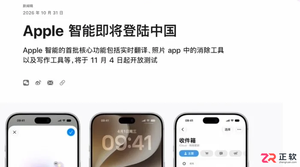
解读国行Apple智能11月4日开放测试的真实含义,明确其与12月iOS 27.3正式版的区别。说明首批功能清单及千问模型支持范围,并提供核对软件更新状态的正确方法,帮助用户理性参与测试。
了解DeepSeek V4.1 Flash 1017的Agent Arena指标、约0.20美元任务成本中位数,以及Terminal-Bench 4.0和ProgramBench成绩变化与适用边界。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
了解 Kimi K3.1 Pro 案例费用、SKY-001 零件构建耗时和 Mercury 3 测试表的限定条件,查看经核实的官方产品说明入口。
想了解Laper AI的真实工资待遇?本文教你如何通过多渠道交叉验证岗位薪资,识别招聘话术中的水分,获取更准确的收入预期参考。
解析字节旗下豆包App、火山引擎、Seedance、TRAE及飞书的定位差异。通过官方文档核对云服务、视频模型、编程工具与办公AI的功能边界,帮助读者准确选择适合的产品入口。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



