

机器学习算法中的特征选择问题
机器学习算法中的特征选择问题,需要具体代码示例在机器学习领域,特征选择是一个非常重要的问题,它能够帮助我们提高模型的准确性和性能。在实际的应用中,数据通常具有大量的特征,而其中可能只有一部分特征对于构建准确的模型来说是有用的。特征选择就是通过选择最相关的特征,来减少特征维度,提高模型的效果。特征选择有多种方法,下面我们将介绍一些常用的特征选择算法,并提供具体
机器学习算法中的特征选择问题,需要具体代码示例
在机器学习领域,特征选择是一个非常重要的问题,它能够帮助我们提高模型的准确性和性能。在实际的应用中,数据通常具有大量的特征,而其中可能只有一部分特征对于构建准确的模型来说是有用的。特征选择就是通过选择最相关的特征,来减少特征维度,提高模型的效果。
特征选择有多种方法,下面我们将介绍一些常用的特征选择算法,并提供具体的代码示例。
- 相关系数法:
相关系数法主要是通过分析特征和目标变量之间的相关性来选择特征。通过计算特征和目标变量之间的相关系数,我们可以得出哪些特征和目标变量之间具有较高的相关性,从而选择出最相关的特征。
具体示例代码如下:
import pandas as pd
import numpy as np

# 加载数据集
dataset = pd.read_csv('data.csv')

# 计算相关系数
correlation_matrix = dataset.corr()

# 获取相关系数大于阈值的特征
threshold = 0.5
correlation_features = correlation_matrix[correlation_matrix > threshold].sum()

# 打印相关系数大于阈值的特征
print(correlation_features)- 卡方检验法:
卡方检验法主要用于选择离散特征和离散目标变量之间的相关性。它通过计算特征和目标变量之间的卡方值,来确定特征与目标变量之间是否存在显著的相关性。
具体示例代码如下:
from sklearn.feature_selection import SelectKBest
from sklearn.feature_selection import chi2

# 加载数据集
dataset = pd.read_csv('data.csv')
X = dataset.iloc[:, :-1]  # 特征
y = dataset.iloc[:, -1]  # 目标变量

# 特征选择
select_features = SelectKBest(chi2, k=3).fit(X, y)

# 打印选择的特征
print(select_features.get_support(indices=True))- 基于模型的特征选择法:
基于模型的特征选择法主要是通过训练模型,选择出对模型性能有显著影响的特征。它可以结合各种机器学习模型进行特征选择,如决策树、随机森林和支持向量机等。
具体示例代码如下:
from sklearn.feature_selection import SelectFromModel
from sklearn.ensemble import RandomForestClassifier

# 加载数据集
dataset = pd.read_csv('data.csv')
X = dataset.iloc[:, :-1]  # 特征
y = dataset.iloc[:, -1]  # 目标变量

# 特征选择
select_features = SelectFromModel(RandomForestClassifier()).fit(X, y)

# 打印选择的特征
print(select_features.get_support(indices=True))
在机器学习算法中,特征选择是解决高维数据问题的一种常用方法。通过选择最相关的特征,我们可以减少模型的复杂度、减少过拟合风险,并提高模型性能。以上是一些常用的特征选择算法示例代码,可以根据实际情况选择合适的方法进行特征选择。
用Solaris 10自带的Samba 3.0.4,配置文件直接走/etc/sfw默认路径,在WinXP下访问倒是一切正常。可一开telnet终端上去,文件名全成了乱码——这就有点难受了。翻了下man手册才发现,unix charset默认用的UTF-8编码,跟中文环境对不上。解决办法很简单,在sm
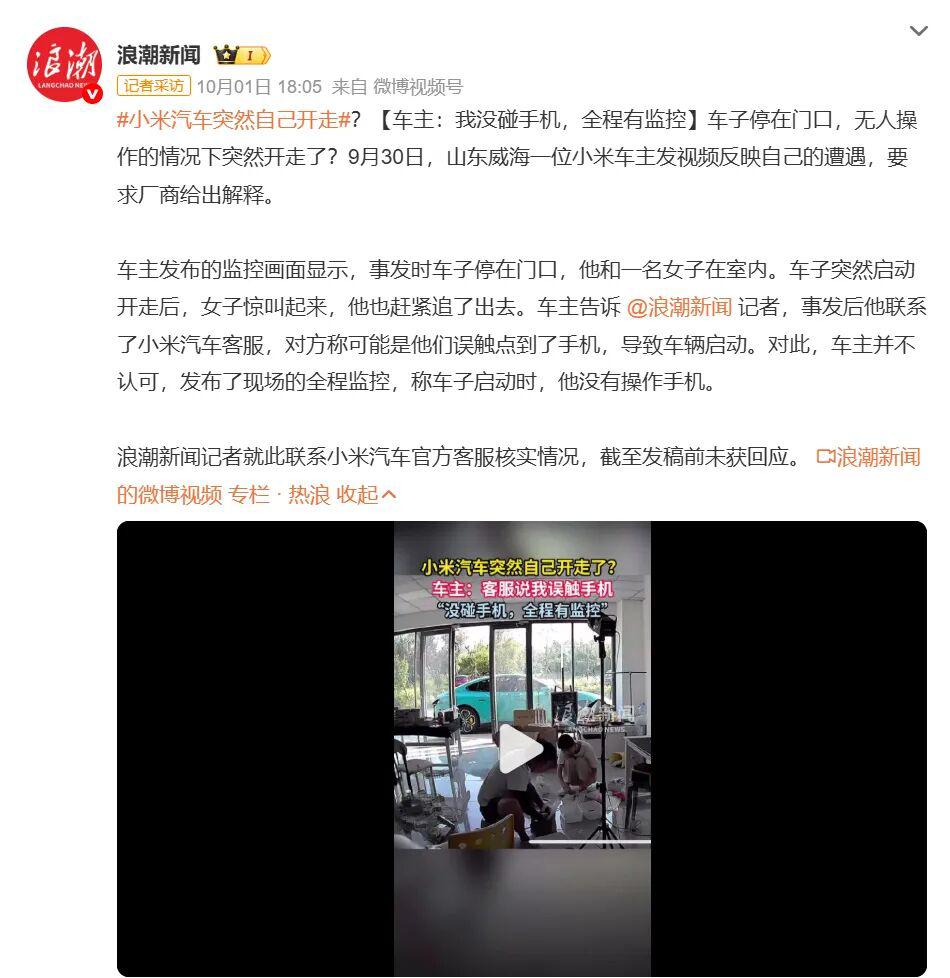
9月30日,山东威海一段监控视频让小米汽车再次成为舆论焦点。据浪潮新闻报道,一位车主发布视频称,其停放在店门口的小米汽车在无人操作的情况下突然自行启动并驶离原位,全程未触碰手机钥匙,车内也无驾驶人员。事件发生后,“小米汽车突然自己开走”迅速登上热搜榜单。截至发稿,该话题阅读量已超9600万。根据车主提供的监控画面显示,事发时车辆正停靠于店铺门前,车主与同伴在室内活动。突然,车辆自行启动,缓慢转向并沿道路前行。视频中清晰记录下同伴的惊呼声,以及车主急忙冲出追车的画面。幸运的是,车辆行驶约十余米后自
CUDA可加速C++中的ML算法,提供更快的训练时间、更高的精度和可扩展性。具体步骤包括:定义数据结构和内核、初始化数据和模型、分配GPU内存、将数据复制到GPU、创建CUDA上下文和流、训练模型、将模型复制回主机、清理。
Java框架常见问题及解决方法:性能问题:使用分析工具找出瓶颈,优化数据库查询,使用缓存和并发技术。安全漏洞:使用安全编码实践,定期扫描漏洞,应用安全更新,使用Web应用程序防火墙。依赖性问题:使用依赖项管理工具,指定确切版本,使用依赖项范围限制可见性。测试问题:实现单元和集成测试,模拟依赖项,使用持续集成工具自动执行测试。
苹果紧急撤回iOS18.4Beta1及watchOS11.4Beta1更新!据MacRumors报道,苹果公司已撤回上周发布的iOS18.4Beta1开发者测试版,原因是该版本存在严重问题,导致部分设备无法正常启动,陷入无限重启循环。受影响的机型包括iPhone12mini、iPhone12、iPhone12Pro、iPhone12ProMax以及部分老款iPadAir和入门级iPad。尤其是一些蜂窝网络版的iPadAir,似乎还出现了其他未知问题。苹果公

MySQL是一个常用的开源关系型数据库管理系统,许多应用程序和网站都使用MySQL作为其后端数据库。然而,有时当我们尝试连接到MySQL时,可能会遇到错误1045。错误1045意味着访问被拒绝,这通常是由于提供的用户名或密码不正确引起的。当我们在连接MySQL数据库时首次设置密码时,我们可能会遇到此错误。为解决这个问题,我们可以采取以下几个步骤:确认用户名和
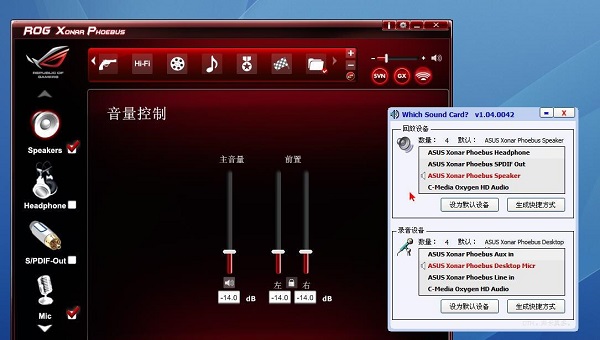
声卡驱动是电脑中控制和指引声卡的系统程序,它能够帮助我们播放出声音,因此如果声卡驱动有问题,最直观的情况就是在声音方面,会出现没有声音或者声音波动卡顿不正常。声卡驱动有问题会出现什么情况:一、声音错误1、声卡驱动就是为声音服务的,所以最直观的问题就是声音问题。2、不管是电脑没有声音,还是声音卡顿、延迟、有噪音、音量音调不正常都可能与声卡驱动有关。3、所以当我们遇到类似问题的时候,可以重新安装或更新声卡驱动试试看。二、设备管理器感叹号1、如果声音没问题,大部分情况下说明声卡驱动都是正常的。2、但我们也可以尝
解决PHPmb_substr函数不起作用的问题在PHP开发中,我们经常会使用mb_substr函数来对字符串进行截取操作,尤其是在处理中文字符串时更为常见。然而,有时候我们会遇到mb_substr函数不起作用的问题,导致无法正确处理字符串。本文将介绍一些常见的原因及解决方案,并给出具体的代码示例。一、原因分析字符编码不一致:mb_subst
随着互联网的飞速发展和普及,数据规模也越来越大,数据挖掘和机器学习的重要性也越来越受到注重。PHP作为一种流行的Web开发语言,是否能够进行数据挖掘和机器学习呢?本文将讨论PHP中如何进行数据挖掘和机器学习算法的实现。一、什么是数据挖掘和机器学习?在了解如何在PHP中进行数据挖掘和机器学习之前,我们需要先了解这两个概念。数据挖掘是通过对大量数据进行分析、
U盘经常被我们拿来保存资料,但总是有个头疼的问题困扰着我们:在别人电脑上使用过U盘再插回自己电脑的时候都会提示U盘有病毒。这种情况尤其是在办公室或者打印店使用U盘的时候尤为突出。这时候很多小伙伴或许就有疑问了,只不过是在别人电脑上拷贝了一个文件,怎么就会有病毒呢?其实,这种利用局域网络中U盘传播的病毒有很多和一个叫“autorun.ini”的文件有关。Autorun.inf是个嘛玩意?autorun.inf是常见的文件之一,用于在双击磁盘时自动运行指定的文件。然而,近年来,一些人利用autorun.inf





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



