

免费OCR工具推荐:高效识别真香体验
哈喽,大家好,我是爱撸码的开源大叔!经常在网上查询文档资料的朋友一定有过这样的经历:好不容易找到了需要的内容,可是别说下载了,连复制一句话都不给复制的。尤其是PDF文档和图片类资料,就算我们充值下载到本地,很多也无法复制文本,只能手动敲出来。项目中有些场景也需要图片识别,比如识别证件、证照等等。下面分享一款电脑端的OCR文字识别软件——「PaddleOCR」,可以帮助我们解决这一问题。PaddleOCR旨在打造一套丰富、领先、且实用的OCR工具库,助力使用者训练出更好的模型,并应用落地。特性丰富易
哈喽,大家好,我是爱撸码的开源大叔!
经常在网上查询文档资料的朋友一定有过这样的经历:好不容易找到了需要的内容,可是别说下载了,连复制一句话都不给复制的。尤其是 PDF 文档和图片类资料,就算我们充值下载到本地,很多也无法复制文本,只能手动敲出来。
项目中有些场景也需要图片识别,比如识别证件、证照等等。
下面分享一款电脑端的 OCR 文字识别软件——「PaddleOCR」,可以帮助我们解决这一问题。
PaddleOCR旨在打造一套丰富、领先、且实用的OCR工具库,助力使用者训练出更好的模型,并应用落地。
特性丰富易用的OCR相关工具组件半自动数据标注工具PPOCRLabel:支持快速高效的数据标注数据合成工具Style-Text:批量合成大量与目标场景类似的图像支持用户自定义训练,提供丰富的预测推理部署方案支持PIP快速安装使用可运行于Linux、Windows、MacOS等多种系统支持多语言OCR模型支持中英文数字组合识别、竖排文本识别、长文本识别效果展示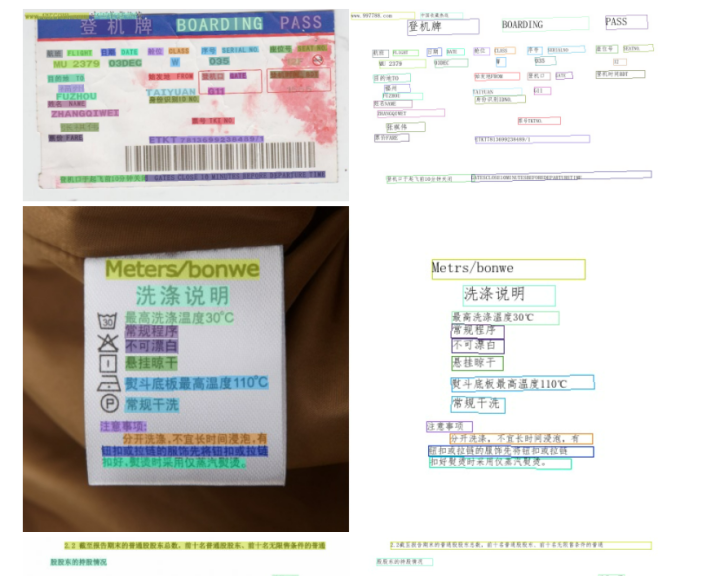
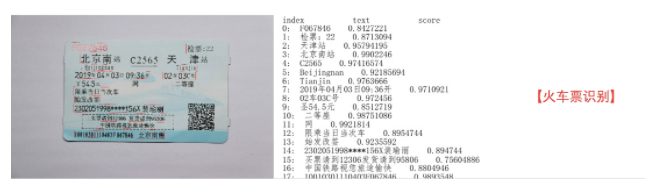
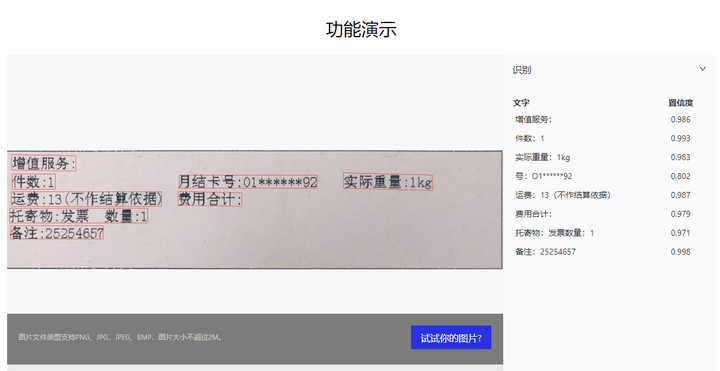
不需要安装任何工具,可以直接在pc端进行图片识别,喜欢pyton的同学,可以按照下面的安装教程部署。
模型简介
模型名称
推荐场景
检测模型
方向分类器
识别模型
中英文超轻量OCR模型(9.4M)
ch_ppocr_mobile_v2.0_xx
移动端&服务器端
推理模型/ 预训练模型]
推理模型 / 预训练模型
推理模型/ 预训练模型
中英文通用OCR模型(143.4M)
ch_ppocr_server_v2.0_xx
服务器端
推理模型/ 预训练模型
推理模型/ 预训练模型
推理模型 / 预训练模型
还有更多模型,这里不全列举了,感兴趣同学可以去官网阅读学习。
通用中英文OCR数据集ICDAR2019-LSVTICDAR2017-RCTW-17中文街景文字识别中文文档文字识别ICDAR2019-ArTPP-OCR PipelinePP-OCR是一个实用的超轻量OCR系统。主要由DB文本检测[2]、检测框矫正和CRNN文本识别三部分组成[7]。该系统从骨干网络选择和调整、预测头部的设计、数据增强、学习率变换策略、正则化参数选择、预训练模型使用以及模型自动裁剪量化8个方面,采用19个有效策略,对各个模块的模型进行效果调优和瘦身,最终得到整体大小为3.5M的超轻量中英文OCR和2.8M的英文数字OCR。
安装教程1、安装python3
代码语言:javascript代码运行次数:0运行复制#下载软件包wget https://www.python.org/ftp/python/3.6.8/Python-3.6.8.tgz#解压tar -zxvf Python-3.6.8.tgzcd Python-3.6.8#编译./configure#安装make make install#创建软连接ln -s /usr/local/python3/bin/python3 /usr/bin/python3#查看版本python3 -V在安装过程中如果出现configure: error: no acceptable C compiler found in $PATH,是缺少合适的编译器
代码语言:javascript代码运行次数:0运行复制sudo yum install gcc-c++出现这个问题zipimport.ZipImportError: can't decompress data; zlib not available,缺少依赖包
代码语言:javascript代码运行次数:0运行复制yum -y install zlib*2、安装PaddlePaddle2.0
代码语言:javascript代码运行次数:0运行复制pip3 install --upgrade pippython3 -m pip install paddlepaddle==2.0.0 -i https://mirror.baidu.com/pypi/simple3、克隆代码
代码语言:javascript代码运行次数:0运行复制git clone https://gitee.com/paddlepaddle/PaddleOCR4、安装PaddleOCR 第三方依赖包
代码语言:javascript代码运行次数:0运行复制cd PaddleOCR#安装第三方依赖项pip3 install -r requirements.txt5、模型下载
代码语言:javascript代码运行次数:0运行复制mkdir inference && cd inference# 下载检测模型并解压wget https://paddleocr.bj.bcebos.com/dygraph_v2.0/ch/ch_ppocr_mobile_v2.0_det_infer.tar&& tar xf ch_ppocr_mobile_v2.0_det_infer.tar# 下载方向分类器模型并解压wget https://paddleocr.bj.bcebos.com/dygraph_v2.0/ch/ch_ppocr_mobile_v2.0_cls_infer.tar && tar xf ch_ppocr_mobile_v2.0_cls_infer.tar#下载文本方向分类器病解压wget https://paddleocr.bj.bcebos.com/dygraph_v2.0/ch/ch_ppocr_mobile_v2.0_rec_infer.tar && tar xf ch_ppocr_mobile_v2.0_rec_infer.tar6、识别图片
代码语言:javascript代码运行次数:0运行复制#识别单张图片python3 tools/infer/predict_system.py --image_dir="992822f810dc3cbbdcca711a1c4b0097.jpg" --det_model_dir="./inference/ch_ppocr_mobile_v2.0_det_infer/" --rec_model_dir="./inference/ch_ppocr_mobile_v2.0_rec_infer/" --cls_model_dir="./inference/ch_ppocr_mobile_v2.0_cls_infer/" --use_angle_cls=True --use_space_char=Trueimage_dir:源文件目录 det_model_dir:识别后存放的文件目录如果报错ModuleNotFoundError: No module named 'cv2',缺少cv2
代码语言:javascript代码运行次数:0运行复制# 安装pip3wget https://pypi.python.org/packages/source/p/pip/pip-18.1.tar.gz# 解压tar -zxvf pip-18.1.tar.gz # 安装cd pip-18.1python3 setup.py buildpython3 setup.py install# 添加到软连接ln -s /usr/local/python3/bin/pip3 /usr/bin/pip3pip install opencv-python如果出现pip is configured with locations that require TLS/SSL, however the..不可用的解决方法
代码语言:javascript代码运行次数:0运行复制yum install openssl-devel -ycd Python-3.6.8./configure --with-sslmakesudo make install在识别图像时候报错的一些解决方案
代码语言:javascript代码运行次数:0运行复制#深度学习pip install paddlepaddle -i https://pypi.tuna.tsinghua.edu.cn/simple# ModuleNotFoundError: No module named 'PIL'pip install pillow# MODULENOTFOUNDERROR: NO MODULE NAMED 'PADDLE'pip install paddlehub==1.6.0 -i https://pypi.tuna.tsinghua.edu.cn/simple#No module named 'imgaug'pip install git+https://github.com/aleju/imgaugps:Paddle-OCR也可以部署在Windows系统中。
代码语言:javascript代码运行次数:0运行复制pip3 install --upgrade pippython3 -m pip install paddlepaddle==2.0.0 -i https://mirror.baidu.com/pypi/simplegit clone https://github.com/PaddlePaddle/PaddleOCR#在PaddleOCR目录下pip3 install -r requirements.txtPaddle-OCR 属于Paddle 框架其中的一个应用,提供了很多好玩的模型,支持多种语言的数据集,关键是提供了轻量级模型,降低了使用难度。
百度网盘OCR功能分为手机、网页和桌面三端:手机端每月仅提供3次免费识别;网页端支持批量识别并可导出文本或Word格式;桌面端支持拖拽操作但需会员权限。各端均受会员等级限制,未开通会员时功能严重受限,免费用户只能享受极有限的次数。
借助捷速OCR软件可将QQ截图文字快速转为可编辑Word文档。操作时先导入截图,使用“纸面解析”功能优化排版识别,再执行识别并检查结果,最后保存为Word即可。整个过程高效便捷,适合经常需要处理图片转文字的用户。
使用OCR软件可将图片文字转为可编辑文档。以捷速OCR为例,导入图片后通过版面分析划定文字区域,执行识别并核对结果,最终保存为Word文档即可自由修改。该方法能有效提升处理图片资料的效率。
捷速OCR软件提取图片文字需遵循清晰步骤。首先启动软件并导入图片,随后使用“纸面解析”功能分析版面。点击“识别”按钮转换文字,并在右侧界面显示结果。用户需对照原图核对并修正文本,最后将准确内容保存为Word文档。按此流程操作即可熟练完成图片转文字任务。
手动从图片提取文字效率低下。捷速OCR软件可快速将图片转为文字,操作步骤包括导入图片、使用纸面解析定位文字区域、进行识别、校对修改,最终保存为可编辑的Word文档,有效提升工作效率。
扫描版PDF文件难以直接编辑,需借助OCR工具。捷速OCR软件可高效完成识别转换。操作包括导入PDF文件、智能解析版面、执行文字识别,最终将结果保存为可编辑的Word文档,便于后续修改与处理。
捷速OCR软件的“画面识别”工具可将图片文字转为可编辑Word文档。操作包括关闭初始窗口、选择“画面识别”、加载文件、进行“纸面解析”以优化布局,随后点击“识别”转换文字。识别后需在编辑区校对内容,确认无误即可保存为Word文档。
捷速OCR软件可将图片文字转为可编辑文本。首先导入图片文件,随后划定识别区域并执行识别,结果将显示在编辑区。最后校对识别文本并保存为Word文档。整个过程操作简便,能高效处理扫描件或截图中的文字信息。
捷速OCR软件支持在识别后调整文档属性。操作时先读取文件,在文档属性区预设输出类型。经纸面解析与识别后,软件分栏显示原图与文本以便核对。随后可在右侧修改字体、字号等格式,最终保存为格式规整的Word文档。整个流程清晰,有助于高效完成文档数字化。
借助捷速OCR软件从图片提取文字,操作简便高效。首先导入图片,使用“纸面解析”分析版式以提升准确率。随后点击“识别”按钮转换文字,结果可编辑并直接保存为Word文档。整个过程清晰直观,能有效满足日常图片转文字需求。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



