

数据库搜索效率提升的Java技术窍门揭秘
数据库搜索效率提升的Java技术窍门揭秘目前,各种数据驱动的应用程序中,数据库起到了至关重要的作用。然而,随着数据量的增加,数据库的搜索效率可能会成为限制应用性能的一大瓶颈。为了提高数据库搜索效率,我们需要借助一些Java技术的窍门。本文将揭秘一些提升数据库搜索效率的技术,并提供具体的代码示例。使用索引数据库索引是提高搜索效率的重要手段之一。在数据库表中创建
数据库搜索效率提升的Java技术窍门揭秘
目前,各种数据驱动的应用程序中,数据库起到了至关重要的作用。然而,随着数据量的增加,数据库的搜索效率可能会成为限制应用性能的一大瓶颈。为了提高数据库搜索效率,我们需要借助一些Java技术的窍门。本文将揭秘一些提升数据库搜索效率的技术,并提供具体的代码示例。
- 使用索引
数据库索引是提高搜索效率的重要手段之一。在数据库表中创建适当的索引,可以加速搜索和排序操作。例如,假设我们有一个名为"users"的表,该表包含了大量的用户记录,其中username是唯一的。我们可以使用如下代码示例为"users"表添加索引:
ALTER TABLE users ADD INDEX idx_username (username);
在进行用户名搜索时,数据库将使用该索引来快速定位匹配的记录,大大提高搜索效率。
- 使用预编译语句
预编译语句是一种将SQL语句预先编译并缓存起来的技术,可以有效减少数据库搜索的时间消耗。相比于每次执行都需要解析和编译SQL语句的方式,使用预编译语句可以直接执行已经编译好的语句,从而节省了编译的时间。下面是一个使用预编译语句查询用户信息的示例:
String sql = "SELECT * FROM users WHERE id = ?";
PreparedStatement pstmt = connection.prepareStatement(sql);
pstmt.setInt(1, userId);
ResultSet rs = pstmt.executeQuery();
while (rs.next()) {
    // 处理查询结果
}
rs.close();
pstmt.close();
在实际使用中,我们可以将经常执行的SQL语句使用预编译的方式进行优化,从而提高数据库搜索效率。
- 优化SQL查询语句
优化SQL查询语句是提高数据库搜索效率的另一个重要方面。合理设计查询条件,避免无用的检索和过滤操作可以显著减少数据库搜索的开销。下面是一些优化SQL查询语句的技巧:
- 选择合适的查询字段:只选择需要的字段,避免返回过多的数据。
- 使用合适的WHERE条件:使用索引字段作为查询条件,并利用索引的特性进行快速定位。
- 使用LIMIT限制查询结果数量:对于大数据量的查询,通过LIMIT只返回需要的结果数量,减少数据库的负载。
- 避免多次查询:尽量使用JOIN等操作一次查询出所需的数据,避免多次查询和数据传输的开销。
- 数据库连接池
在多线程环境下使用数据库连接时,合理使用连接池可以大幅提高数据库搜索效率。连接池可以管理和复用数据库连接,减少频繁连接和断开数据库的开销。下面是一个使用HikariCP连接池的示例:
HikariConfig config = new HikariConfig();
config.setJdbcUrl("jdbc:mysql://localhost:3306/test");
config.setUsername("username");
config.setPassword("password");
HikariDataSource ds = new HikariDataSource(config);
Connection connection = ds.getConnection();
// 执行SQL查询操作
connection.close();
通过使用连接池管理数据库连接,可以避免频繁创建和销毁连接的开销,提高搜索效率。
总结
通过使用索引、预编译语句、优化SQL查询语句和数据库连接池,我们可以提高数据库搜索的效率,优化应用程序的性能。合理选择合适的Java技术,针对具体的需求进行优化,可以有效提升数据库搜索的性能。希望本文提供的窍门和代码示例能帮助读者更好地应对数据库搜索效率的挑战。
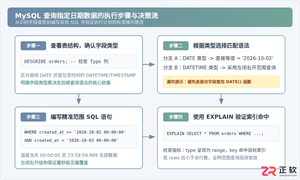
深入讲解在MySQL中查询指定日期数据的SQL编写方法,区分DATE与DATETIME字段类型的差异,详解等值匹配、左闭右开范围查询、DATE()函数利弊、索引效率及常见误区。
EFCore不支持直接添加查询优化提示或强制索引,但可通过FromSqlRaw执行原生SQL实现,如使用WITH(INDEX)或FORCEINDEX;也可通过TagWith标记查询、避免函数导致索引失效、创建适当索引及使用AsNoTracking提升性能。
数据库查询优化需综合索引策略、查询重写、结构设计与系统配置。核心是减少I/O与计算开销,通过EXPLAIN分析执行计划,优先优化慢查询,合理使用索引避免全表扫描,结合分区、缓存、读写分离等高级手段提升性能。
索引优化是提升MySQL查询性能的关键手段,但需合理使用。1.选择合适索引类型:B-Tree适用于范围查询与排序,哈希索引适合等值查询,全文索引用于文本搜索。2.避免索引失效:不要在WHERE子句中使用函数、避免隐式类型转换、避免LIKE以%开头。3.优化SQL语句:避免SELECT*、使用EXPLAIN分析执行计划、优化JOIN语句。4.控制索引数量:过多索引会增加维护成本,降低写入性能。5.监控索引使用情况:通过SHOWINDEX和EXPLAIN了解索引状态和执行效率。
在Golang中使用DynamoDB时,查询超时问题可通过以下方式优化:1.调整SDK配置中的超时时间以适应实际场景;2.优化查询语句,优先使用QueryAPI并避免全表扫描;3.合理设计GSI或LSI索引提升效率;4.使用Limit参数限制返回结果数量;5.对大量数据采用分页查询;6.监控并调整读写容量单位,必要时启用自动伸缩或On-Demand模式;7.复用连接池、控制并发及优化错误处理;8.改善网络环境,如选择就近Region、使用VPCEndpoint等;9.利用CloudWatch、日志和X-R
数据分区查询的核心在于拆分、索引和优化查询逻辑。选择合适的分区策略包括:1.范围分区,适合有连续性字段如时间戳或ID范围的数据;2.哈希分区,适用于数据分布均匀的情况,通过对字段进行哈希运算确定分区;3.列表分区,根据业务规则自定义分区。在PHP中实现需与支持分区的数据库如MySQL、PostgreSQL配合,通过编写SQL语句利用分区功能,例如动态生成按月份分区的表名并执行查询。性能瓶颈包括分区选择不当、索引缺失、查询语句优化不足以及数据库资源限制。优化方案包括:1.选择合适分区键以均匀分布数据并满足查
如何在Python中实现高效缓存?1.使用functools.lru_cache装饰器,通过LRU算法管理缓存,避免重复计算;2.合理设置maxsize参数,根据函数计算成本、调用频率和内存限制调整大小,并可通过cache_info()监控命中率优化配置;3.处理不可哈希参数时,可转换为元组或使用cachetools库自定义键生成方式;4.多线程环境下需确保线程安全,可通过加锁或使用cachetools的线程安全缓存实现。
Python中实现缓存机制的方法有三种:1.使用字典作为缓存,优点是简单易懂,但缺点是缓存大小不受限制且仅适用于纯函数;2.使用functools.lru_cache装饰器,其基于LRU算法管理缓存,使用简单性能好但只能缓存函数输入输出;3.使用第三方缓存库如cachetools、diskcache、redis或memcached,提供更丰富的功能和适用场景。选择策略需根据具体需求判断,若需要缓存大量数据或共享缓存则推荐redis或memcached,否则可选cachetools或lru_cache。
通过结合数据访问层(DAL)和缓存机制,Java应用程序可以优化数据访问性能。DAL可使用DAO和ORM,遵循SoC原则。缓存机制包括Caffeine、Guava和Ehcache。将DAL与缓存集成包括声明数据类型、放入和优先获取缓存数据。实战案例中,使用Caffeine为User实体缓存查找操作,以减少数据库访问次数并提高响应时间。

标题:PHP查询语句优化技巧分享在开发Web应用程序时,优化数据库查询是至关重要的环节,它能够显著提升应用程序的性能和响应速度。在PHP中,通过优化查询语句可以有效地减少数据库负担,提高系统性能。本文将分享一些PHP查询语句优化的技巧和具体的代码示例。1.使用索引在数据库表中适当地创建索引可以加快数据查询的速度。在PHP中,可以通过在查询语句中指定使用的索





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



