

C++快速查找方法与算法对比
C++中实现快速查找的关键在于根据场景选择合适的数据结构和算法。1.哈希表(如std::unordered_map、std::unordered_set)提供平均O(1)时间复杂度的查找,适合不需排序且对速度要求高的场景;2.二叉搜索树(如std::map、std::set)基于红黑树实现,具有O(logn)的查找效率并保持元素有序,适用于需要顺序访问的场景;3.排序数组结合二分查找可实现O(logn)的查找效率,但要求数据预先排序,适合静态或较少更新的数据集;4.线性查找(如std::find)虽然效率
C++中实现快速查找的关键在于根据场景选择合适的数据结构和算法。1. 哈希表(如std::unordered_map、std::unordered_set)提供平均O(1)时间复杂度的查找,适合不需排序且对速度要求高的场景;2. 二叉搜索树(如std::map、std::set)基于红黑树实现,具有O(log n)的查找效率并保持元素有序,适用于需要顺序访问的场景;3. 排序数组结合二分查找可实现O(log n)的查找效率,但要求数据预先排序,适合静态或较少更新的数据集;4. 线性查找(如std::find)虽然效率较低为O(n),但在数据量小或无序数据中实现简单且有效。选择时应综合考虑数据规模、排序状态、查找频率及内存限制,并可通过优化哈希函数、预分配内存、利用缓存等方式进一步提升性能。
C++中实现快速查找,关键在于选择合适的数据结构和算法。不同的场景对性能的要求不同,因此没有一种“万能”的快速查找方案。理解各种查找算法的优缺点,并根据实际情况进行选择,是提高查找效率的关键。
解决方案
C++实现快速查找的核心在于选择合适的数据结构和算法。以下是一些常用的方法:
基于哈希表的查找:
std::unordered_map和std::unordered_set哈希表提供平均常数时间复杂度的查找,插入和删除操作。这是最快的查找方式之一,但它依赖于良好的哈希函数来避免冲突。
#include
#include int main() { std::unordered_map 哈希表在查找、插入和删除操作上具有很高的效率,但它不保证元素的顺序。
基于二叉搜索树的查找:
std::map和std::setstd::map和std::set基于红黑树实现,提供对数时间复杂度的查找,插入和删除操作。与哈希表相比,二叉搜索树保持元素的排序,这在某些场景下非常有用。#include
#include 二叉搜索树的查找效率不如哈希表,但它保持了元素的有序性,并且在最坏情况下的性能也比哈希表稳定。
基于排序数组的二分查找
如果数据已经排序,可以使用二分查找算法。二分查找提供对数时间复杂度的查找,但需要先对数据进行排序。
#include
#include #include int binarySearch(const std::vector & arr, int target) { int left = 0; int right = arr.size() - 1; while (left <= right) { int mid = left + (right - left) / 2; // 防止溢出 if (arr[mid] == target) { return mid; // 找到目标,返回索引 } else if (arr[mid] < target) { left = mid + 1; // 目标在右半部分 } else { right = mid - 1; // 目标在左半部分 } } return -1; // 没有找到目标 } int main() { std::vector arr = {2, 5, 7, 8, 11, 12}; int target = 13; int result = binarySearch(arr, target); if (result == -1) std::cout << "Element is not found in the array"; else std::cout << "Element is found at index " << result; return 0; } 二分查找的效率很高,但前提是数据必须已经排序。如果数据需要频繁插入和删除,那么维护排序数组的成本可能会很高。
线性查找
线性查找是最简单的查找算法,它逐个比较数组中的元素,直到找到目标元素或搜索完整个数组。
#include
#include int linearSearch(const std::vector & arr, int target) { for (size_t i = 0; i < arr.size(); ++i) { if (arr[i] == target) { return i; // 找到目标,返回索引 } } return -1; // 没有找到目标 } int main() { std::vector arr = {2, 5, 7, 8, 11, 12}; int target = 13; int result = linearSearch(arr, target); if (result == -1) std::cout << "Element is not found in the array"; else std::cout << "Element is found at index " << result; return 0; } 线性查找的效率最低,但在数据量较小或者数据无序的情况下,它可能是最简单的选择。
如何选择合适的查找算法?
选择合适的查找算法取决于多个因素,包括数据量、数据的排序状态、查找频率以及对内存使用的要求。
- 数据量:对于小规模数据,线性查找可能足够快,且实现简单。对于大规模数据,哈希表或二叉搜索树通常是更好的选择。
- 数据的排序状态:如果数据已经排序,二分查找是一个非常高效的选择。如果数据无序,则需要考虑哈希表或先排序再进行二分查找。
- 查找频率:如果需要频繁进行查找操作,哈希表或二叉搜索树可以提供更好的性能。如果查找操作较少,则线性查找可能更简单。
- 内存使用:哈希表通常需要更多的内存来存储哈希表本身和处理冲突。二叉搜索树的内存使用相对较少。
如何优化C++中的查找性能?
优化C++中的查找性能可以从多个方面入手:
- 选择合适的数据结构和算法:这是最重要的一步。根据数据的特点和应用场景选择最适合的数据结构和算法。
- 优化哈希函数:如果使用哈希表,确保使用一个良好的哈希函数,以减少冲突。
- 预分配内存:如果知道数据量的大小,可以预先分配内存,以避免动态内存分配的开销。
- 使用缓存:如果查找的数据具有局部性,可以使用缓存来提高查找速度。
- 并行查找:对于大规模数据,可以使用并行查找来提高查找效率。
C++标准库中查找算法的性能对比
C++标准库提供了多种查找算法,它们的性能各不相同。
std::find:线性查找,时间复杂度为O(n)。std::binary_search:二分查找,时间复杂度为O(log n),但需要数据已经排序。std::unordered_map::find和std::unordered_set::find:哈希表查找,平均时间复杂度为O(1),最坏情况为O(n)。std::map::find和std::set::find:二叉搜索树查找,时间复杂度为O(log n)。
选择合适的查找算法取决于具体的需求。如果需要快速查找且不关心数据的顺序,哈希表是最佳选择。如果需要保持数据的顺序且查找频率较高,二叉搜索树可能更适合。如果数据已经排序,二分查找是一个非常高效的选择。
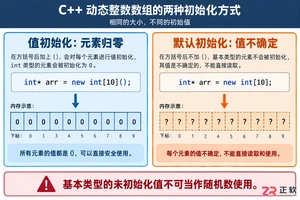
深入解析C++中动态数组的初始化机制,涵盖new操作符的不同用法、基本类型与类对象的初始化差异,以及为何在现代C++开发中应优先使用std::vector。
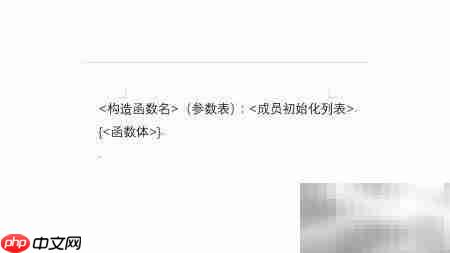
C++类构造与析构函数详解 C++这门语言,可以说是从C语言这棵大树上衍生出的高级果实,如今的应用普及度有目共睹。作为一种静态类型的通用编程语言,它厉害的地方在于融合了多种编程哲学——无论是传统的面向过程,还是主流的面向对象,乃至数据抽象、泛型编程这些高级概念,它都能很好地支持。正因为这份卓越的扩展
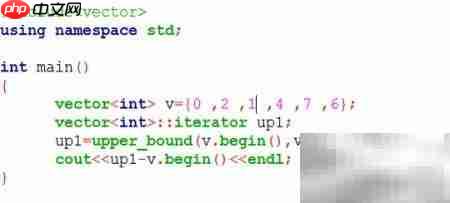
C++中std::upper_bound用法解析 在C++标准模板库(STL)的算法工具箱里,upper_bound() 绝对算得上是一把精准的“探针”。它的核心任务很明确:在一个已经排好序的区间 [first, last) 内,帮你快速定位到第一个**严格大于**指定值 value 的那个元素。这
C++中“常”概念全景解析:从对象、成员到指针与引用 在C++的世界里,“常量性”是一个强大的保障机制。它不仅仅是一个const关键字那么简单,而是构建健壮、安全程序的重要基石。今天,我们就来系统梳理一下围绕“常”的一系列概念:常成员、常对象、常指针与常引用。理解它们,是写出高质量C++代码的关键一
直接用SQLiteCAPI绑定结构体需要手动处理字段展平与顺序对齐,ORM库虽省代码但存在隐式行为风险。小项目建议原生绑定,中大型项目可搭配编译期校验使用轻量ORM。绑定std::string需传指针与长度,注意生命周期;浮点字段比较需设误差范围。
编程是编写程序指令,让设备按意图运行,常用Python、C等语言或Scratch图形化编程。学习编程能跟上科技时代,锻炼自学与解决问题能力,提升逻辑思维,代表行动力,推动事物前进。各司其职,编程者尽本分。
编程被争论是否为艺术。从定义看,编程是技能表达,但并非所有编程都是应用开发。写代码如音乐、文章,有独特风格。好代码需耐心与逻辑能力。编程是艺术,但应用开发不等同于编程艺术。
解决编程问题后的痛快、完成作品的成就感、获取知识的满足感,以及用代码实现简化生活的惊喜与踏实,这些是编程独有的乐趣,只有真正写代码的人才能体会其中的酸甜苦辣、惊喜与满足,令人回味无穷。
Scratch图形化编程以拖拽积木块方式启蒙少儿编程思维,无需记忆代码语法。通过素材库、即时反馈和社区协作,帮助孩子在创作中理解顺序执行、条件判断等核心概念,锻炼逻辑、创造力和问题解决能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



