

文字语义理解技术中的多义词消歧问题
文字语义理解技术中的多义词消歧问题概述在自然语言处理中,多义词消歧是一个重要的问题,指的是根据上下文的语义信息来确定一个多义词的具体含义。由于同一个词汇在不同的上下文中可能有不同的含义,处理多义词消歧问题对于准确理解自然语言文本至关重要。本文将介绍多义词消歧的概念、挑战以及一些常用的解决方法,并提供具体的代码示例来说明这些方法的实际应用。多义词消歧的挑战多义
文字语义理解技术中的多义词消歧问题
概述
在自然语言处理中,多义词消歧是一个重要的问题,指的是根据上下文的语义信息来确定一个多义词的具体含义。由于同一个词汇在不同的上下文中可能有不同的含义,处理多义词消歧问题对于准确理解自然语言文本至关重要。本文将介绍多义词消歧的概念、挑战以及一些常用的解决方法,并提供具体的代码示例来说明这些方法的实际应用。
多义词消歧的挑战
多义词消歧是一个具有挑战性的问题,主要由以下因素引起:
- 上下文信息:多义词的含义通常依赖于上下文的语义信息。因此,为了准确消歧,需要考虑词汇周围的语境,并利用上下文信息来确定具体的含义。
- 歧义数量:某些词汇可能有多个不同的含义,因此消歧的难度会随着歧义数量的增加而增加。
- 数据稀缺性:训练一个准确的多义词消歧模型通常需要大量的标注数据,然而,标注数据的获取成本很高,而且涵盖了所有可能的语境非常困难,这导致了数据稀缺性的问题。
解决方法及代码示例
下面将介绍一些常用的多义词消歧方法,并提供相应的代码示例。
- 基于词典的方法
基于词典的方法是最直接和简单的方法之一,它通过查找词典中的词义来进行消歧。以下是一个基于WordNet词典的代码示例:
from nltk.corpus import wordnet

def wordnet_disambiguation(word, context):
    synsets = wordnet.synsets(word)
    best_synset = None
    max_similarity = -1

    for synset in synsets:
        for lemma in synset.lemmas():
            for cx in lemma.contexts():
                similarity = context_similarity(context, cx)
                if similarity > max_similarity:
                    max_similarity = similarity
                    best_synset = synset

    return best_synset

def context_similarity(context1, context2):
    # 计算两个语境的相似度
pass- 基于统计的方法
基于统计的方法利用大规模语料库中的统计信息来进行多义词消歧。以下是一个基于词向量的代码示例:
from gensim.models import Word2Vec

def word_embedding_disambiguation(word, context, model):
    embeddings = model[word]
    best_embedding = None
    max_similarity = -1

    for embedding in embeddings:
        similarity = context_similarity(context, embedding)
        if similarity > max_similarity:
            max_similarity = similarity
            best_embedding = embedding

    return best_embedding

def context_similarity(context, embedding):
    # 计算语境与词向量的相似度
pass- 基于机器学习的方法
基于机器学习的方法利用已标注的训练数据训练一个分类模型来进行多义词消歧。以下是一个基于支持向量机的代码示例:
from sklearn.svm import SVC
from sklearn.feature_extraction.text import TfidfVectorizer

def svm_disambiguation(word, context, labels, vectorizer):
    X = vectorizer.transform(context)
    clf = SVC(kernel='linear')
    clf.fit(X, labels)
    prediction = clf.predict(X)

    return prediction

def build_tfidf_vectorizer(context):
    vectorizer = TfidfVectorizer()
    vectorizer.fit_transform(context)

    return vectorizer
总结
多义词消歧是自然语言处理中一个重要且有挑战性的问题。本文介绍了多义词消歧问题的挑战,并提供了一些常用的解决方法。这些方法包括基于词典、基于统计以及基于机器学习的方法,并提供了相应的代码示例来说明它们的应用。在实际应用中,可以根据具体需求选择适合的方法来解决多义词消歧问题。

PHP是一种广泛应用于网络开发的编程语言,其内置函数库极其丰富,Brackets函数就是其中的一员。Brackets函数属于字符串处理函数,其作用是将字符串中的方括号去掉或替换成其他字符。本文将详细介绍Brackets函数的用法及注意事项。一、Brackets函数的基本用法Brackets函数的语法结构如下:stringbrackets(string$s
如何获得Java架构师证书?摘要:Java架构师是在Java开发领域具有丰富经验和高级技能的人员。获得Java架构师证书可以向雇主证明你在Java技术方面的专业能力和领导能力。本文将介绍如何获得Java架构师证书的过程和建议。引言:Java是一种广泛使用的编程语言,被用于构建各种应用程序和系统。Java架构师是在Java开发领域扮演重要角色的专业人士。他们负
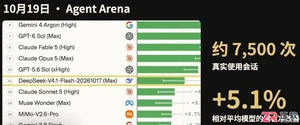
了解DeepSeek V4.1 Flash 1017的Agent Arena指标、约0.20美元任务成本中位数,以及Terminal-Bench 4.0和ProgramBench成绩变化与适用边界。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
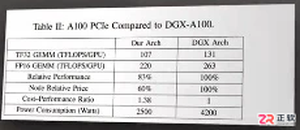
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
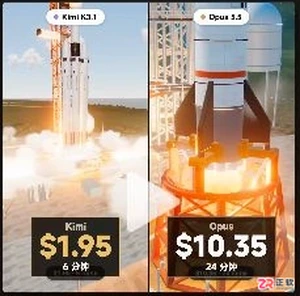
了解 Kimi K3.1 Pro 案例费用、SKY-001 零件构建耗时和 Mercury 3 测试表的限定条件,查看经核实的官方产品说明入口。
想了解Laper AI的真实工资待遇?本文教你如何通过多渠道交叉验证岗位薪资,识别招聘话术中的水分,获取更准确的收入预期参考。
解析字节旗下豆包App、火山引擎、Seedance、TRAE及飞书的定位差异。通过官方文档核对云服务、视频模型、编程工具与办公AI的功能边界,帮助读者准确选择适合的产品入口。
认识AI Agent、Genie 4与机器人的区别:任务输入不等于完成结果,世界模拟不等于现实执行,装载机动作展示也不能替代完整工程验收。
想了解Claude怎么收费?本文梳理了Claude Free、Pro及Team版的最新月费价格、消息限额与高级功能权益,并对比了不同层级的性价比,助你快速找到适合的AI办公伙伴。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



