

EMNLP'22 | ClidSum跨语言对话摘要解析
Windows 11 是微软全新操作系统,现代化界面,流畅操作体验,适用于学习、工作与日常生活。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。
©作者|王佳安学校|苏州大学硕士生研究方向|文本生成排版|PaperWeekly点击这里进群—>加入NLP交流群和求职群研究背景跨语言摘要(Cross-LingualSummarization)旨在为一种语言的文档生成另一种语言的摘要。目前已有的跨语言摘要研究主要关注在新闻报道[1,2],生活指南[3]以及百科文章[4]上,缺乏针对于对话文档的研究。不同于其他文档,对话文档记录了由多名参与者所提供的结构化对话信息,有着信息分散、话题转移频率高等特点。为了推进针对于对话文档的跨语
©作者 | 王佳安
学校 | 苏州大学硕士生
研究方向 | 文本生成
排版 | PaperWeekly
点击这里进群—>加入NLP交流群和求职群

研究背景
跨语言摘要(Cross-Lingual Summarization)旨在为一种语言的文档生成另一种语言的摘要。目前已有的跨语言摘要研究主要关注在新闻报道 [1,2],生活指南 [3] 以及百科文章 [4] 上,缺乏针对于对话文档的研究。不同于其他文档,对话文档记录了由多名参与者所提供的结构化对话信息,有着信息分散、话题转移频率高等特点。
为了推进针对于对话文档的跨语言摘要研究,我们与微信模式识别中心展开合作,共同提出了跨语言对话摘要任务并构建了第一个大规模的跨语言对话摘要基准数据集 ClidSum。在此基础上,我们制定了不同的预训练策略来提升已有多语言预训练模型(即 mBART-50)在跨语言对话摘要上的适应力,并提出了 mDialBART 跨语言对话摘要预训练模型。目前该工作已被 EMNLP 2022 主会接收。相关链接如下:

论文标题:
ClidSum: A Benchmark Dataset for Cross-Lingual Dialogue Summarization
论文链接:
https://arxiv.org/abs/2202.05599
代码链接:
https://github.com/krystalan/ClidSum

ClidSum构建流程
2.1 构建思路
以往的跨语言摘要数据集主要通过两种方式构建:1)将单语摘要数据集中的摘要部分从源语言翻译至目标语言,这样原始文档与翻译后的摘要便可构成跨语言摘要样本;2)从多语言网站上直接收集跨语言摘要对,例如在维基百科中,将某一词条的主体部分当作源语言文档,并将该词条在其余语言版本中的首段当作目标语言摘要。
通过调研,我们发现目前没有公开的网络资源提供多语言对话数据,因此我们采用方法(1)来构建跨语言对话摘要数据集,即选择已有的单语对话摘要数据集,并翻译其中的摘要部分。
2.2 数据选择
在比较了已有的单语对话摘要数据集 [5] 后,我们选择了 SAMSum 数据集 [6] 以及 MediaSum 数据集 [7]。SAMSum 和 MediaSum 有着较高的质量,包含了真实世界中或人工标注的单语言对话-摘要对,涉及到人们生活的多种场景。这两个数据集也在近几年的单语对话摘要研究中也备受关注 [5]。

▲ 图1 SAMSum(左)与MediaSum(右)单语摘要数据集中的样例
2.3 标注过程
在确定单语对话摘要数据集之后,我们采用人工翻译的方式将 SAMSum 的全部摘要(约16K)以及 MediaSum 的部分摘要(40K)从英文分别翻译至汉语与德语。
在翻译过程中,我们采用了严格的质量控制流程,所有英汉译员均通过了英文专八(TEM-8)的资格认定,所有英德译员均通过了英文专八(TEM-8)与德语专八(PGH)的资格认定。除此之外,还有数据审查人员与数据专家对翻译结果进行抽查与评定,确保所得到的汉语/德语摘要的质量。
我们将翻译后的 SAMSum 数据集称为 XSAMSum,将 MediaSum 被翻译的部分称为 XMediaSum40k,没翻译的部分称为 MediaSum424k。
2.4 数据统计

▲ 表1 先前跨语言摘要数据集与ClidSum数据集的统计对比
如上表所示,ClidSum 一共包含了约 56K 英中跨语言对话摘要对,以及 56K 英德跨语言对话摘要对。其中约 16K 来自 SAMSum,40K 来自 MediaSum。此外,SAMSum 的文档平均长度为 83.9,而 MediaSum 则长达上千单词。因此,ClidSum 对短文本与长文本均有涉及。

mDialBART预训练模型
3.1 动机
现有的多语言预训练生成模型(例如 mBART 和 mT5)在预训练阶段仅学习到了底层的语言建模能力,并没有建模跨语言能力以及理解对话文档的能力。为了帮助多语言预训练生成模型更好地完成跨语言对话摘要任务,我们在 mBART 的基础上提出了 mDialBART 预训练生成模型。
3.2 预训练任务

▲ 图2 mDialBART中的四个预训练任务
如上图所示,为了提升模型理解对话文档的能力,我们采用了 action infilling 和 utterance permutation 预训练任务。其中 action infilling 随机掩码了对话文档中的重要信息,并让模型恢复原始对话文档,受启发于 S-BART [8],我们将对话文档中的 who-doing-what 信息视为重要信息。Utterance permutation 打算了一篇对话文档中的 utterance 顺序,并让模型进行恢复。
除此之外,我们还采用了单语对话摘要(monolingual dialogue summarization)任务以及机器翻译(machine translation)任务同时让模型学习摘要和翻译的能力。
3.3 实验结果

▲ 表2 主实验结果
如上表所示,我们在 XMediaSum40k 上对比了 mDialBART 和众多基线模型,发现该预训练生成模型能够更好地用于跨语言对话摘要任务。
3.4 获取模型
我们已将 mDialBART 的模型参数开源在 Huggingface 社区,你可以通过下面的方式进行调用:
代码语言:javascript代码运行次数:0运行复制from transformers import MBartForConditionalGenerationmdialbart_de = MBartForConditionalGeneration.from_pretrained('Krystalan/mdialbart_de')mdialbart_zh = MBartForConditionalGeneration.from_pretrained('Krystalan/mdialbart_zh')
总结
在本文中,我们提出了跨语言对话摘要任务并构建了第一个大规模的跨语言摘要对话基准数据集 ClidSum。在构建过程中,我们采用了人工翻译已有单语对话摘要数据集的方式合成了跨语言对话摘要数据集,并进行了严格的质量控制流程。除此之外,为了让已有多语言预训练生成模型更好地完成该任务,我们在 mBART 的基础上提出了 mDialBART,利用四个预训练任务进一步提升模型理解对话、摘要和翻译的能力。实验结果证明了 mDialBART 的有效性。

参考文献
[1] Junnan Zhu, Qian Wang, Yining Wang, Yu Zhou, Jiajun Zhang, Shaonan Wang, Chengqing Zong. NCLS: Neural Cross-Lingual Summarization. In Prof. EMNLP 2019.
[2] Tahmid Hasan, Abhik Bhattacharjee, Wasi Uddin Ahmad, Yuan-Fang Li, Yong-Bin Kang, Rifat Shahriyar. CrossSum: Beyond English-Centric Cross-Lingual Abstractive Text Summarization for 1500+ Language Pairs. ArXiv preprint, abs/2112.08804.
[3] Faisal Ladhak, Esin Durmus, Claire Cardie, Kathleen McKeown. WikiLingua: A New Benchmark Dataset for Cross-Lingual Abstractive Summarization. In Findings of EMNLP 2020.
[4] Laura Perez-Beltrachini and Mirella Lapata. Models and Datasets for Cross-Lingual Summarisation. In Prof. EMNLP 2021.
[5] Xiachong Feng, Xiaocheng Feng, Bing Qin. A Survey on Dialogue Summarization: Recent Advances and New Frontiers. In Prof. IJCAI 2022 (survey track).
[6] Bogdan Gliwa, Iwona Mochol, Maciej Biesek, Aleksander Wawer. SAMSum Corpus: A Human-annotated Dialogue Dataset for Abstractive Summarization. In Prof. of the 2nd Workshop on New Frontiers in Summarization.
[7] Chenguang Zhu, Yang Liu, Jie Mei, Michael Zeng. MediaSum: A Large-scale Media Interview Dataset for Dialogue Summarization. In Prof. NAACL 2021.
[8] Jiaao Chen and Diyi Yang. Structure-Aware Abstractive Conversation Summarization via Discourse and Action Graphs. In Prof. NAACL 2021.
想下载蛙蛙写作1.4.8版本?本文详解iPhone App Store、Android官网二维码及电脑浏览器端的正确入口,教您如何核对版本号,避开第三方虚假安装包,确保使用官方正版服务。
学习如何在PixPin中精准控制截图尺寸。涵盖自定义区域框选、固定纵横比设置、贴图窗口缩放及长截图区域调整,帮助新手区分像素裁剪与显示缩放,提升截图效率。
学习如何自定义PixPin快捷键。从打开设置面板、识别功能列表到录入新组合键及解决冲突,一步步教你优化截图、长截图和取色操作效率,避免按键冲突。
JM漫画app最新版入口是https://www.jmmanhua.top/,这里有免费观看、离线下载及极简操作优势。针对隐私保护需求,详细解析在设置中通过“隐私设置”与“我收藏的漫画”界面实现内容完全隐藏的具体步骤。同时解答新手关于操作流程、离线功能及适用性的常见疑问,帮助用户快速上手并享受无广告干扰的阅读体验。
面向希望获取丰富漫画资源并实现离线阅读的移动端用户,漫蛙3Manwa3(https://www.manwamh.top/)提供快速更新与多设备支持。针对网络不稳定或流量受限痛点,本文详解官方正版下载后的核心操作:包括通过详情页批量缓存章节、利用关键词与榜单精准检索韩漫、切换横竖屏及夜间模式优化体验,以及账号登录实现跨安卓设备进度同步,帮助用户高效管理本地资源库。
面向二次元漫画爱好者,漫蛙漫画(https://www.manwamh.top/)提供丰富的全彩漫画资源及多国语言阅读支持。针对用户寻找稳定入口、高效检索及舒适阅读的需求,本文介绍漫蛙漫画的线路选择、防走失网址收藏方法,详解从“最近更新”查找韩漫、一键搜索到离线下载的操作流程,并涵盖日间/夜间模式切换、书架管理等新手必备技巧,帮助用户快速上手享受流畅的追漫体验。
漫蛙Manwa3 APP最新版下载地址:https://www.manwamh.top/,这里包含核心功能与操作流程。针对账号注册、VIP开通及阅读设置等关键环节,本文详细梳理了从手机号注册登录、浏览热门榜单到开启高清无广告阅读的具体步骤。涵盖多语言切换、云同步、断点续传及多种阅读模式调整方法,帮助用户快速掌握软件用法,享受流畅的追漫体验。
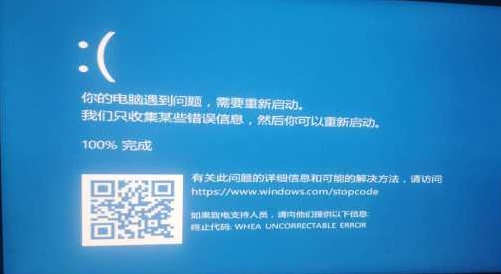
win10操作系统下运行3DMAX总是出现自动重启电脑的问题要怎么办,一般就是检测电源供电、硬件等问题即可,那么下面我们一起看看win10运行3DMAX自动重启解决方法。win10系统运行3DMAX自动重启:1、检测电源供电稳定,是否使用了电脑合适的电源大小。2、如果是新升级、添加硬件后出问题,拆除后试试。3、将电脑设置为——干净启动模式,启动电脑——全盘杀毒再尝试。4、如果以上调试无效,您可以报修或者联系就近服务站调试检修。5、如果你的CUP有16个线程将它变为14个线程尝试打开3DMAX。
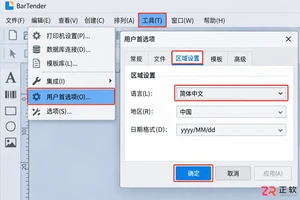
详解BarTender桌面版从英文界面切换至中文的操作步骤,包括用户首选项中的语言设置入口。随后依次介绍主菜单、工具栏、设计画布、工具箱及视图切换,帮助初学者快速建立软件整体地图,理清模板设计与数据源的关系。
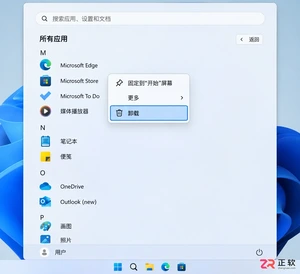
想在 Windows 11 中干净地卸载软件?本教程详解通过开始菜单、系统设置及控制面板移除应用的步骤,涵盖卸载失败处理与残留检查,避免直接删除文件夹带来的隐患。




IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,


