

韩语罗马化转换方法详解
本教程详细介绍了如何在Python环境中,特别是结合PandasDataFrame,实现韩语字符的罗马化转换。文章通过引入korean-romanizer和hangul-romanize两个主流库,提供了详细的安装、使用示例以及如何将这些转换功能应用于DataFrame列的实际操作,旨在帮助开发者高效处理包含韩语数据的场景。

在数据处理和国际化应用中,经常会遇到需要将非拉丁语系文字(如韩语、日语、中文等)转换为拉丁字母形式(即罗马化)的需求。这对于搜索、排序、显示兼容性或与不支持特定字符集的系统交互至关重要。本教程将专注于如何在Python中使用Pandas DataFrame高效地实现韩语字符的罗马化转换。
韩语罗马化处理库介绍
Python生态系统提供了多个用于韩语罗马化的库。其中,korean-romanizer和hangul-romanize是两个功能强大且易于使用的选择。它们能够将韩文字符串转换为对应的罗马拼音形式。
1. 使用 korean-romanizer
korean-romanizer是一个简洁的库,专注于韩语的罗马化转换。
安装: 您可以通过pip安装此库:
pip install korean-romanizer
基本用法示例: 以下是如何使用korean-romanizer将单个韩语字符串进行罗马化转换的示例:
from korean_romanizer.romanizer import Romanizer

# 待转换的韩语字符串
korean_text = "코리아서버호스팅"

# 创建Romanizer实例并进行转换
romanizer = Romanizer(korean_text)
romanized_text = romanizer.romanize()

print(f"原始韩语: {korean_text}")
print(f"罗马化结果: {romanized_text}")
输出:
原始韩语: 코리아서버호스팅
罗马化结果: koliaseobeohoseuting
2. 使用 hangul-romanize
hangul-romanize是另一个功能丰富的库,它提供了不同的罗马化规则,例如学术规则(Academic Rule)。
安装: 您可以通过pip安装此库:
pip install hangul-romanize
基本用法示例: 以下是如何使用hangul-romanize将单个韩语字符串进行罗马化转换的示例,并指定使用学术规则:
from hangul_romanize import Transliter
from hangul_romanize.rule import academic

# 创建Transliter实例,并指定罗马化规则
transliter = Transliter(academic)

# 待转换的韩语字符串
korean_text = "코리아서버호스팅"

# 进行转换
romanized_text = transliter.translit(korean_text)

print(f"原始韩语: {korean_text}")
print(f"罗马化结果: {romanized_text}")
输出:
原始韩语: 코리아서버호스팅
罗马化结果: koliaseobeohoseuting
注意事项: hangul-romanize允许选择不同的罗马化规则,这在某些特定应用场景下非常有用,例如需要符合官方或学术标准的转换。
在Pandas DataFrame中应用罗马化转换
在实际数据处理中,我们通常需要对Pandas DataFrame中的某一列或多列进行批量罗马化转换。Pandas的apply()方法是实现这一目标的最佳选择。
示例数据准备: 首先,创建一个包含韩语数据的Pandas DataFrame:
import pandas as pd

data = {
    'ID': [1, 2, 3],
    'Product_Name_KR': ['코리아서버호스팅', '서울시청', '제주도'],
    'Description_KR': ['웹 호스팅 서비스', '대한민국 수도', '아름다운 섬']
}
df = pd.DataFrame(data)

print("原始DataFrame:")
print(df)
输出:
原始DataFrame:
   ID Product_Name_KR Description_KR
0   1  코리아서버호스팅    웹 호스팅 서비스
1   2       서울시청    대한민국 수도
2   3         제주도     아름다운 섬
使用 korean-romanizer 进行DataFrame列转换: 我们将定义一个函数来封装罗马化逻辑,然后使用apply()方法将其应用于DataFrame的列。
from korean_romanizer.romanizer import Romanizer

def romanize_korean_korean_romanizer(text):
    """使用korean-romanizer将韩语文本罗马化"""
    if pd.isna(text): # 处理NaN值
        return text
    romanizer = Romanizer(text)
    return romanizer.romanize()

# 对 'Product_Name_KR' 列进行罗马化
df['Product_Name_EN_KR'] = df['Product_Name_KR'].apply(romanize_korean_korean_romanizer)
# 对 'Description_KR' 列进行罗马化
df['Description_EN_KR'] = df['Description_KR'].apply(romanize_korean_korean_romanizer)

print("\n使用 korean-romanizer 转换后的DataFrame:")
print(df)
输出:
使用 korean-romanizer 转换后的DataFrame:
   ID Product_Name_KR Description_KR Product_Name_EN_KR Description_EN_KR
0   1  코리아서버호스팅    웹 호스팅 서비스    koliaseobeohoseuting     web hoseuting seobiseu
1   2       서울시청    대한민국 수도          seoulsicheong           daehanminguk sudo
2   3         제주도     아름다운 섬               jejudo            aleumdaun seom
使用 hangul-romanize 进行DataFrame列转换: 同样,我们可以为hangul-romanize库创建一个封装函数,并将其应用于DataFrame列。
from hangul_romanize import Transliter
from hangul_romanize.rule import academic

# 初始化Transliter,避免在apply中重复创建
transliter_academic = Transliter(academic)

def romanize_korean_hangul_romanize(text):
    """使用hangul-romanize将韩语文本罗马化"""
    if pd.isna(text): # 处理NaN值
        return text
    return transliter_academic.translit(text)

# 创建一个新的DataFrame进行演示,避免与上一个示例混淆
df_hangul = pd.DataFrame(data)

# 对 'Product_Name_KR' 列进行罗马化
df_hangul['Product_Name_EN_HR'] = df_hangul['Product_Name_KR'].apply(romanize_korean_hangul_romanize)
# 对 'Description_KR' 列进行罗马化
df_hangul['Description_EN_HR'] = df_hangul['Description_KR'].apply(romanize_korean_hangul_romanize)

print("\n使用 hangul-romanize 转换后的DataFrame:")
print(df_hangul)
输出:
使用 hangul-romanize 转换后的DataFrame:
   ID Product_Name_KR Description_KR Product_Name_EN_HR Description_EN_HR
0   1  코리아서버호스팅    웹 호스팅 서비스    koliaseobeohoseuting     web hoseuting seobiseu
1   2       서울시청    대한민국 수도          seoulsicheong           daehanminguk sudo
2   3         제주도     아름다운 섬               jejudo            aleumdaun seom
总结与注意事项
- 库选择: korean-romanizer和hangul-romanize都提供了韩语罗马化功能。hangul-romanize的优势在于提供了不同的罗马化规则(如学术规则),这在需要特定标准转换时非常有用。根据您的具体需求选择合适的库。
- Pandas集成: 使用DataFrame.apply()方法是处理Pandas列数据转换的推荐方式。它将自定义函数应用于Series中的每个元素,效率较高。
- 性能考量: 对于非常大的DataFrame,apply()虽然方便,但在某些情况下可能不如向量化操作高效。然而,对于文本处理这种通常无法完全向量化的任务,apply()通常是最佳实践。
- 数据清洗: 在进行罗马化之前,确保您的韩语文本数据是干净的,没有意外的非字符串类型或格式问题。在示例中,我们添加了pd.isna(text)检查以处理可能存在的NaN值。
- 其他亚洲语言: 本教程专注于韩语。对于其他亚洲语言(如日语、中文),您需要寻找专门的罗马化或拼音转换库,例如用于日语的pykakasi或用于中文的pypinyin。
通过本教程,您应该能够熟练地在Python Pandas环境中对韩语数据进行罗马化处理,从而提升数据处理的灵活性和兼容性。
Cursor新增实时语音对话,支持在Agent运行任务时交流并听取进度,覆盖Agents Window、IDE、网页端与iOS,语音通话需登录账号并开启麦克风权限。
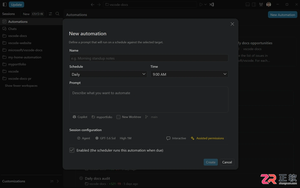
VS Code 1.145新增本地Cron调度,扩展远程Agent预览能力;后续1.145.1与1.145.2修正遥测归属和事件路由。文中区分正式、预览及实验性功能。
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
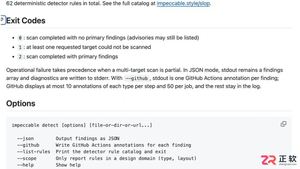
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
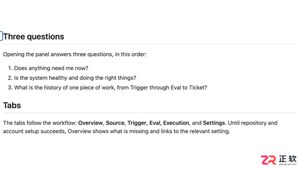
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
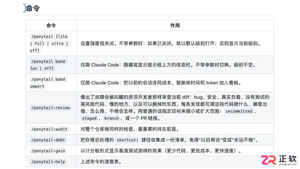
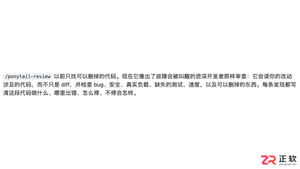
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
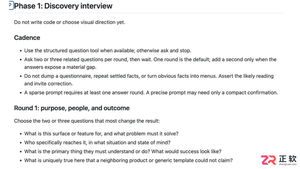
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
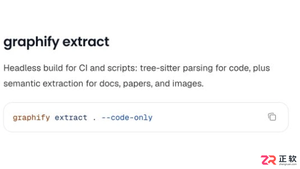
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
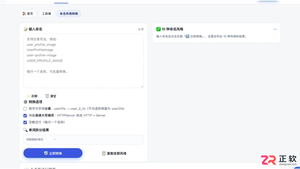
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
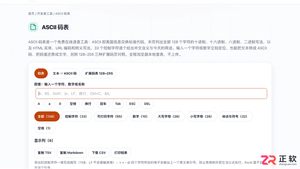
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



