

Jackson必填字段为空时如何阻止序列化
本文详细介绍了如何利用Jackson库的自定义序列化器功能,实现当POJO对象中一个或多个必填字段为null时,阻止整个对象进行序列化的机制。通过扩展JsonSerializer并重写serialize方法,我们可以在序列化前执行自定义校验逻辑,若发现不符合条件的空值,则抛出异常中断序列化过程,从而确保数据完整性。文章还涵盖了两种注册自定义序列化器的方法:基于注解和基于模块的全局注册,并提供了详细的代码示例。
1. 背景与问题分析
在使用Jackson进行JSON序列化时,我们经常遇到需要处理字段空值的情况。Jackson默认的行为是:
- 如果字段值为null,它通常会将其序列化为JSON的null。
- 通过@JsonInclude(JsonInclude.Include.NON_NULL)等注解,我们可以配置Jackson在字段为null时跳过该字段的序列化。
然而,这些方法并不能满足所有场景的需求。有时,我们希望某个POJO对象中的某些字段是“必填”的,如果在序列化时发现这些必填字段为null,我们不希望仅仅是忽略它们或将它们序列化为null,而是希望整个对象的序列化过程都失败,以此来强制数据完整性或提前发现数据问题。
尽管Jackson提供了@JsonProperty(required = true)注解,但此注解主要用于反序列化(deserialization)时校验JSON中是否存在对应的字段,如果缺失则抛出异常。它并不能在序列化(serialization)阶段阻止带有null必填字段的对象被序列化。
为了解决这一问题,我们需要一种机制,能够在对象序列化之前介入,执行自定义的校验逻辑。
2. 解决方案:自定义Jackson序列化器
Jackson提供了强大的扩展能力,允许我们通过自定义序列化器(Custom JsonSerializer)来完全控制对象的序列化过程。核心思想是创建一个继承自JsonSerializer
2.1 创建自定义序列化器
假设我们有一个BigJsonDto类,其中包含多个字段,我们需要确保其中某些字段(例如field1、field2等)在序列化时不能为null。
import com.fasterxml.jackson.core.JsonGenerationException;
import com.fasterxml.jackson.core.JsonGenerator;
import com.fasterxml.jackson.databind.JsonSerializer;
import com.fasterxml.jackson.databind.SerializerProvider;
import java.io.IOException;
import java.util.Objects;
import java.util.function.Predicate;
import java.util.stream.Stream;

// 假设这是我们的数据传输对象
// @Builder 和 @Data 注解来自 Lombok,用于简化POJO创建
// @JsonSerialize 注解将在后续介绍
public class BigJsonDto {
    private String field1;
    private String field2;
    private String field3;
    // ... 其他字段
    private String fieldN;

    // 省略构造函数、getter/setter等Lombok生成的方法
    // 为了演示,我们手动添加一个简单的构造函数
    public BigJsonDto(String field1, String field2, String field3, String fieldN) {
        this.field1 = field1;
        this.field2 = field2;
        this.field3 = field3;
        this.fieldN = fieldN;
    }

    public String getField1() { return field1; }
    public String getField2() { return field2; }
    public String getField3() { return field3; }
    public String getFieldN() { return fieldN; }
}

// 自定义BigJsonDto的序列化器
public class BigJsonDtoSerializer extends JsonSerializer {

    // 定义一个谓词,用于检查BigJsonDto实例是否有效(即必填字段是否为null)
    public static final Predicate IS_NOT_VALID =
        dto -> Stream.of(dto.getField1(), // 添加所有必填字段
                         dto.getField2(),
                         dto.getField3(),
                         dto.getFieldN())
            .anyMatch(Objects::isNull); // 只要有一个为null,则认为无效

    @Override
    public void serialize(BigJsonDto value, JsonGenerator gen,
                          SerializerProvider serializers) throws IOException {

        // 1. 执行校验逻辑
        if (IS_NOT_VALID.test(value)) {
            // 如果对象无效(必填字段为null),则抛出JsonGenerationException,阻止序列化
            throw new JsonGenerationException("BigJsonDto实例无效:存在必填字段为null。", gen);
        }

        // 2. 如果校验通过,则手动执行序列化
        // 注意:这里需要手动将每个字段写入JsonGenerator
        gen.writeStartObject(); // 开始写入JSON对象

        // 写入每个字段
        gen.writeFieldName("field1");
        gen.writeString(value.getField1());

        gen.writeFieldName("field2");
        gen.writeString(value.getField2());

        gen.writeFieldName("field3");
        gen.writeString(value.getField3());

        // ... 依此类推,写入所有需要序列化的字段
        gen.writeFieldName("fieldN");
        gen.writeString(value.getFieldN());

        gen.writeEndObject(); // 结束写入JSON对象
    }

    /**
     * 此方法仅在通过Jackson模块注册序列化器时需要重写。
     * 它告诉Jackson此序列化器处理哪种类型的对象。
     */
    @Override
    public Class handledType() {
        return BigJsonDto.class;
    }
}
代码解析:
- IS_NOT_VALID Predicate: 这是一个静态的Predicate,它接收一个BigJsonDto对象,并使用Java 8的Stream API检查所有指定为“必填”的字段。如果其中任何一个字段的值为null,则该Predicate返回true,表示对象无效。
- serialize() 方法:
- 这是自定义序列化器的核心。Jackson在序列化BigJsonDto实例时会调用此方法。
- 首先,它使用IS_NOT_VALID.test(value)进行校验。
- 如果校验失败(返回true),则立即抛出JsonGenerationException。这个异常会中断当前的序列化操作,并通常向上层调用者抛出,从而达到阻止序列化的目的。
- 如果校验成功,则需要手动将BigJsonDto的各个字段写入到JsonGenerator中。这包括调用gen.writeStartObject()、gen.writeFieldName()、gen.writeString()(或其他write方法,取决于字段类型)以及gen.writeEndObject()。这是一个重要的细节:一旦你接管了serialize()方法,Jackson就不会再自动处理字段序列化,你需要手动完成所有字段的写入。
3. 注册自定义序列化器
创建了自定义序列化器之后,我们需要将其注册到Jackson的ObjectMapper中,以便Jackson知道在序列化BigJsonDto时应该使用我们的自定义逻辑。主要有两种注册方式:
3.1 方式一:通过@JsonSerialize注解
这是最直接的方式,适用于为特定POJO类指定序列化器。
import com.fasterxml.jackson.databind.annotation.JsonSerialize;

@JsonSerialize(using = BigJsonDtoSerializer.class)
public class BigJsonDto {
    private String field1;
    private String field2;
    private String field3;
    private String fieldN;

    // 省略构造函数、getter/setter等
    public BigJsonDto(String field1, String field2, String field3, String fieldN) {
        this.field1 = field1;
        this.field2 = field2;
        this.field3 = field3;
        this.fieldN = fieldN;
    }

    public String getField1() { return field1; }
    public String getField2() { return field2; }
    public String getField3() { return field3; }
    public String getFieldN() { return fieldN; }
}
通过在BigJsonDto类上添加@JsonSerialize(using = BigJsonDtoSerializer.class)注解,Jackson在遇到BigJsonDto类型的对象时,会自动使用BigJsonDtoSerializer进行序列化。在这种方式下,BigJsonDtoSerializer中的handledType()方法不是必需的,但保留它也无害。
3.2 方式二:通过Jackson模块全局注册
这种方式更灵活,特别是当你需要注册多个自定义序列化器,或者希望将序列化器配置集中管理时。它也常用于Spring Boot等框架中,通过将模块注册为Bean来自动配置ObjectMapper。
import com.fasterxml.jackson.core.Version;
import com.fasterxml.jackson.databind.ObjectMapper;
import com.fasterxml.jackson.databind.module.SimpleModule;
import java.util.List;
import java.util.Map;

public class SerializationModuleConfig {

    public static void registerCustomSerializers(ObjectMapper mapper) {
        // 创建一个SimpleModule实例
        SimpleModule mySerializationModule = new SimpleModule(
            "MyCustomSerializationModule", // 模块名称
            new Version(1, 0, 0, null, "com.example", "my-app"), // 模块版本信息
            Map.of(), // 反序列化器列表 (此处不涉及,为空Map)
            List.of(new BigJsonDtoSerializer()) // 序列化器列表,添加我们的自定义序列化器
        );

        // 将模块注册到ObjectMapper
        mapper.registerModule(mySerializationModule);
    }

    // 如果在Spring Boot中使用,可以将其注册为一个Bean
    /*
    @Configuration
    public class JacksonConfig {
        @Bean
        public Module customSerializationModule() {
            SimpleModule module = new SimpleModule(
                "MyCustomSerializationModule",
                new Version(1, 0, 0, null, "com.example", "my-app")
            );
            module.addSerializer(BigJsonDto.class, new BigJsonDtoSerializer());
            return module;
        }
    }
    */
}
说明:
- 创建一个SimpleModule实例,并在构造函数中传入模块名称、版本信息、反序列化器列表和序列化器列表。
- 将BigJsonDtoSerializer实例添加到序列化器列表中。
- 最后,调用ObjectMapper.registerModule(mySerializationModule)将模块注册到ObjectMapper。
- 在这种方式下,BigJsonDtoSerializer中的handledType()方法是必需的,它告诉模块此序列化器负责处理哪种类型。
- 如果使用Spring Boot,可以将SimpleModule作为一个@Bean暴露,Spring Boot会自动将其注册到默认的ObjectMapper中。
4. 使用示例
以下是一个完整的示例,演示了如何使用自定义序列化器来阻止空值必填字段的对象被序列化。
import com.fasterxml.jackson.core.JsonGenerationException;
import com.fasterxml.jackson.databind.ObjectMapper;
import com.fasterxml.jackson.databind.annotation.JsonSerialize; // 如果使用注解方式

public class SerializationDemo {

    // 假设BigJsonDto和BigJsonDtoSerializer如前文所示

    public static void main(String[] args) {
        ObjectMapper mapper = new ObjectMapper();

        // 方式一:如果BigJsonDto类上使用了@JsonSerialize注解
        // ObjectMapper mapper = new ObjectMapper(); // 无需额外配置

        // 方式二:如果使用模块注册方式
        // SerializationModuleConfig.registerCustomSerializers(mapper);

        // 示例1:必填字段为null,预期序列化失败
        System.out.println("--- 示例1:必填字段为null ---");
        BigJsonDto invalidDto = new BigJsonDto(null, "value2", "value3", "valueN");
        try {
            String resultingJson = mapper.writeValueAsString(invalidDto);
            System.out.println("序列化成功 (不应该发生): " + resultingJson);
        } catch (JsonGenerationException e) {
            System.err.println("序列化失败,符合预期:" + e.getMessage());
        } catch (Exception e) {
            System.err.println("发生其他异常:" + e.getMessage());
        }

        System.out.println("\n--- 示例2:所有必填字段都有值 ---");
        // 示例2:所有必填字段都有值,预期序列化成功
        BigJsonDto validDto = new BigJsonDto("value1", "value2", "value3", "valueN");
        try {
            String resultingJson = mapper.writeValueAsString(validDto);
            System.out.println("序列化成功 (符合预期): " + resultingJson);
        } catch (Exception e) {
            System.err.println("序列化失败 (不应该发生):" + e.getMessage());
        }
    }
}
运行结果:
--- 示例1:必填字段为null ---
序列化失败,符合预期:BigJsonDto实例无效:存在必填字段为null。

--- 示例2:所有必填字段都有值 ---
序列化成功 (符合预期): {"field1":"value1","field2":"value2","field3":"value3","fieldN":"valueN"}
从输出可以看出,当invalidDto的field1为null时,mapper.writeValueAsString(invalidDto)抛出了我们自定义的JsonGenerationException,成功阻止了序列化。而validDto则被正常序列化。
5. 注意事项与总结
- 手动序列化所有字段: 自定义serialize()方法后,你需要手动控制所有字段的写入。对于字段较多的POJO,这可能会变得繁琐。确保你没有遗漏任何需要序列化的字段。
- 性能考量: 每次序列化都进行自定义校验和手动字段写入,可能会带来轻微的性能开销。对于性能要求极高的场景,需要权衡利弊。
- 错误信息: 在JsonGenerationException中提供清晰的错误信息非常重要,这有助于调试和问题定位。
- 校验逻辑的复杂性: IS_NOT_VALID谓词可以根据你的业务需求变得更复杂,例如,可以检查字段的长度、格式等,而不仅仅是null。
- 与Spring Boot集成: 如果在Spring Boot项目中使用,推荐通过@Configuration类将SimpleModule作为@Bean暴露,这样可以无缝集成到Spring的ObjectMapper配置中。
通过自定义Jackson序列化器,我们获得了对序列化过程的细粒度控制,能够实现更严格的数据完整性校验,确保只有符合业务规则的对象才能被成功序列化为JSON。这种方法为处理复杂的数据校验场景提供了强大的工具。
WorkBuddy 目前没有面向普通用户的公开 REST API 接口文档,扩展与集成走四条官方路径:接入 MCP 服务扩展工具能力、用连接器打通外部应用(支持公共/个人授权)、编写技能(Skill)与专家包定制工作流、在开放平台发布 Buddy 应用。另支持接入 OpenAI 兼容的自定义模型。本文含 4 张真实界面截图并如实说明现状。
解释Google Workspace MCP 11月11日与12日的agentic OAuth客户端迁移节点,区分普通REST应用、混合客户端、预览资格、用户权限和服务账户、Apps Script边界。
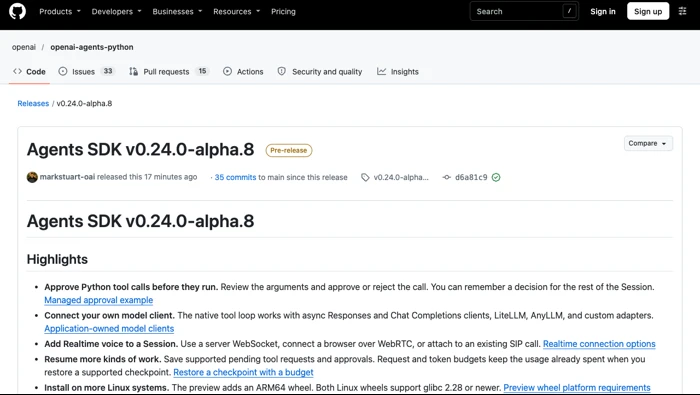
OpenAI Agents SDK v0.24.0-alpha.8预览版新增执行前审批、自有模型客户端、Realtime与预算检查点恢复,说明alpha.7回退、Linux运行及工具认证边界。
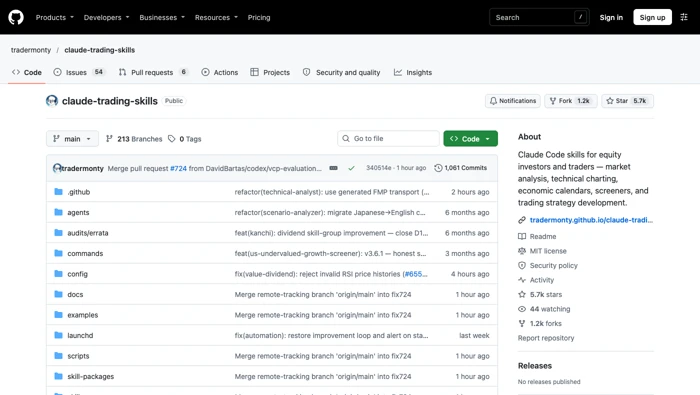
Claude Trading Skills六项技能已修复API密钥异常日志泄漏路径;not_verified保留完整安全审核缺口,离线回归通过不等于实盘验收或全面认证。
解释Microsoft C++ Language Server预览版的MSBuild编译数据库自动提取,区分CMake、自定义构建、有效Copilot订阅和CLI能力,避免把测试预发布版本当最低稳定版。

LibreOffice可通过“工具→宏”创建和运行Basic宏,也支持由Python脚本提供程序运行Python宏。两种方式都可以使用UNO接口操作文档;Excel VBA只有有限兼容支持,不能把所有Excel宏直接复制过来当作LibreOffice原生宏执行。
说明Enterprise GitHub Apps的Copilot席位管理权限,提供第一页只读GET示例,区分total_seats、授权明细、遥测活动和待取消计费条件。
解释GitHub网页仪表盘Feed或Home默认视图、六项列表、自定义选择保留和Agent sessions隐藏条件,区分布局、数据与权限。
核对LangChain三种包版本,解释refusal内容块、ModelRefusalError与中间件传递,提供自定义错误分支示例并区分Python消息流和追踪修复。
区分Anthropic各语言SDK及TypeScript云适配包版本,解释Claude Tag字段、Bedrock/Vertex分号差异、非法路径参数和只读Python版本核对。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



